
Dans le vaste champ de la modélisation statistique appliquée aux sciences humaines, sociales et comportementales, l’analyse de régression linéaire multiple occupe une place prépondérante. Lorsqu’un chercheur tente de comprendre les déterminants complexes d’un phénomène empirique, il se heurte inévitablement à l’interdépendance des facteurs explicatifs. Dans le monde réel, les comportements, les traits psychologiques et les performances cognitives ne se manifestent jamais de manière isolée ; ils s’inscrivent au sein d’un réseau dense de corrélations mutuelles. C’est précisément pour démêler cet écheveau d’influences partagées que le coefficient de régression partielle s’impose comme la pierre angulaire de l’économétrie et de la psychométrie contemporaines.
Le coefficient de régression partielle constitue l’outil fondamental permettant de quantifier l’effet résiduel, direct et marginal d’une variable explicative donnée sur une variable dépendante, après avoir mathématiquement neutralisé, purgé ou « contrôlé » l’influence de l’ensemble des autres covariables intégrées dans le modèle. Loin d’être une simple déclinaison calculatoire de la corrélation bivariée, ce paramètre incarne une démarche épistémologique sophistiquée : il permet d’isoler théoriquement des relations fonctionnelles au sein de structures d’observation non expérimentales. En opérant cette partition rigoureuse de la variance, le statisticien s’approche d’une forme d’expérimentation passive, essentielle lorsque la manipulation directe des variables s’avère matériellement ou éthiquement impossible.
Cet article propose une exploration approfondie, théorique et appliquée du coefficient de régression partielle. En débutant par ses fondements conceptuels, son évolution historique et sa dérivation mathématique matricielle rigoureuse, nous examinerons la portée exacte de la clause ceteris paribus. Nous poursuivrons par l’analyse détaillée d’un exemple empirique issu des sciences de l’éducation, complété par l’interprétation pas à pas des sorties logicielles, l’arbitrage entre métriques brutes et standardisées, ainsi que les défis inhérents à la multicollinéarité et aux paradoxes de suppression statistique. Enfin, un guide méthodologique conforme aux normes académiques internationales viendra clore cette synthèse exhaustive.
1. 1. Introduction fondamentale au coefficient de régression partielle
1.1 Définition conceptuelle et statut épistémologique
Le coefficient de régression partielle représente la variation attendue de la variable réponse (ou variable critère, notée $Y$) pour chaque modification unitaire d’un prédicteur spécifique ($X_j$), sous la condition formelle que l’ensemble des autres prédicteurs inclus dans le modèle linéaire demeure strictement invariant. Sur le plan épistémologique, ce paramètre ne décrit pas une simple co-occurrence statistique brute, mais formalise une tentative d’isoler l’effet marginal direct propre à une dimension explicative. Dans les systèmes multivariés, plusieurs prédicteurs partagent fréquemment des fractions substantielles de variance en raison de leurs interconnexions sous-jacentes. Le coefficient partiel intervient comme un opérateur de purification : il soustrait de la relation entre $X_j$ et $Y$ toute l’information redondante déjà expliquée par les autres covariables du modèle.
Cette particularité analytique établit une distinction épistémologique fondamentale entre l’association bivariée brute et la relation conditionnelle ajustée. Alors que le coefficient de régression simple exprime le changement total observé sur $Y$ sans se préoccuper des canaux indirects ou des variables confondantes associées, le coefficient partiel extrait la composante unique de la relation fonctionnelle. Par ailleurs, sa formulation quantitative préserve la métrique originale des instruments de mesure mobilisés. Si la variable $Y$ est mesurée en points d’examen et le prédicteur $X_j$ en heures d’apprentissage, le coefficient s’exprime rigoureusement en « points par heure », conférant ainsi au résultat une interprétabilité concrète, immédiatement traduisible au niveau des politiques éducatives, cliniques ou managériales.
1.2 Évolution historique du concept dans la modélisation statistique
La genèse du coefficient de régression partielle s’enracine dans les travaux pionniers de Sir Francis Galton à la fin du dix-neuvième siècle. En étudiant les mécanismes de transmission héréditaire de la taille humaine, Galton mit en lumière le phénomène de « régression vers la médiocrité » (régression vers la moyenne), formalisant les prémices de la régression bivariée. Néanmoins, l’incapacité du cadre galtonien à dissocier les influences maternelles, paternelles et environnementales motiva Karl Pearson à conceptualiser mathématiquement le coefficient de corrélation produit-moment et à entrevoir l’extension aux systèmes corrélatifs d’ordre supérieur.
C’est toutefois au statisticien britannique George Udny Yule que l’on doit, entre 1897 et 1907, la formalisation analytique rigoureuse de la régression multiple et des coefficients partiels. Confronté aux déterminants socio-économiques du paupérisme en Angleterre, Yule cherchait à mesurer l’impact direct de la distribution des aides sociales tout en contrôlant l’âge de la population et les conditions économiques locales. Il développa la théorie des moindres carrés appliquée aux systèmes à variables multiples et introduisit les concepts de corrélations d’ordre partiel. Cette avancée marqua le passage historique de la corrélation descriptive naïve vers une estimation explicative robuste par les moindres carrés ordinaires (MCO), posant le socle analytique incontournable qui régit aujourd’hui encore la recherche quantitative en économie, en épidémiologie et en psychométrie.
1.3 Importance théorique dans les sciences du comportement
Dans le domaine des sciences du comportement, l’expérimentation pure en laboratoire avec assignation aléatoire parfaite se heurte souvent à des contraintes pratiques et déontologiques. L’étude de processus cognitifs complexes, de traits de personnalité ou de psychopathologies s’effectue généralement en contexte observationnel ou quasi expérimental. Dans ce cadre, la présence de variables parasites (ou covariables de confusion) menace en permanence la validité interne des inférences. Le coefficient de régression partielle offre une solution méthodologique indispensable en permettant de neutraliser a posteriori les disparités individuelles telles que le niveau socio-économique, l’intelligence fluide de base ou le degré d’anxiété générale lors de l’évaluation d’un traitement thérapeutique ou d’un programme pédagogique.
De surcroît, le coefficient partiel constitue l’instrument privilégié pour établir la validité incrémentale d’un construit psychologique théorisé. Lorsqu’un psychologue affirme qu’une nouvelle échelle de « grit » (persévérance) prédit le succès académique au-delà des facteurs classiques du modèle des Big Five, l’administration d’une régression multiple est requise. Le coefficient partiel associé au grit, s’il demeure statistiquement significatif après introduction de la conscience, de l’extraversion et de l’ouverture, prouve que ce nouveau concept apporte une part explicative inédite non redondante. Enfin, cette modélisation oblige le chercheur à opérer une distinction théorique nette entre un effet de médiation — où la variable intermédiaire transmet l’impact d’une cause initiale — et un simple contrôle d’effets résiduels, évitant ainsi des erreurs majeures d’interprétation causale.
2. 2. Distinction conceptuelle : régression simple versus régression multiple
2.1 La nature du coefficient dans la régression linéaire simple
Dans une analyse de régression linéaire bivariée, le coefficient de régression (souvent désigné par la pente de la droite de régression univariée, $b_{simple}$) mesure la variation attendue de la variable dépendante $Y$ pour une élévation d’une unité de l’unique variable prédictive $X$. D’un point de vue purement géométrique et algébrique, cette pente équivaut au ratio de la covariance entre $X$ et $Y$ sur la variance de $X$, soit $b_{simple} = \frac{\text{Cov}(X,Y)}{\text{Var}(X)}$. Cette formulation implique que le coefficient capture l’intégralité de l’association empirique existant entre les deux entités numériques, sans effectuer la moindre discrimination quant aux sources originelles de cette covariation.
Par conséquent, la régression simple est intrinsèquement vulnérable au biais d’omission de variables fondamentales. Si une tierce variable $Z$ est corrélée simultanément avec $X$ et $Y$, la pente bivariée absorbera mécaniquement l’effet de $Z$, attribuant fallacieusement à $X$ une force ou une nature de relation qui n’est qu’un artefact structurel. Vouloir déduire une relation causale ou même une prédiction opérationnelle fiable à partir d’un coefficient simple expose le chercheur à des extrapolations totalement erronées dès lors que le système générateur de données repose sur des dépendances multifactorielles.
2.2 L’émergence de la partialité dans la régression multiple
L’intégration conjointe de plusieurs prédicteurs au sein d’une équation linéaire transforme profondément la nature mathématique du coefficient estimé. Le coefficient devient « partiel » précisément parce qu’il opère un ajustement simultané pour l’ensemble des covariables concurrentes introduites dans la matrice de modélisation. Ce processus repose sur la partition géométrique de l’espace vectoriel des observations : le modèle identifie et retire la variance partagée entre les prédicteurs pour ne conserver que la variance strictement spécifique à chaque prédicteur dans son association avec la variable dépendante.
Cette partialisation peut induire des modifications spectaculaires par rapport aux estimations univariées initiales. Il est fréquent d’observer une atténuation substantielle du coefficient, démontrant que l’association univariée initiale n’était qu’un mirage alimenté par des facteurs confondants. Plus déstabilisant encore, le signe du coefficient peut s’inverser totalement lors du passage de la régression simple à la régression multiple, illustrant le célèbre paradoxe de Simpson. Inversement, la partialisation possède la propriété de révéler des effets masqués ou des mécanismes de suppression statistique, où un prédicteur semble sans relation avec $Y$ au niveau bivarié ($r \approx 0$), mais affiche un coefficient partiel vigoureux et statistiquement significatif dès lors qu’un autre facteur est contrôlé.
2.3 Tableau comparatif des propriétés statistiques et analytiques
Afin de conceptualiser rigoureusement les mutations analytiques s’opérant lors de la transition d’un modèle simple à un modèle multivarié, il convient d’examiner le comportement de leurs paramètres fondamentaux au sein d’une structure synthétique comparative.
| Propriété Statistique | Régression Linéaire Simple ($Y = \beta_0 + \beta_1 X_1 + \epsilon$) | Régression Linéaire Multiple ($Y = \beta_0 + \sum \beta_j X_j + \epsilon$) |
|---|---|---|
| Formule d’estimation du coefficient | $b_1 = \frac{\text{Cov}(X_1, Y)}{\text{Var}(X_1)}$ | $\mathbf{b} = (\mathbf{X}’\mathbf{X})^{-1}\mathbf{X}’\mathbf{Y}$ (estimation matricielle simultanée) |
| Nature de l’association mesurée | Brute, non ajustée, englobant tous les effets indirects et facteurs de confusion. | Partielle, conditionnelle, épurée des intercorrélations avec les autres prédicteurs. |
| Comportement de l’erreur type | $\text{SE}(b_1) = \frac{s_e}{\sqrt{\sum (X_1 – \bar{X}_1)^2}}$ dépendant uniquement de la variance résiduelle univariée. | $\text{SE}(b_j) = \frac{s_e}{\sqrt{\sum (X_j – \bar{X}_j)^2 (1 – R_j^2)}}$ vulnérable à la multicollinéarité ($VIF_j$). |
| Interprétation des seuils de significativité | Évalue si la droite bivariée s’écarte d’une horizontale plane ($H_0 : \beta_1 = 0$). | Évalue la contribution incrémentale unique du prédicteur spécifique au-delà des autres ($H_0 : \beta_j = 0$). |
| Coefficient de détermination | $R^2 = r_{X_1, Y}^2$ (carré direct de la corrélation de Pearson). | $R^2 ge \max(r_{X_j, Y}^2)$ représentant la variance totale expliquée par l’ensemble du système de prédicteurs. |
3. 3. Fondements mathématiques et dérivation matricielle
3.1 Formulation algébrique du modèle de régression linéaire multiple
L’expression algébrique d’un modèle de régression linéaire multiple reliant une variable dépendante quantitative continue $Y$ à un ensemble ordonné de $k$ prédicteurs métriques $X_1, X_2, dots, X_k$ se formule, pour le $i$-ème individu d’un échantillon aléatoire de taille $N$, sous la forme scalaire classique suivante :
$Y_i = \beta_0 + \beta_1 X_{1i} + \beta_2 X_{2i} + dots + \beta_k X_{ki} + \epsilon_i$
Dans cette formalisation structurelle, $\beta_0$ matérialise l’ordonnée à l’origine (ou constante du modèle), indiquant la valeur théorique moyenne prise par $Y$ lorsque l’ensemble des prédicteurs s’annule simultanément ($X_{1i} = X_{2i} = dots = X_{ki} = 0$). Les grandeurs $\beta_1, \beta_2, dots, \beta_k$ désignent les paramètres de population inconnus correspondant aux coefficients de régression partielle théoriques. Le terme stochastique $\epsilon_i$ incarne l’erreur résiduelle aléatoire inhérente à toute mesure humaine ou physiologique, englobant les variations idiosyncratiques et l’influence d’un nombre infini de micro-facteurs non inclus dans le protocole.
La validité des propriétés inférentielles de ces paramètres repose sur les hypothèses classiques établies par le théorème de Gauss-Markov. Ces conditions exigent que l’espérance mathématique conditionnelle des erreurs soit nulle ($\mathbb{E}[\epsilon_i | \mathbf{X}] = 0$), que la variance de ces résidus demeure constante quel que soit le niveau des prédicteurs (hypothèse d’homoscédasticité : $\text{Var}(\epsilon_i | \mathbf{X}) = \sigma^2$), et que les résidus soient mutuellement indépendants (absence d’autocorrélation : $\text{Cov}(\epsilon_i, \epsilon_m) = 0$ pour tout $i \neq m$). Pour autoriser les inférences statistiques exactes à échantillon fini (intervalles de confiance et tests d’hypothèses), on postule usuellement la distribution gaussienne des perturbations ($\epsilon_i \sim \mathcal{N}(0, \sigma^2)$). La transgression de l’homoscédasticité ou la non-normalité sévère compromet la variance théorique minimale des estimateurs, rendant caduques les probabilités critiques calculées conventionnellement.
3.2 Dérivation matricielle des moindres carrés ordinaires (MCO)
Pour dépasser la complexité des systèmes d’équations scalaires, la modélisation s’écrit sous forme matricielle compacte : $\mathbf{Y} = \mathbf{X}boldsymbol{\beta} + boldsymbol{\epsilon}$. Dans cette formulation, $\mathbf{Y}$ est un vecteur colonne de dimensions $(N \times 1)$, $\mathbf{X}$ désigne la matrice d’expérience de dimensions $(N \times (k+1))$ dont la première colonne est constituée de 1 pour modéliser la constante, $boldsymbol{\beta}$ est le vecteur colonne $((k+1) \times 1)$ des paramètres théoriques, et $boldsymbol{\epsilon}$ est le vecteur $(N \times 1)$ des erreurs inobservables. L’estimateur des moindres carrés ordinaires, dénoté $\mathbf{b}$ ou $\hat{boldsymbol{\beta}}$, a pour objectif d’optimiser l’ajustement global en minimisant la somme des carrés des résidus (SCR) :
$\text{SCR}(boldsymbol{\beta}) = boldsymbol{\epsilon}’boldsymbol{\epsilon} = (\mathbf{Y} – \mathbf{X}boldsymbol{\beta})'(\mathbf{Y} – \mathbf{X}boldsymbol{\beta}) = \mathbf{Y}’\mathbf{Y} – 2boldsymbol{\beta}’\mathbf{X}’\mathbf{Y} + boldsymbol{\beta}’\mathbf{X}’\mathbf{X}boldsymbol{\beta}$
Pour déterminer le vecteur qui minimise cette fonction convexe, nous différentions matriciellement cette expression par rapport au vecteur $boldsymbol{\beta}$ et égalisons le gradient résultant au vecteur nul :
$\frac{\partial \text{SCR}}{\partial boldsymbol{\beta}} = -2\mathbf{X}’\mathbf{Y} + 2\mathbf{X}’\mathbf{X}boldsymbol{\beta} = \mathbf{0} implies \mathbf{X}’\mathbf{X}boldsymbol{\beta} = \mathbf{X}’\mathbf{Y}$
Cette relation fondamentale constitue le système des équations normales. À la condition stricte que la matrice carrée $(\mathbf{X}’\mathbf{X})$ soit d’ordre plein (c’est-à-dire que ses colonnes soient linéairement indépendantes, ce qui exclut toute collinéarité parfaite), elle admet une matrice inverse unique $(\mathbf{X}’\mathbf{X})^{-1}$. Nous dérivons alors directement le célèbre estimateur des MCO :
$\hat{boldsymbol{\beta}} = (\mathbf{X}’\mathbf{X})^{-1}\mathbf{X}’\mathbf{Y}$
C’est au cœur de cette opération d’inversion matricielle que se matérialise l’essence même de la régression partielle. La matrice $(\mathbf{X}’\mathbf{X})$ condense l’ensemble des variances et covariances existant entre tous les prédicteurs du modèle. Son inversion a pour rôle mathématique de « dénouer » ces corrélations mutuelles. Chaque élément individuel du vecteur $\hat{boldsymbol{\beta}}$ représente ainsi un coefficient de régression partielle calculé après neutralisation algébrique explicite de l’ensemble des interdépendances structurelles représentées dans la matrice d’expérience.
3.3 Le théorème de Frisch-Waugh-Lovell et la purification des variables
L’un des résultats les plus élégants de l’économétrie théorique est indéniablement le théorème de Frisch-Waugh-Lovell (FWL), publié initialement par Ragnar Frisch et Frederick V. Waugh en 1933, puis généralisé par Michael C. Lovell en 1963. Ce théorème fournit une démonstration vectorielle et géométrique limpide du mécanisme de « purification » opérée par le coefficient de régression partielle. Considérons un modèle scindé en deux blocs de variables explicatives : $\mathbf{Y} = \mathbf{X}_1 boldsymbol{\beta}_1 + \mathbf{X}_2 boldsymbol{\beta}_2 + boldsymbol{\epsilon}$, où nous désirons estimer le sous-vecteur de coefficients partiels $boldsymbol{\beta}_1$ associé aux variables du bloc $\mathbf{X}_1$, en éliminant l’impact du bloc de covariables $\mathbf{X}_2$.
Le théorème FWL énonce et prouve mathématiquement que le calcul de $\hat{boldsymbol{\beta}}_1$ peut être exécuté rigoureusement à travers un protocole en trois étapes séquentielles :
- Régression résiduelle des prédicteurs : On régresse chaque prédicteur du bloc $\mathbf{X}_1$ sur l’intégralité du bloc $\mathbf{X}_2$, puis on extrait la matrice des résidus de cette régression, notée $\mathbf{X}_1^* = \mathbf{M}_2 \mathbf{X}_1$, où $\mathbf{M}_2 = \mathbf{I} – \mathbf{X}_2(\mathbf{X}_2’\mathbf{X}_2)^{-1}\mathbf{X}_2’$ représente la matrice de projection orthogonale (matrice d’annihilation). Ce vecteur résiduel $\mathbf{X}_1^*$ contient la part de variance de $\mathbf{X}_1$ qui est parfaitement orthogonale, c’est-à-dire totalement exempte de toute influence de $\mathbf{X}_2$.
- Régression résiduelle du critère : On régresse la variable dépendante $\mathbf{Y}$ sur ce même bloc de covariables $\mathbf{X}_2$, et l’on extrait le vecteur résiduel correspondant : $\mathbf{Y}^* = \mathbf{M}_2 \mathbf{Y}$. Ce vecteur incarne les variations de la variable réponse qui ne peuvent en aucun cas être prédites ou expliquées par $\mathbf{X}_2$.
- Régression bivariée finale : On applique une régression simple entre ces deux résidus purs : $\mathbf{Y}^* = \mathbf{X}_1^* boldsymbol{\beta}_1 + \mathbf{u}$. L’estimateur résultant est mathématiquement identique, à chaque décimale près, au coefficient de régression partielle issu de l’estimation multivariée complète : $\hat{boldsymbol{\beta}}_1 = (\mathbf{X}_1^{*prime}\mathbf{X}_1^*)^{-1}\mathbf{X}_1^{*prime}\mathbf{Y}^*$.
Cette égalité matricielle démontre magistralement qu’un coefficient de régression partielle n’est rien d’autre que la pente d’une régression simple reliant deux entités préalablement décorrélées et purifiées de l’influence de tous les autres prédicteurs.
4. 4. La clause « ceteris paribus » : principe de contrôle statistique
4.1 Signification épistémique de « toutes choses étant égales par ailleurs »
L’expression latine ceteris paribus (« toutes choses étant égales par ailleurs ») structure toute la rhétorique scientifique moderne. Dans l’interprétation d’un coefficient de régression partielle, elle prend un sens précis et hautement contraignant. Lorsque l’on affirme que le prédicteur $X_1$ affiche un coefficient partiel $B_1 = 3{,}5$, cela signifie formellement que pour deux individus théoriques ou observés qui posséderaient des scores strictement identiques sur l’intégralité des autres prédicteurs ($X_2, X_3, dots, X_k$), mais qui différeraient d’une unité sur $X_1$, la différence prédite entre leurs scores respectifs sur $Y$ serait exactement de 3,5 unités.
Cette construction permet de simuler in silico un protocole expérimental contrôlé à partir de simples données observationnelles transversales. Dans une expérimentation en laboratoire, le chercheur maintient constantes les conditions de température, de luminosité ou de fatigue pour tester l’impact d’un stimulus unique. Dans le modèle de régression, ce maintien à l’état constant s’accomplit non pas par manipulation physique ou contention environnementale — opération généralement inapplicable aux caractéristiques psychologiques stables comme la personnalité —, mais par ajustement mathématique條件nel sur la surface d’hyperplan multidimensionnelle définie par l’équation de régression.
4.2 Le concept de variance unique et de variance partagée
Pour visualiser la redistribution d’information orchestrée par la partialité, les méthodologistes recourent couramment à la logique des diagrammes de Venn représentant les variances d’échantillonnage sous la forme de surfaces circulaires qui se chevauchent. La variance totale de la variable critère $Y$ forme un ensemble découpé en plusieurs sous-espaces : une portion résiduelle non modélisée (correspondant au coefficient de non-détermination, $1 – R^2$), des portions de variance unique assignables exclusivement à un prédicteur particulier, et des portions de variance partagée (ou variance de redondance) situées à l’intersection de deux ou plusieurs variables explicatives corrélées.
Le coefficient de régression partielle découle rigoureusement de la variance résiduelle unique associée au prédicteur concerné. L’information située dans les intersections communes — c’est-à-dire les zones où $X_1$ et $X_2$ covarient simultanément avec $Y$ — participe à l’accroissement global du coefficient de détermination multiple $R^2$, mais est purement et simplement exclue du calcul des coefficients individuels $B_1$ et $B_2$. Par conséquent, plus la corrélation entre les prédicteurs s’amplifie, plus l’aire de variance unique s’amenuise au profit de l’aire d’intersection, conduisant à une réduction substantielle du signal propre disponible pour calibrer chaque pente partielle.
4.3 Limites inhérentes au contrôle statistique passif
Il est impératif d’identifier la frontière séparant le contrôle statistique passif opéré par la régression de l’interventionnisme expérimental direct. L’ajustement multivarié repose sur un ensemble d’assomptions strictes dont le non-respect invalide la validité théorique de la clause ceteris paribus. En premier lieu, la régression est structurellement incapable de contrôler des facteurs confondants non mesurés ou ignorés par le chercheur. Si une variable causale externe majeure n’a pas été quantifiée et insérée dans la matrice $\mathbf{X}$, le coefficient partiel estimé demeure biaisé et inexploitable au sens d’une dérivation causale.
En second lieu, le modèle linéaire postule une forme d’ajustement strictement additif et linéaire. Si la neutralisation requise dépend en réalité de trajectoires logarithmiques, quadratiques ou de bifurcations complexes, la soustraction linéaire de variance s’avérera incomplète et laissera subsister des biais d’ajustement pernicieux. De surcroît, les instruments psychométriques comportent inévitablement des erreurs de mesure non négligables. L’erreur de mesure sur une variable de contrôle affaiblit mathématiquement sa capacité à absorber la variance confondante, ce qui a pour conséquence paradoxale de transférer indûment une partie de cette variance résiduelle non maîtrisée vers le coefficient partiel du prédicteur cible. Enfin, l’introduction imprudente de variables collisives (des variables qui constituent des effets communs de la variable prédictive et du critère) induit artificiellement une corrélation spurieuse, inversant potentiellement la vérité méthodologique recherchée.
5. 5. Exemple empirique détaillé : prédiction de la performance académique
5.1 Contexte de l’étude et formalisation de la question de recherche
Afin de concrétiser ces notions théoriques, examinons une étude empirique fictive mais représentative, menée auprès d’une cohorte d’étudiants inscrits au concours d’admission d’un master de psychologie clinique. Les membres du jury d’admission souhaitent identifier avec rigueur les facteurs comportementaux associés à la réussite des candidats lors de l’épreuve standardisée finale. L’enjeu est de déterminer si l’effort temporel consenti dans les révisions produit un impact tangible sur les scores, indépendamment du niveau d’entraînement pratique mesuré par le nombre d’épreuves blanches effectuées sous contrainte temporelle.
Deux prédicteurs cardinaux sont mesurés durant le semestre préparatoire : le volume total d’heures consacrées à l’étude individuelle des manuels fondamentaux (noté « Heures », mesuré en heures cumulées) et le nombre d’examens blancs réalisés en conditions réelles d’évaluation (noté « ExamensBlancs », variable discrète de comptage). La variable réponse est la performance finale mesurée par le score brut standardisé à l’examen national d’admission (noté « Score », échelle continue variant de 0 à 100 points). L’hypothèse de recherche centrale postule que les deux activités apportent des gains marginaux complémentaires, justifiant l’inclusion simultanée des deux prédicteurs dans une démarche multivariée.
5.2 Présentation des données observées et statistiques descriptives
Pour illustrer ce protocole analytique, considérons un échantillon représentatif de $N = 100$ étudiants ayant achevé la préparation. L’analyse exploratoire initiale des distributions confirme l’absence de valeurs extrêmes aberrantes ou distributives problématiques (pas d’asymétrie majeure) et valide les postulats de continuité métrique requis pour l’application des moindres carrés ordinaires. Le tableau ci-dessous récapitule les paramètres descriptifs fondamentaux de la cohorte étudiée.
| Variable Analysée | Rôle dans le Modèle | Moyenne ($\bar{X}$) | Écart-type ($s$) | Étendue [Min – Max] |
|---|---|---|---|---|
| Score | Variable Réponse ($Y$) | 68,40 | 12,50 | [38,00 – 95,00] |
| Heures | Prédicteur Continu ($X_1$) | 5,20 | 1,45 | [1,50 – 8,90] |
| ExamensBlancs | Prédicteur Discret ($X_2$) | 3,80 | 1,20 | [1,00 – 7,00] |
L’analyse de la matrice de corrélations bivariées de Pearson révèle des liaisons linéaires notables. Le coefficient de corrélation bivariée entre le nombre d’heures d’étude et le score final atteint $r_{X_1, Y} = 0{,}72$ ($p < 0{,}001$), indiquant une forte association positive globale. L'association entre le nombre d'examens blancs réalisés et le score final s'établit à $r_{X_2, Y} = 0{,}65$ ($p < 0{,}001$). Enfin, fait crucial pour l'application de la régression partielle, les deux prédicteurs entretiennent une corrélation positive substantielle entre eux : $r_{X_1, X_2} = 0{,}55$ ($p < 0{,}001$). Les étudiants consacrant le plus d'heures à l'étude tendent également à réaliser davantage d'examens blancs, confirmant un chevauchement potentiel d'informations qu'une analyse univariée naïve serait incapable de séparer.
5.3 Spécification formelle de l’équation de régression multiple
Compte tenu de ces interdépendances empiriques, nous spécifions l’équation de régression linéaire multiple pour le $i$-ème étudiant sous la forme d’un plan prédictif bidimensionnel avec terme d’erreur stochastique :
$\text{Score}_i = \beta_0 + \beta_1 \cdot \text{Heures}_i + \beta_2 \cdot \text{ExamensBlancs}_i + \epsilon_i$
Dans ce modèle, les coefficients $B_1$ et $B_2$ (qui estiment empiriquement $\beta_1$ et $\beta_2$) sont explicitement investis du statut de coefficients de régression partielle. Le paramètre $B_1$ matérialise l’effet résiduel net de l’investissement horaire théorique sur la performance au concours, débarrassé de l’influence associée aux épreuves pratiques passées. Corrélativement, $B_2$ quantifie l’apport marginal spécifique de chaque entraînement à blanc supplémentaire, à niveau d’heures de révision constant. La constante $B_0$ fournira une référence théorique d’ancrage interceptif, indiquant le score prédictible pour un candidat qui n’aurait fourni aucune heure d’étude tout en s’abstenant de passer le moindre examen blanc ($X_1 = 0$ et $X_2 = 0$).
6. 6. Interprétation pas à pas des sorties logicielles
6.1 Lecture rigoureuse de la table de régression
L’estimation des paramètres du modèle par la méthode des moindres carrés ordinaires génère un tableau de coefficients multivariés standardisé que l’on retrouve sous une forme quasi identique dans tous les progiciels de statistique contemporains. L’examen minutieux de ces indicateurs numériques constitue l’étape centrale de la validation empirique des hypothèses de travail.
| Paramètre Modélisé | Coefficient Brut ($B$) | Erreur Type ($\text{SE}$) | Bêta ($\beta$) | Statistique $t$ | Valeur $p$ ($p\text{-value}$) | Intervalle de Confiance 95% |
|---|---|---|---|---|---|---|
| Constante ($B_0$) | 25,32 | 3,45 | — | 7,34 | $< 0{,}001$ | [18,47 ; 32,17] |
| Heures ($X_1$) | 5,56 | 0,68 | 0,52 | 8,18 | $< 0{,}001$ | [4,21 ; 6,91] |
| ExamensBlancs ($X_2$) | 3,74 | 0,82 | 0,29 | 4,56 | $< 0{,}001$ | [2,11 ; 5,37] |
L’analyse débute par la lecture de la constante interceptive $B_0 = 25{,}32$, caractérisée par une erreur type de $3{,}45$ et un ratio critique de Student $t = 7{,}34$, hautement significatif. Sur le plan du premier prédicteur d’intérêt, le coefficient de régression partielle associé aux heures d’étude s’élève à $B_1 = 5{,}56$ ($\text{SE} = 0{,}68$ ; $t = 8{,}18$ ; $p < 0{,}001$). Enfin, l'examen de la ligne dédiée aux examens blancs met en évidence un coefficient de régression partielle estimé à $B_2 = 3{,}74$ ($\text{SE} = 0{,}82$ ; $t = 4{,}56$ ; $p < 0{,}001$). Le coefficient global de détermination du modèle atteint $R^2 = 0{,}61$, démontrant que $61,%$ de la variance des notes finales est expliquée de manière conjointe par ces deux prédicteurs.
6.2 Formulation standardisée de l’interprétation du coefficient
L’interprétation académique des coefficients partiels exige une précision sémantique absolue afin de ne pas induire le lecteur en erreur quant à la portée réelle des données. Les formulations doivent impérativement expliciter l’action conjointe de la métrique brute et de la clause de contrôle statistique.
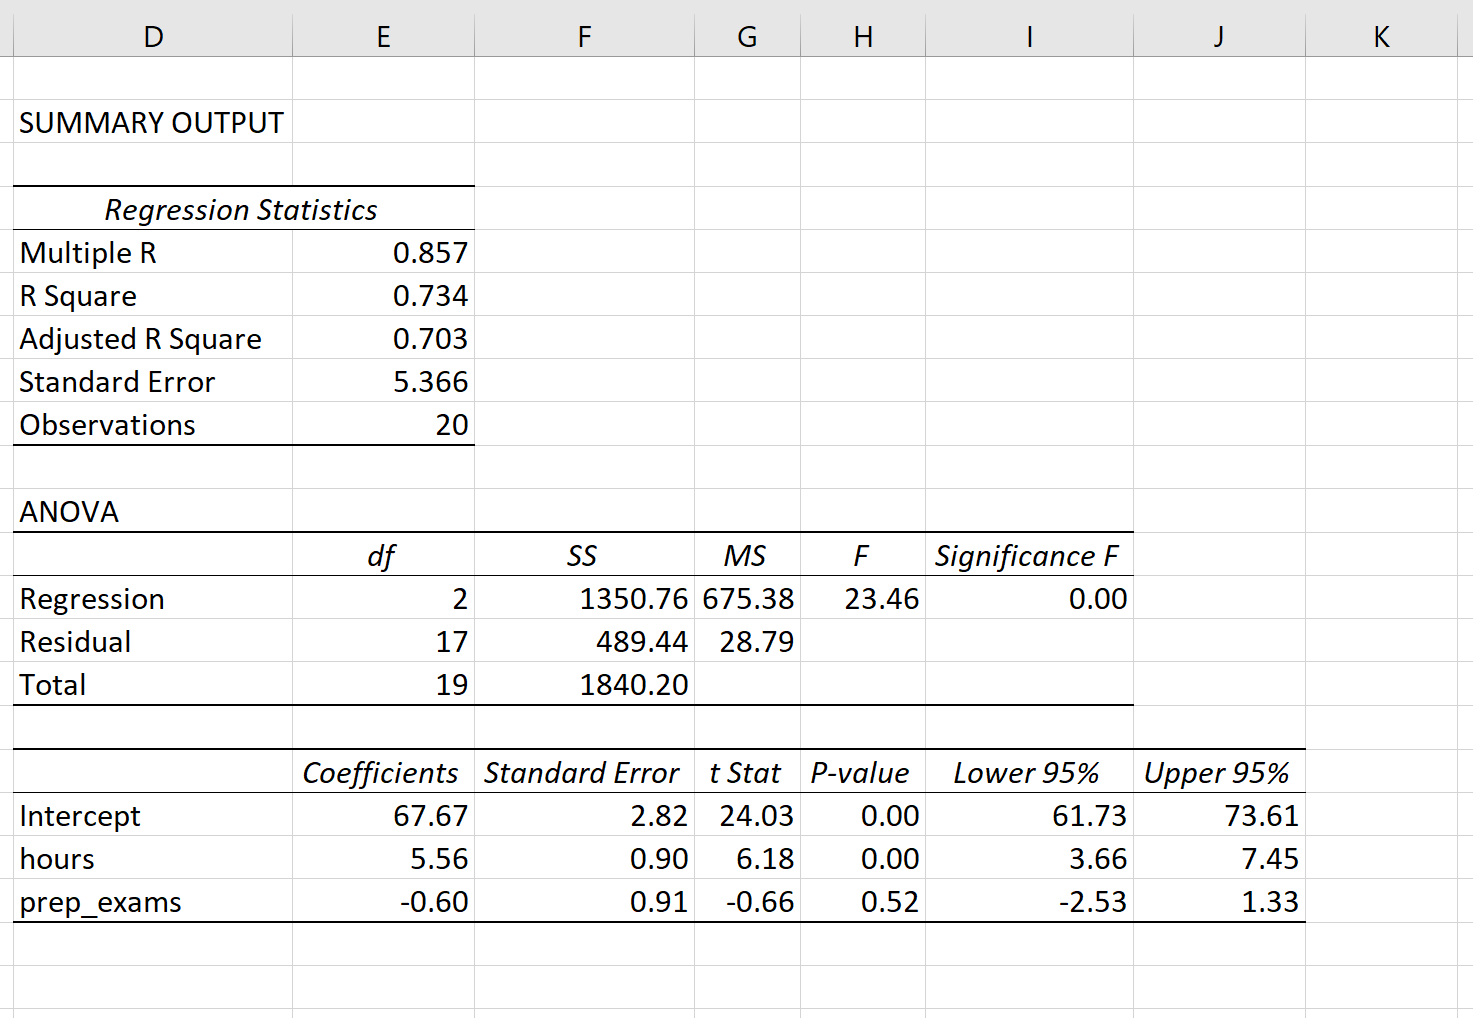
Pour le prédicteur des heures d’étude ($B_1 = 5{,}56$), la transcription formelle s’établit ainsi : « Pour chaque heure supplémentaire d’étude individuelle effectuée au cours du semestre, le score obtenu à l’examen d’admission augmente en moyenne de 5,56 points, à condition que le nombre d’examens blancs réalisés demeure strictement constant. » Cette formulation rend compte du fait que le gain observé n’est pas imputable à un surcroît simultané d’examens blancs, garantissant ainsi l’isolation de l’impact direct du temps d’étude.
De façon symétrique, l’énoncé relatif au second prédicteur s’articule comme suit : « Chaque examen blanc supplémentaire réalisé par un étudiant est associé à un gain marginal moyen de 3,74 points sur le score final d’admission, toutes choses étant égales par ailleurs quant au volume total d’heures d’étude consacrées à la préparation. » Il convient de souligner que ces formulations emploient délibérément des locutions descriptives (« est associé à », « augmente en moyenne de ») plutôt qu’un vocabulaire causal affirmatif (« provoque », « génère »), conformément aux standards épistémologiques requis lors de l’analyse de données d’observation.
6.3 Comparaison entre sorties sous R, SPSS et Python (Statsmodels)
Bien que les environnements informatiques adoptent des présentations visuelles distinctes, la cohérence mathématique des résultats issus des MCO est totale d’un logiciel à un autre. Sous l’écosystème R, l’appel classique à la fonction lm(Score ~ Heures + ExamensBlancs, data = df) combiné à l’instruction summary() structure la sortie sous la rubrique « Coefficients: », articulée en quatre colonnes universelles : Estimate (reflétant les valeurs brutes $B$), Std. Error (les erreurs types), t value et Pr(>|t|) (la probabilité critique bilatérale associée au test de nullité).
Dans l’interface logicielle d’IBM SPSS Statistics, le tableau principal s’intitule conventionnellement « Coefficients ». Ce tableau présente une bipartition pédagogique : la sous-catégorie « Coefficients non standardisés » regroupe la colonne « B » et la colonne « Erreur standard », tandis qu’une colonne distincte baptisée « Coefficients standardisés » restitue directement les pondérations « Bêta ». Les colonnes terminales hébergent la statistique de Student et la significativité bilatérale (« Sig. »). Enfin, dans l’environnement Python à travers la bibliothèque Statsmodels (classe OLS issue du sous-module statsmodels.api), la méthode model.fit().summary() génère un récapitulatif synthétique textuel affichant les colonnes coef, std err, t, P>|t|, complétées par les bornes numériques précises de l’intervalle de confiance à 95 % ([0.025 ; 0.975]). Cette parfaite invariance computationnelle atteste de l’universalité de la théorie matricielle sous-jacente.
7. 7. Coefficients standardisés versus non standardisés
7.1 Le coefficient non standardisé (B) et sa pertinence clinique
Le coefficient non standardisé, universellement désigné par la lettre latine majuscule $B$ (ou minuscule $b$), préserve rigoureusement l’unité de mesure native propre à chaque indicateur du protocole expérimental. Cette fidélité métrique lui confère une pertinence translationnelle majeure en pratique clinique, ergonomique et psycho-éducative. C’est le coefficient $B$ qui permet d’élaborer des équations de prédiction directement utilisables par les praticiens sur le terrain : $\hat{Y} = 25{,}32 + 5{,}56(X_1) + 3{,}74(X_2)$.
Grâce à cette valeur brute, un conseiller académique peut immédiatement formuler des préconisations individualisées et concrètes. Par exemple, si un étudiant se situe actuellement à un score prédictif de 60 points et que le seuil critique d’admissibilité est fixé à 75 points, le conseiller peut calculer exactement l’effort marginal requis : un ajout précis d’environ 2,7 heures d’étude hebdomadaire permettra de combler cet écart de 15 points (car $15 / 5{,}56 \approx 2{,}7$), à condition que la pratique des examens blancs demeure constante. Le coefficient non standardisé présente toutefois un désavantage majeur : son amplitude numérique dépend mécaniquement de l’échelle d’évaluation choisie. Si la variable horaire était enregistrée en minutes plutôt qu’en heures, le coefficient deviendrait $5{,}56 / 60 = 0{,}0926$, sans que la réalité sous-jacente de la force d’association n’ait subi la moindre modification.
7.2 Le coefficient standardisé (Bêta) et la comparaison relative
Pour s’affranchir de la dépendance aux unités de mesure arbitraires et autoriser une comparaison directe de l’importance relative des différents prédicteurs au sein d’une même équation, les statisticiens recourent au coefficient de régression partielle standardisé, usuellement symbolisé par la lettre grecque $\beta$ (ou « Bêta »). Cette standardisation s’obtient conceptuellement en convertissant au préalable l’ensemble des variables du modèle (dépendante comme explicatives) en scores centrés-réduits d’espérance nulle et de variance unitaire ($Z$-scores, de moyenne 0 et d’écart-type 1) :
$\beta_j = B_j \times \left( \frac{s_{X_j}}{s_Y} \right)$
Dans notre cas empirique, le coefficient standardisé pour les heures d’étude est calculé comme suit : $\beta_1 = 5{,}56 \times (1{,}45 / 12{,}50) = 0{,}52$. Pour les examens blancs, il atteint $\beta_2 = 3{,}74 \times (1{,}20 / 12{,}50) = 0{,}29$. L’interprétation change de registre métrique : « Une augmentation d’un écart-type sur le nombre d’heures d’étude est associée à un accroissement moyen de 0,52 écart-type sur le score au concours, toutes choses étant égales par ailleurs. » Cette métrique normalisée permet d’établir une hiérarchie objective au sein de l’échantillon : le temps de travail régulier exerce un poids explicatif relatif presque deux fois plus élevé ($\beta = 0{,}52$) que l’entraînement spécifique aux examens blancs ($\beta = 0{,}29$).
7.3 Directives de choix entre métrique brute et métrique standardisée
Le choix entre l’usage préférentiel des coefficients bruts ($B$) ou standardisés ($\beta$) dépend de l’objectif théorique poursuivi par la recherche. Lorsque le chercheur souhaite évaluer des modèles psychologiques conceptuels en compétition — par exemple comparer si la résilience cognitive exerce une influence plus déterminante que le quotient intellectuel sur l’adaptation comportementale —, le coefficient $\beta$ offre une unité commune abstraite indispensable pour trancher la querelle théorique au sein du corpus analysé.
Cependant, les coefficients standardisés souffrent d’une limitation critique mise en évidence par les spécialistes de la méthodologie quantitative : ils dépendent directement des écarts-types d’échantillonnage ($s_{X_j}$ et $s_Y$). Par conséquent, la comparaison de coefficients standardisés à travers des sous-groupes de population distincts, ou entre différentes études publiées dans la littérature scientifique, est hautement périlleuse. Une variation de l’hétérogénéité d’un échantillon modifie artificiellement la valeur de $\beta$ quand bien même la dynamique relationnelle brute $B$ resterait rigoureusement inchangée. Pour cette raison, les recommandations de l’American Psychological Association (APA) imposent la publication conjointe et systématique des deux métriques, en rappelant que seules les métriques brutes autorisent les synthèses cumulatives valides au sein de protocoles méta-analytiques rigoureux.
8. 8. Défis méthodologiques : multicollinéarité et instabilité des coefficients
8.1 Mécanismes et conséquences de la multicollinéarité
La multicollinéarité désigne la situation pathologique dans laquelle deux ou plusieurs prédicteurs d’un modèle de régression multiple entretiennent entre eux des relations linéaires fortes ou quasi parfaites. Dans ce contexte, la matrice $(\mathbf{X}’\mathbf{X})$ approche de la singularité mathématique, ce qui perturbe profondément le calcul de sa matrice inverse. Bien que la multicollinéarité ne biaise pas directement l’estimation ponctuelle des coefficients partiels (les estimateurs demeurent non biaisés selon le cadre classique des MCO), elle engendre une inflation spectaculaire de leur variance d’échantillonnage :
$\text{Var}(B_j) = \frac{\sigma^2}{(N – 1) \cdot s_{X_j}^2 \cdot (1 – R_j^2)}$
L’élément déterminant de cette formule est le terme $(1 – R_j^2)$ situé au dénominateur, où $R_j^2$ représente le coefficient de détermination issu de la régression auxiliaire du prédicteur $X_j$ sur l’ensemble de tous les autres prédicteurs. Lorsque cette collinéarité augmente ($R_j^2 to 1$), le dénominateur tend vers zéro, provoquant une augmentation considérable de l’erreur type $\text{SE}(B_j)$. Les estimations des pentes deviennent extrêmement instables et sensibles aux moindres fluctuations d’échantillonnage. Le risque majeur est de voir les tests $t$ individuels s’effondrer vers des valeurs non significatives ($p > 0{,}05$), alors même que le modèle pris globalement affiche un $R^2$ élevé et un test de Fisher $F$ hautement significatif, rendant le chercheur aveugle à la contribution réelle de ses variables d’intérêt.
8.2 Outils diagnostics quantitatifs
Pour prévenir ces écueils interprétatifs, l’analyste doit impérativement mobiliser des indicateurs diagnostiques formels au-delà du simple examen visuel de la matrice de corrélation de Pearson. L’instrument privilégié est le facteur d’inflation de la variance (VIF) et son corollaire immédiat, la tolérance ($Tol_j$) :
$VIF_j = \frac{1}{1 – R_j^2} = \frac{1}{Tol_j}$
Le VIF indique directement par quel facteur la variance du coefficient partiel estimé est multipliée en raison de la présence des autres covariables, par comparaison avec une situation idéale d’orthogonalité parfaite. En règle générale, une tolérance inférieure à 0,20 (soit un $VIF > 5$) constitue un signal d’alerte méthodologique précoce, tandis qu’une tolérance chutant sous 0,10 (soit un $VIF > 10$) signale une multicollinéarité sévère et destructrice pour l’inférence statistique. Pour une granularité d’analyse supérieure, on utilise la procédure de décomposition spectrale proposée par David A. Belsley, basée sur les indices de condition propres aux valeurs de la matrice d’expérience : un indice de condition supérieur à 30 couplé à une concentration conjointe de la décomposition de variance résiduelle sur plusieurs variables indique formellement une dépendance linéaire destructrice.
8.3 Stratégies d’atténuation et remèdes analytiques
Face à une multicollinéarité problématique avérée, le chercheur dispose de plusieurs options méthodologiques adaptées à ses impératifs de recherche :
- Agrégation conceptuelle et dimensionnelle : Si deux variables explicatives mesurent en réalité des facettes quasi indiscernables du même phénomène sous-jacent (par exemple, anxiété de performance et anxiété d’anticipation), la démarche la plus rigoureuse consiste à créer un score composite unifié par moyenne pondérée ou à extraire leur dimension commune via une Analyse en Composantes Principales (ACP).
- Élagage théorique sélectif : Lorsque l’une des deux covariables hautement corrélées présente une valeur explicative marginale ou un coût de recueil élevé, sa suppression rationnelle du modèle allège la structure d’estimation et stabilise les coefficients partiels des variables maintenues.
- Régularisation et régression pénalisée : Si le nombre de variables est important et que l’omission n’est pas souhaitable, le recours aux techniques de régularisation moderne de type Ridge (pénalité $L_2$) ou Elastic Net (combinaison de pénalités $L_1$ et $L_2$) permet d’introduire un biais minime contrôlé dans l’estimation afin de réduire drastiquement la variance globale des estimateurs partiels.
- Accroissement ciblé de l’échantillonnage : Comme l’illustre la formule de la variance d’échantillonnage, multiplier par deux ou trois la taille de l’échantillon ($N$) compense mathématiquement l’effet déstabilisateur du terme $(1 – R_j^2)$, restaurant ainsi une précision acceptable pour les tests statistiques individuels.
9. 9. Applications avancées en recherche psychologique et comportementale
9.1 Contrôle des variables sociodémographiques et d’état
Dans la recherche contemporaine en psychologie cognitive et en neuropsychologie, le coefficient de régression partielle est continuellement mobilisé pour neutraliser les facteurs de confusion sociodémographiques dits « non négociables », tels que l’âge chronologique, le sexe biologique ou le niveau socio-économique des parents. Lorsqu’une équipe de recherche tente de mesurer l’impact d’un entraînement sur la plasticité cérébrale ou la flexibilité cognitive, l’âge constitue une variable confondante majeure : il est naturellement corrélé aux scores de mémoire de travail et peut biaiser l’adhésion au programme expérimental. En intégrant formellement l’âge comme prédicteur dans le modèle, le coefficient partiel associé au programme capture exclusivement le progrès imputable au traitement, une fois les déclins physiologiques normaux mathématiquement absorbés.
Une logique identique régit la dissociation méthodologique entre variables de trait et variables d’état. Dans l’évaluation clinique de l’efficacité d’une nouvelle approche psychothérapeutique sur la sévérité des symptômes dépressifs, il est impératif de contrôler statistiquement le niveau de dépression initial évalué en amont de l’intervention (score pré-test) ainsi que le niveau d’anxiété générale de fond (trait stable de névrosisme). Le coefficient partiel associé au type de prise en charge mesure alors la réduction symptomatique résiduelle, garantissant que l’amélioration constatée n’est pas un simple artefact issu de disparités initiales entre les patients ou de la sévérité initiale des troubles.
9.2 Les coefficients partiels dans la détection des effets modérateurs
L’investigation de mécanismes modérateurs — où l’impact d’une variable indépendante sur un critère varie en fonction du niveau d’une troisième variable — repose directement sur le formalisme des coefficients de régression partielle appliqués à des termes multiplicatifs. La structure d’un modèle d’interaction s’écrit de manière canonique :
$Y = \beta_0 + \beta_1 X_1 + \beta_2 X_2 + \beta_3 (X_1 \cdot X_2) + \epsilon$
Dans cette modélisation, le coefficient de régression partielle $\beta_3$, associé au produit d’interaction, quantifie la modification incrémentale de la pente reliant $Y$ à $X_1$ pour chaque élévation d’une unité de la variable modératrice $X_2$.
Toutefois, l’incorporation de ce terme d’interaction modifie profondément la signification des coefficients partiels du premier ordre $\beta_1$ et $\beta_2$. Ceux-ci perdent leur statut d’effets globaux moyens pour devenir des « effets simples conditionnels ». Le paramètre $\beta_1$ ne décrit plus l’effet moyen de $X_1$ sur l’ensemble de la population, mais correspond précisément à la pente partielle de $X_1$ au point précis où le modérateur s’annule rigoureusement ($X_2 = 0$). Pour préserver une interprétabilité clinique logique à ces coefficients du premier ordre, il est fortement recommandé de centrer préalablement les prédicteurs continus sur leur moyenne respective avant de dériver le terme multiplicatif. Ce centrage garantit que $\beta_1$ conserve le statut de coefficient partiel de $X_1$ calculé au niveau moyen du modérateur.
9.3 Intégration dans la modélisation par équations structurelles (SEM)
La modélisation par équations structurelles (SEM) représente l’aboutissement méthodologique contemporain de l’analyse multivariée, intégrant simultanément des mesures d’erreurs psychométriques et des systèmes complexes d’équations dépendantes. Au sein du sous-modèle structurel, les coefficients de cheminement (souvent appelés path coefficients) ne sont rien d’autre que des coefficients de régression partielle standardisés estimés au sein d’un réseau causal direct.
Le saut qualitatif majeur de la modélisation SEM réside dans sa capacité à opérer cette partialisation non pas sur des variables observées imparfaites, mais sur des variables latentes théoriques. Les construits inobservables (comme l’estime de soi ou l’intelligence fluide) sont mesurés via de multiples indicateurs empiriques, ce qui permet de purger explicitement la variance d’erreur de mesure lors de l’estimation. Par conséquent, les coefficients partiels structurels obtenus via les algorithmes du maximum de vraisemblance au sein d’un modèle SEM sont débarrassés de l’atténuation classique causée par l’erreur psychométrique, offrant une vision beaucoup plus fidèle de la véritable magnitude des liens fonctionnels reliant les concepts théoriques.
10. 10. Inférence statistique, tests d’hypothèses et intervalles de confiance
10.1 Le test t de Student sur le coefficient partiel individuel
Pour valider formellement la significativité statistique d’un coefficient de régression partielle estimé sur un échantillon, le chercheur formule un test d’hypothèse bilatéral classique. L’hypothèse nulle ($H_0 : \beta_j = 0$) stipule que le prédicteur $X_j$ n’apporte aucune contribution linéaire incrémentale à l’explication de la variable réponse, une fois les autres prédicteurs pris en compte. L’hypothèse alternative ($H_1 : \beta_j \neq 0$) affirme qu’il subsiste une part d’effet résiduel direct non nulle au sein de la population parente.
La statistique empirique de test suit une loi de Student à $N – k – 1$ degrés de liberté (où $N$ est la taille de l’échantillon et $k$ le nombre total de prédicteurs hors constante). Elle se calcule comme le ratio direct de l’estimation ponctuelle sur son erreur type d’échantillonnage :
$t_{obs} = \frac{B_j}{\text{SE}(B_j)}$
Dans notre cas d’étude académique, le test appliqué aux heures d’étude donne : $t = 5{,}56 / 0{,}68 = 8{,}18$. Avec un effectif de $N = 100$ et $k = 2$, les degrés de liberté s’élèvent à $df = 100 – 2 – 1 = 97$. La valeur critique de référence pour un risque d’erreur consenti de première espèce fixé au seuil classique $\alpha = 0{,}05$ s’établit approximativement à $1{,}98$. Le score observé $8{,}18$ dépassant très largement ce seuil (probabilité critique $p < 0{,}001$), nous rejetons sans ambiguïté l'hypothèse nulle d'absence d'effet. Il convient néanmoins de souligner avec force qu'un test $t$ concluant valide formellement la réplicabilité de l'effet dans la population, mais ne garantit en rien son utilité concrète : seule la magnitude de la métrique $B_j$ et sa transposabilité clinique permettent d'attester de la pertinence appliquée du résultat.
10.2 Construction et interprétation des intervalles de confiance
L’inférence statistique moderne accorde une place centrale aux intervalles de confiance, jugés méthodologiquement plus informatifs qu’une simple valeur $p$ dichotomique. L’intervalle de confiance à $(1 – \alpha),%$ autour du coefficient de régression partielle délimite la plage de valeurs plausibles au sein de laquelle se situe le paramètre de population $\beta_j$, compte tenu de la précision de notre échantillon :
$\text{IC}_{1-\alpha}(B_j) = \left[ B_j – t_{crit} \cdot \text{SE}(B_j) ; B_j + t_{crit} \cdot \text{SE}(B_j) \right]$
Pour le prédicteur des heures d’étude, avec un seuil de confiance à 95 % ($t_{crit} \approx 1{,}984$), l’intervalle s’étend formellement de $[4{,}21 ; 6{,}91]$. D’un point de vue fréquentiste rigoureux, cet intervalle signifie que si l’on répétait cette même étude d’admission un nombre infini de fois dans des conditions méthodologiques identiques, $95,%$ des intervalles ainsi construits contiendraient la véritable valeur théorique de $\beta_1$. Sur le plan pratique, cet intervalle apporte une information précieuse quant à la précision de notre estimation : au niveau de risque consenti de $5,%$, nous pouvons affirmer que le gain horaire moyen est au minimum de 4,21 points et au maximum de 6,91 points par heure d’investissement, autorisant ainsi des préconisations pédagogiques réalistes et prudentes.
10.3 Puissance statistique et détermination de la taille d’échantillon
La puissance statistique ($1 – \beta_{erreur}$) d’un test appliqué à un coefficient partiel représente la probabilité mathématique de détecter un effet marginal direct de magnitude déterminée lorsque cet effet existe réellement au sein de la population. Cette puissance dépend de quatre paramètres interdépendants : le seuil de tolérance à l’erreur de type I ($\alpha$), la taille finale de l’échantillon observé ($N$), la magnitude réelle de la taille de l’effet sous-jacent (exprimée par le carré de la corrélation semi-partielle $sr_j^2$) et le degré de multicollinéarité préexistant avec les autres variables explicatives mesuré par le $VIF_j$.
Un écueil fréquent dans la littérature comportementale réside dans l’utilisation de protocoles sous-dimensionnés. Lorsque l’échantillon est trop faible ($N < 50$ pour un modèle à 4 ou 5 covariables), la puissance chute drastiquement, conduisant à deux impasses méthodologiques symétriques : la non-détection d'effets réels importants (erreur de type II) ou la surestimation flagrante de la taille de l'effet d'un coefficient lors des rares détections significatives (effet de sélection ou « malédiction du vainqueur »). Il est donc indispensable de réaliser un calcul de taille d'échantillon a priori à l'aide d'outils dédiés comme le logiciel G*Power, en s’assurant d’anticiper la part de variance que les covariables partagent inévitablement entre elles.
11. 11. Erreurs courantes d’interprétation et pièges épistémologiques
11.1 Le saut illégitime de la partialisation à la causalité
L’erreur la plus pernicieuse et la plus répandue dans les publications scientifiques consiste à assimiler abusivement l’ajustement statistique par partialisation à une validation d’inférence causale directe. Observer qu’un coefficient de régression partielle demeure hautement significatif après l’inclusion de plusieurs covariables ne prouve nullement que $X$ est la cause de $Y$. La causalité inverse demeure une menace constante en données observationnelles : une corrélation partielle significative entre sentiment d’auto-efficacité et performance académique peut tout aussi bien signifier que les succès antérieurs passés génèrent le niveau de confiance mesuré au moment de l’enquête.
De plus, l’ajustement peut introduire des biais sévères si le chercheur méconnaît la structure causale sous-jacente. L’inclusion d’une variable dite « collisionneur » (un facteur qui représente une conséquence commune du prédicteur et de la variable réponse) crée artificiellement une relation partielle biaisée là où aucune association réelle n’existait dans la nature. Pour prémunir le chercheur contre ces contresens analytiques, l’épidémiologie et la biomécanique contemporaines ont généralisé l’usage des graphes acycliques dirigés (DAG) théorisés par Judea Pearl. Seule la structure topologique explicite d’un graphe de causalité théorique permet d’identifier formellement les covariables qu’il est pertinent d’ajuster pour bloquer les chemins indirects sans ouvrir accidentellement de canaux spuri eux.
11.2 Les paradoxes de suppression statistique
Le phénomène de suppression statistique constitue l’une des surprises computationnelles les plus déroutantes de la régression multivariée. Une situation de suppression survient lorsque l’intégration d’un second prédicteur ($X_2$) dans une équation linéaire a pour effet direct d’augmenter substantiellement la valeur absolue du coefficient de régression partielle du premier prédicteur ($X_1$), ou d’en inverser le signe apparent, par rapport à leur corrélation bivariée initiale d’ordre zéro.
Le mécanisme théorique s’explique par la nature de l’information traitée : le suppresseur ($X_2$) n’a pas nécessairement besoin d’être fortement corrélé à la variable dépendante $Y$ ; son rôle principal est de s’associer à la composante d’erreur non pertinente contenue dans $X_1$. En absorbant cette variance parasite propre au prédicteur d’intérêt, le suppresseur « nettoie » le prédicteur $X_1$, révélant ainsi la véritable force de son lien avec le critère d’étude. On distingue classiquement la suppression classique (où la corrélation bivariée $r_{X_2, Y}$ est quasiment nulle mais son coefficient partiel $B_2$ devient hautement significatif), la suppression coopérative (où les prédicteurs s’aident mutuellement à accroître leurs coefficients respectifs) et la suppression négative ou d’inversion. Ignorer ces mécanismes expose l’analyste à éliminer à tort des covariables lors de sélections automatiques pas à pas (stepwise), commettant ainsi une lourde faute méthodologique.
11.3 Mauvaises interprétations des prédicteurs corrélés
Une dernière catégorie d’erreurs récurrentes concerne l’attribution de parts d’explication lors de l’interprétation de modèles à prédicteurs corrélés. Certains analystes commettent la faute mathématique consistant à sommer algébriquement les pourcentages de variance expliqués par les coefficients partiels pour tenter de reconstituer le $R^2$ global du modèle. Cette démarche est fausse : en raison de la variance partagée non assignable individuellement, la somme des carrés des coefficients de corrélation semi-partielle est presque toujours inférieure au $R^2$ global d’ajustement.
De même, il est fallacieux de conclure à l’inutilité théorique d’un prédicteur sous le seul prétexte que son coefficient de régression partielle n’atteint pas le seuil de significativité statistique ($p > 0{,}05$). Si ce prédicteur partage une fraction massive d’information avec un autre prédicteur lui-même significatif, leur collinéarité bilatérale fragmente leur variance d’échantillonnage respective sans signifier pour autant que la variable est dénuée de valeur prédictive. L’analyste doit impérativement confronter les corrélations brutes d’ordre zéro et les coefficients partiels avant de rejeter un facteur de son cadre d’analyse conceptuel.
12. 12. Synthèse et recommandations pour les chercheurs en sciences humaines
12.1 Guide méthodologique pour le choix des covariables
La construction d’un modèle de régression multiple performant ne doit jamais résulter d’une accumulation opportuniste et désordonnée de toutes les variables disponibles dans la base de données. L’accumulation aveugle de prédicteurs sans fondement théorique précis dégrade la parcimonie scientifique (rasoir d’Ockham), dilapide les degrés de liberté résiduels et augmente les risques d’artefacts collinéaires. Le chercheur doit sélectionner ses variables explicatives à la lumière d’une revue exhaustive de la littérature spécialisée et d’hypothèses conceptuelles explicites rédigées en amont du recueil des données.
Il est fondamental de classifier a priori les variables introduites :
- Les prédicteurs fondamentaux (variables focales de l’étude dont on souhaite éprouver directement le pouvoir explicatif).
- Les variables de contrôle de statut (données sociodémographiques récurrentes comme l’âge ou le niveau de diplôme).
- Les variables d’exposition environnementale ou clinique concomitante.
Cette réflexion doit conduire à l’enregistrement préalable des hypothèses d’ajustement méthodologique (preregistration sur des plateformes comme l’Open Science Framework), afin d’immuniser l’équipe de recherche contre le risque d’exploration opportuniste des données (p-hacking) par l’ajout arbitraire de covariables jusqu’à l’obtention d’un seuil jugé significatif.
12.2 Bonnes pratiques de reporting selon les normes APA 7
La transmission claire et transparente des données quantitatives constitue un pilier de l’intégrité de la communication scientifique. Selon les préconisations formelles de la septième édition du manuel de style de l’APA, toute communication relative à une analyse de régression linéaire multiple doit satisfaire à des critères rigoureux de transparence documentaire. L’analyste ne saurait se borner à mentionner de manière vague que « l’effet s’est avéré significatif » ; il doit fournir une synthèse tabulaire complète permettant une vérification indépendante de ses conclusions.
Le tableau de synthèse de régression doit obligatoirement inclure :
- Les coefficients de régression non standardisés ($B$) assortis de leur erreur type d’échantillonnage ($\text{SE}$).
- Les coefficients de régression partielle standardisés ($\beta$).
- La valeur exacte de la statistique de test ($t$ de Student) et le niveau de significativité exact (mentionner $p = 0{,}023$ plutôt qu’un résultat binaire comme $p < 0{,}05$).
- Les bornes inférieures et supérieures de l’intervalle de confiance à 95 % associées à la métrique brute ($B$).
- Les diagnostics de multicolinéarité formels, incluant au minimum le Facteur d’Inflation de la Variance ($VIF$) ou l’indice de tolérance.
- Les indices de qualité d’ajustement macroscopiques : coefficient de détermination global ($R^2$), $R^2$ ajusté pour les degrés de liberté, et statistique globale de Fisher ($F$) accompagnée de ses degrés de liberté résiduels.
12.3 Perspectives et ouvertures vers les modèles non linéaires
Si le coefficient de régression partielle demeure l’un des piliers analytiques des sciences quantitatives modernes, il ne saurait être considéré comme une fin méthodologique absolue. L’hypothèse fondamentale de linéarité stricte montre rapidement ses limites face à la complexité des systèmes psychologiques, sociologiques et neurobiologiques, dont les trajectoires empruntent souvent des dynamiques curvilignes, de saturation progressive ou de seuils critiques discrets. L’interprétation d’un coefficient linéaire constant sur toute l’étendue de l’échelle d’observation s’avère alors réductrice et potentiellement biaisée.
Pour dépasser ce cadre sans renoncer à la richesse de la partialité statistique, les chercheurs se tournent désormais vers des modélisations plus flexibles. Les Modèles Additifs Généralisés (GAM) permettent ainsi d’estimer des fonctions de lissage non paramétriques pour capturer des relations non linéaires tout en maintenant le principe d’un ajustement additif partiel pour l’ensemble des autres covariables. De façon similaire, les régressions logistiques, les modèles à risques proportionnels de Cox et les régressions multinomiales étendent le concept de coefficient partiel à des variables critères catégorielles ou de survie, sous la forme d’effets conditionnels exprimés en rapports de cotes (Odds Ratios) ou en rapports de risque (Hazard Ratios). Loin d’être dépassé, le coefficient de régression partielle demeure ainsi le socle conceptuel et formel indispensable sur lequel s’édifient toutes ces méthodologies avancées.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Belsley, D. A., Kuh, E., & Welsch, R. E. (2005). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Frisch, R., & Waugh, F. V. (1933). Partial time regressions as compared with individual trends. Econometrica, 1(4), 387–401. https://doi.org/10.2307/1907330
- Galton, F. (1886). Regression towards mediocrity in hereditary stature. The Journal of the Anthropological Institute of Great Britain and Ireland, 15, 246–263. https://doi.org/10.2307/2841583
- Hastie, T. J., & Tibshirani, R. J. (1990). Generalized additive models. Chapman and Hall/CRC.
- Hayes, A. F. (2018). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (2nd ed.). The Guilford Press.
- Kline, R. B. (2023). Principles and practice of structural equation modeling (5th ed.). The Guilford Press.
- Lovell, M. C. (1963). Seasonal adjustment and other data transformations. Journal of the American Statistical Association, 58(304), 993–1010. https://doi.org/10.1080/01621459.1963.10480682
- Pearl, J. (2009). Causality: Models, reasoning, and inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Pearson, K. (1896). Mathematical contributions to the theory of evolution. III. Regression, heredity, and panmixia. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 187, 253–318. https://doi.org/10.1098/rsta.1896.0007
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.
- Yule, G. U. (1897). On the theory of correlation. Journal of the Royal Statistical Society, 60(4), 812–854. https://doi.org/10.2307/2979746
- Yule, G. U. (1907). On the theory of correlation for any number of variables, treated by a new system of notation. Proceedings of the Royal Society of London. Series A, Containing Papers of a Mathematical and Physical Character, 79(529), 182–193. https://doi.org/10.1098/rspa.1907.0028