
L’analyse exploratoire et inférentielle des données quantitatives repose traditionnellement sur l’estimation conjointe des indices de tendance centrale et des paramètres de dispersion. Toutefois, cantonner la caractérisation d’un échantillon à sa seule moyenne arithmétique et à son écart-type occulte une dimension fondamentale de la morphologie distributionnelle : la forme même de la courbe de densité empirique. Dans les disciplines expérimentales, biométriques et psychométriques, la symétrie parfaite postulée par le modèle théorique de la loi normale de Laplace-Gauss constitue une exception plutôt qu’une régularité empirique. La quantification rigoureuse de la déviation par rapport à cette symétrie s’avère indispensable pour garantir la validité méthodologique des inférences statistiques ultérieures.
Le pionnier de la statistique mathématique moderne, Karl Pearson, a formalisé dès la fin du XIXe siècle les instruments analytiques permettant de capturer précisément les distorsions unilatérales des distributions de probabilité. Les coefficients d’asymétrie de Pearson, déclinés principalement sous deux formulations complémentaires exploitant le mode et la médiane, fournissent une lecture intuitive et mathématiquement robuste de la dérive des observations vers les valeurs inférieures ou supérieures d’une échelle. Contrairement aux approches basées sur le calcul des moments centrés d’ordre trois — qui s’avèrent hypersensibles aux valeurs aberrantes —, les indices de Pearson offrent un éclairage fondé sur l’écartement spatial relatif entre les barycentres de position.
Dans l’écosystème contemporain du traitement des données, le logiciel Microsoft Excel demeure un outil omniprésent au sein des laboratoires universitaires, des instituts d’évaluation clinique et des départements d’études quantitatives. Si le tableur intègre nativement des fonctions calculant le troisième moment standardisé ajusté, la mise en œuvre pas-à-pas des coefficients originaux de Karl Pearson constitue une démarche heuristique et diagnostique d’une valeur inestimable. Ce guide exhaustif propose une déconstruction théorique, computationnelle et interprétative complète du coefficient d’asymétrie de Pearson dans Excel, articulant rigueur mathématique, contextualisation psychométrique et maîtrise technique des fonctions avancées du tableur.
1. Introduction aux mesures d’asymétrie et fondements théoriques de Karl Pearson
1.1 Définition mathématique et conceptuelle de l’asymétrie statistique
L’asymétrie statistique, universellement désignée sous l’anglicisme skewness dans la littérature spécialisée, traduit le défaut de symétrie spéculaire d’une distribution de probabilité par rapport à un axe vertical passant par sa valeur centrale. Sur le plan géométrique, lorsque l’on observe la courbe de densité théorique ou l’histogramme de fréquences d’une variable aléatoire continue, la symétrie implique que la probabilité d’observer une déviation d’une amplitude donnée à gauche du centre est strictement identique à la probabilité d’observer cette même déviation à droite. Mathématiquement, pour une variable aléatoire $X$ d’espérance $\mu$, la fonction de densité $f(x)$ d’une distribution parfaitement symétrique vérifie rigoureusement la relation $f(\mu – x) = f(\mu + x)$ pour tout réel $x$. Dès lors que cette égalité fonctionnelle est violée, la distribution présente une asymétrie qui nécessite une quantification scalaire.
Dans les distributions asymétriques empiriques, l’équilibre barycentrique est rompu. La présence d’une queue de distribution anormalement étirée vers les valeurs positives (asymétrie à droite ou asymétrie positive) ou vers les valeurs négatives (asymétrie à gauche ou asymétrie négative) exerce une force de traction différentielle sur les paramètres de position. La moyenne arithmétique, en sa qualité de centre de gravité mathématique minimisant la somme des écarts quadratiques, est fortement attirée vers les valeurs extrêmes situées dans la traîne de la distribution. En revanche, le mode — qui matérialise le sommet de la courbe de densité ou la modalité de fréquence maximale — demeure ancré dans la zone de plus forte concentration des observations. La médiane, quant à elle, sépare l’échantillon ordonné en deux proportions égales de 50 %, adoptant une position intermédiaire d’une grande stabilité métrologique.
Cette dissociation spatiale entre moyenne, médiane et mode modifie en profondeur la représentativité des paramètres descriptifs usuels. Lorsqu’une distribution est marquée par une asymétrie prononcée, rapporter la seule moyenne arithmétique induit une distorsion cognitive majeure de la réalité clinique ou expérimentale. La moyenne ne correspond plus alors à une valeur représentative du sujet typique, mais reflète l’artefact arithmétique d’une minorité d’observations dispersées dans l’extrémité de la traîne. Dès lors, la quantification de l’asymétrie ne relève pas d’une simple curiosité descriptive, mais constitue un prérequis incontournable à toute modélisation sérieuse des données réelles.
1.2 Contribution historique et biostatistique de Karl Pearson
L’émergence des statistiques de forme est indissociable de la révolution biométrique initiée en Angleterre à la fin de l’ère victorienne. Sous l’impulsion de personnalités scientifiques telles que Francis Galton, W.F.R. Weldon et surtout Karl Pearson au sein de l’University College de Londres, l’objectif fondamental était d’élaborer un cadre mathématique rigoureux capable de formaliser les mécanismes de la variation biologique et de l’évolution darwinienne. En étudiant les dimensions corporelles chez les crustacés, les mesures crâniennes ou les caractéristiques morphologiques humaines, Pearson s’est heurté à un obstacle épistémologique majeur : la quasi-totalité des phénomènes vivants réfute l’hypothèse de stricte normalité gaussienne introduite par Carl Friedrich Gauss et Adolphe Quetelet.
Pearson a compris que la non-normalité n’était pas un simple bruit de mesure ou une imperfection de collecte, mais une propriété biologique fondamentale de la variabilité intraspécifique. Dans son monumental mémoire publié en 1895 dans les Philosophical Transactions of the Royal Society sous le titre Contributions to the Mathematical Theory of Evolution, Pearson a formalisé son célèbre système de distributions continues (le système des courbes de Pearson). Ce système englobe une diversité de familles morphologiques régies par une équation différentielle unifiée, dont la classification repose directement sur quatre moments statistiques fondamentaux : la moyenne (premier moment), la variance (second moment centré), l’asymétrie (troisième moment) et l’aplatissement ou kurtosis (quatrième moment).
C’est dans ce contexte effervescent que Pearson a conçu ses deux indicateurs pragmatiques d’asymétrie. Conscient que le calcul des moments d’ordre supérieur posait de redoutables difficultés computationnelles aux chercheurs de l’époque — qui réalisaient tous les calculs manuellement ou à l’aide de tables logarithmiques —, Pearson a cherché une métrique adimensionnelle, standardisée et directement dérivable des statistiques de position élémentaires. En observant que l’écartement entre la moyenne et le mode d’une part, et entre la moyenne et la médiane d’autre part, augmentait proportionnellement à l’étirement unilatéral des distributions de sa famille de courbes, il a jeté les bases du premier et du second coefficient d’asymétrie qui portent aujourd’hui son nom.
1.3 Rôle de la quantification de l’asymétrie dans la modélisation des données
Dans l’arsenal méthodologique du chercheur contemporain, la vérification de la forme distributionnelle représente une étape charnière du conditionnement statistique. La plupart des procédures inférentielles dites paramétriques — au premier rang desquelles figurent le test $t$ de Student pour échantillons appariés ou indépendants, l’analyse de variance univariée et factorielle (ANOVA), la régression linéaire ordinaire (MCO) et la modélisation par équations structurelles — reposent sur le postulat d’une distribution normale des erreurs ou des variables dépendantes dans la population d’origine.
L’ignorance délibérée ou accidentelle d’une asymétrie substantielle dans un ensemble de données engendre des conséquences préjudiciables sur la validité interne des conclusions scientifiques. D’une part, l’asymétrie affecte directement le taux d’erreur de première espèce ($\alpha$), provoquant soit une inflation de faux positifs, soit une perte dramatique de puissance statistique ($1 – \beta$). Dans les contextes où l’asymétrie est sévère, l’estimateur des moindres carrés perd son statut d’efficacité asymptotique, et les intervalles de confiance construits autour des paramètres estimés deviennent asymétriques et trompeurs en termes de couverture probabiliste nominale.
Sur le plan de l’analyse exploratoire, la quantification du coefficient d’asymétrie guide la sélection rationnelle des transformations mathématiques destinées à restaurer la symétrie. Face à une distribution montrant une forte asymétrie positive, l’analyste pourra légitimement tester une transformation logarithmique, une transformation racine carrée ou une procédure algorithmique paramétrique de type Box-Cox. Le coefficient d’asymétrie de Pearson sert ici de thermomètre métrologique : calculé avant et après manipulation numérique, il atteste formellement de l’efficacité de la normalisation opérée, garantissant que les données transformées satisfont désormais aux exigences formelles des modélisations ultérieures.
2. Les deux formulations mathématiques du coefficient d’asymétrie de Pearson
2.1 Premier coefficient d’asymétrie de Pearson basé sur le mode
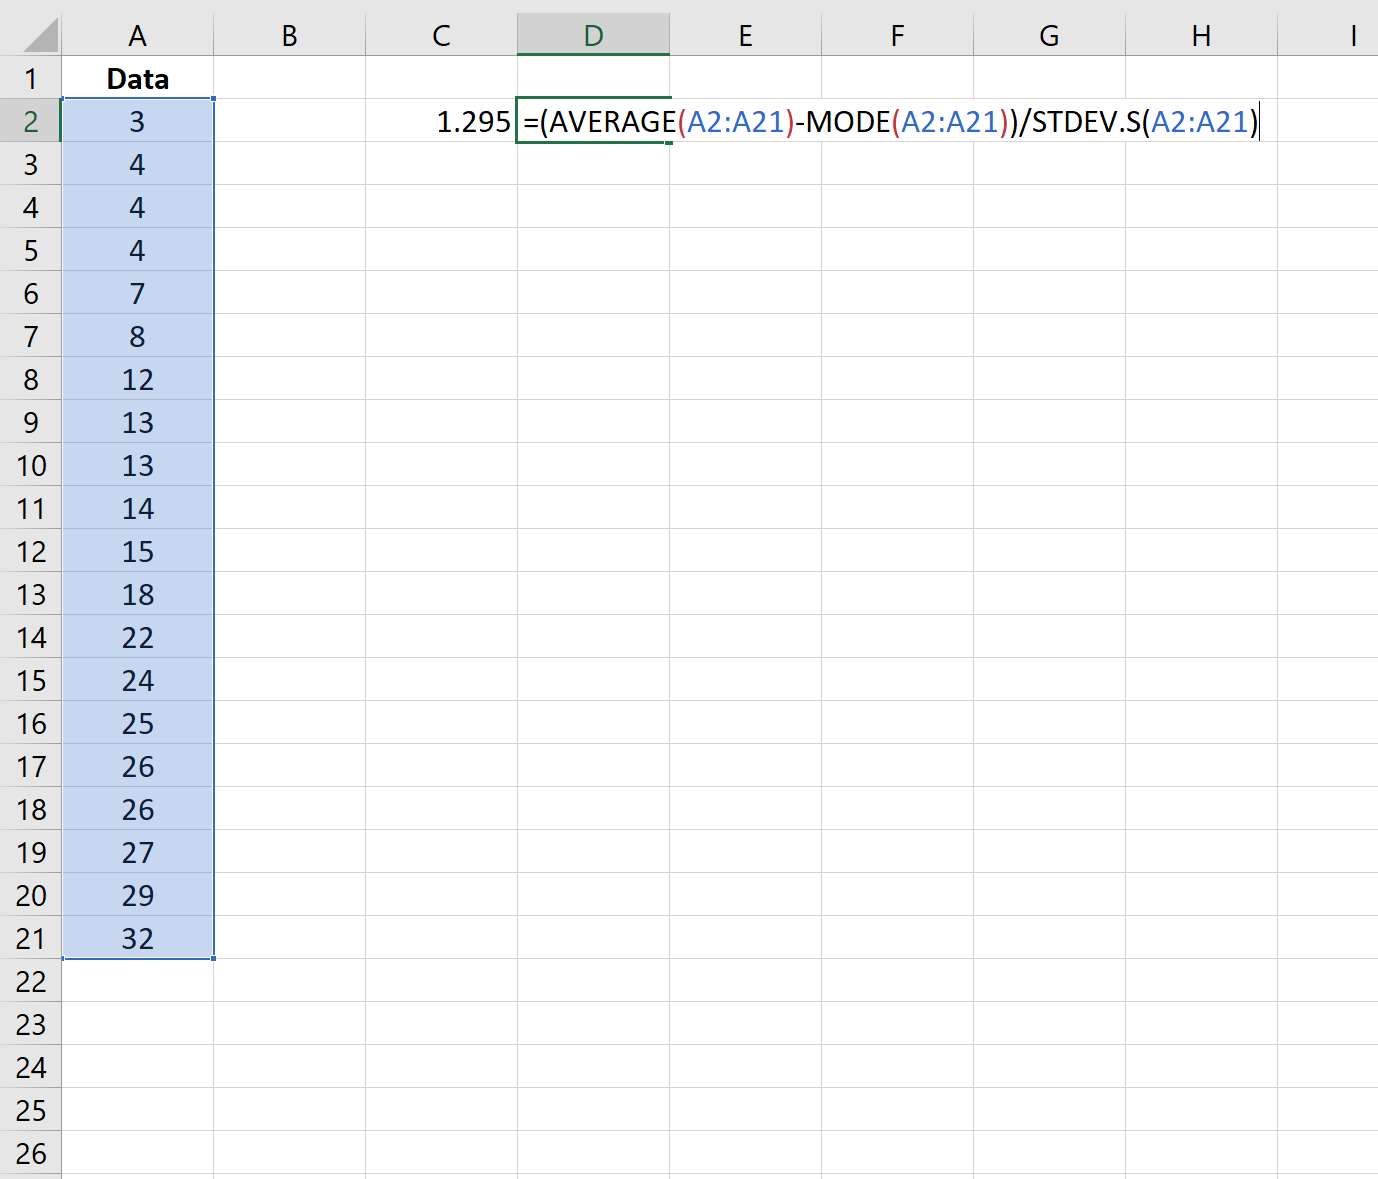
Le premier coefficient d’asymétrie développé par Karl Pearson, historiquement désigné comme le coefficient mode-moyenne, formalise la dissymétrie à travers la divergence absolue entre la moyenne arithmétique d’un échantillon et son mode empirique, rapportée à la variabilité globale de l’échantillon. Son expression analytique fondamentale s’écrit formellement comme suit :
$$Sk_1 = \frac{\bar{X} – \text{Mod}}{s}$$
Dans cette formulation, $\bar{X}$ représente la moyenne arithmétique de la variable étudiée au sein de l’échantillon d’observations, $\text{Mod}$ correspond à la valeur modale identifiée (le score présentant la fréquence d’apparition la plus élevée), et $s$ désigne l’écart-type d’échantillon corrigé (estimateur non biaisé de l’écart-type de la population). L’intuition mathématique sous-jacente est particulièrement élégante : dans une distribution strictement unimodale et symétrique, la moyenne arithmétique coïncide théoriquement de manière exacte avec le sommet de la courbe de densité, rendant le numérateur $(\bar{X} – \text{Mod})$ strictement nul, ce qui produit un coefficient $Sk_1 = 0$.
L’intégration de l’écart-type $s$ au dénominateur assure une normalisation dimensionnelle impérative. En divisant une différence exprimée dans l’unité de mesure originale de la variable (par exemple des millisecondes, des points d’anxiété ou des concentrations sanguines) par la dispersion exprimée dans cette même unité, le coefficient d’asymétrie devient un nombre pur, adimensionnel. Cette propriété d’invariance d’échelle permet aux statisticiens de comparer directement l’asymétrie de distributions mesurées sur des métriques incomparables, par exemple en confrontant l’asymétrie d’un temps de réaction chronométrique à celle d’une échelle psychométrique ordinale.
Cependant, le premier coefficient de Pearson souffre d’une faiblesse opérationnelle liée à la nature stochastique du mode. L’estimation du mode dans un échantillon de taille modeste présente une forte instabilité d’échantillonnage, la fréquence maximale pouvant basculer d’une valeur à l’autre sous l’effet de fluctuations aléatoires mineures. De surcroît, dans les distributions continues où chaque valeur observée est susceptible d’être unique en raison de la précision des instruments de mesure, l’identification d’un mode discontinu devient mathématiquement illégitime sans une discrétisation préalable en intervalles de classes, introduisant une part indésirable d’arbitraire.
2.2 Second coefficient d’asymétrie de Pearson basé sur la médiane
Conscient des écueils inhérents à l’instabilité du mode, Pearson a dérivé une seconde formulation, largement plus répandue dans les applications pratiques et l’ingénierie quantitative : le coefficient d’asymétrie basé sur la médiane. Ce second indicateur tire parti d’une propriété géométrique et analytique remarquable établie au sein de la famille des courbes unimodales modérément asymétriques. L’expression analytique du second coefficient s’énonce selon la relation canonique :
$$Sk_2 = \frac{3 \cdot (\bar{X} – \text{Med})}{s}$$
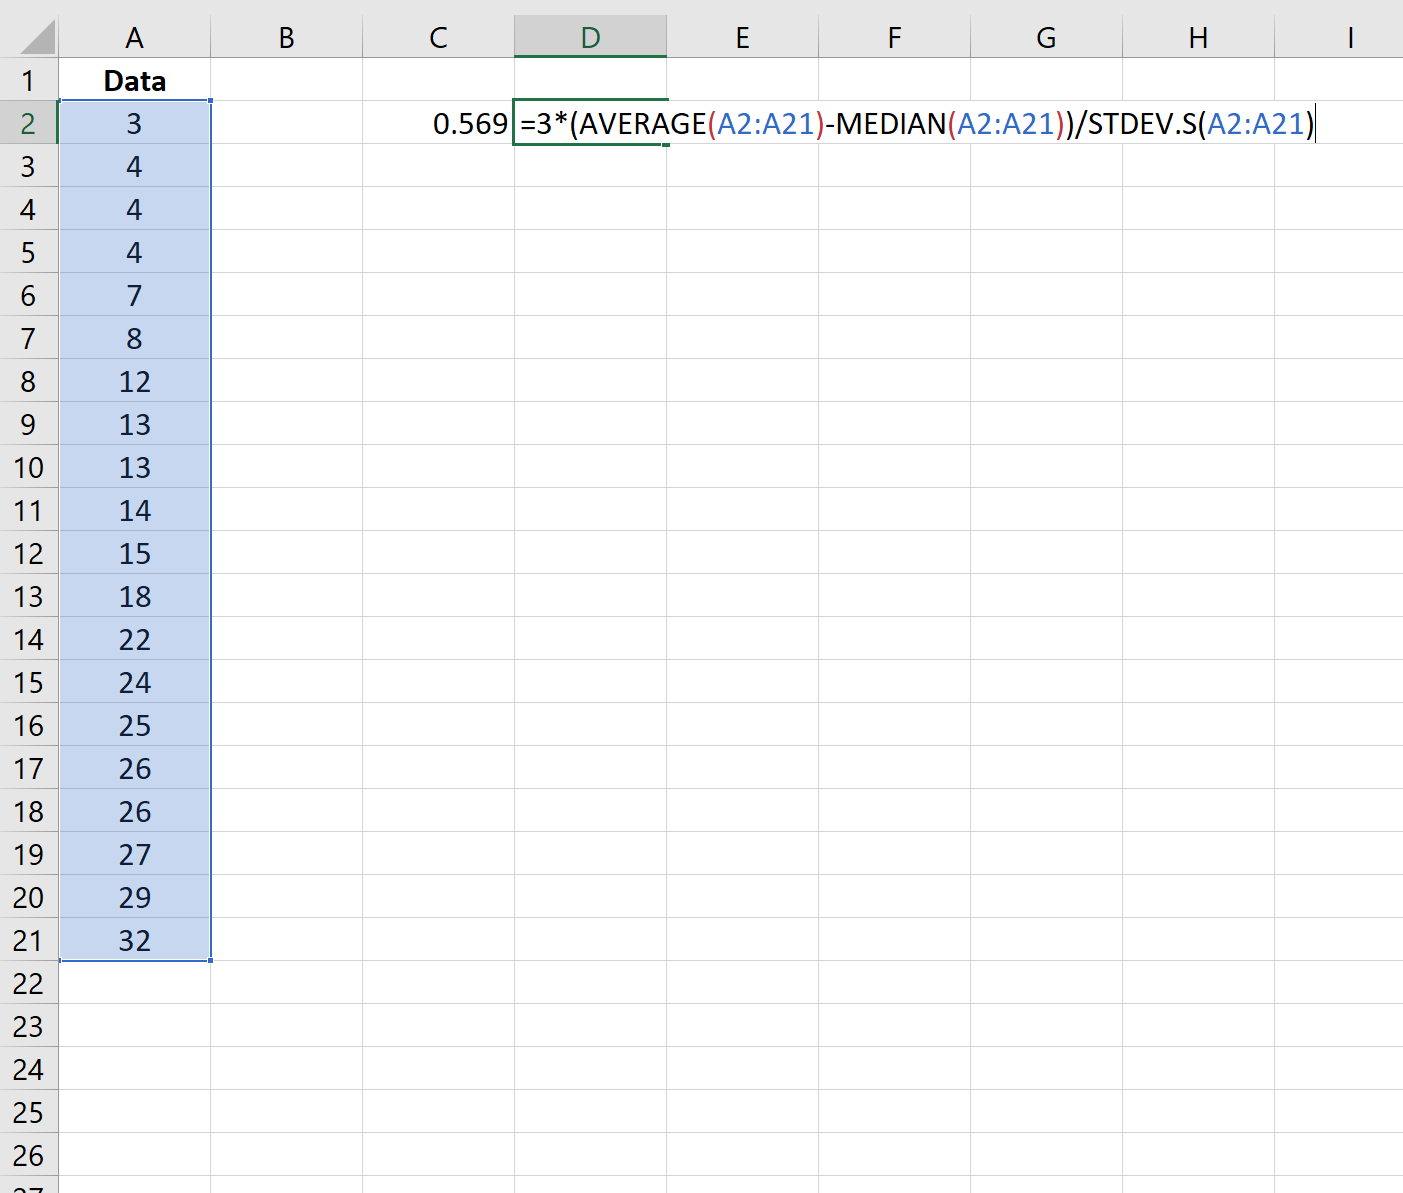
Où $\text{Med}$ désigne la médiane de l’échantillon ordonné, tandis que $\bar{X}$ et $s$ conservent leur signification respective de moyenne et d’écart-type. L’élément théorique le plus remarquable réside dans la présence du facteur multiplicateur scalaire égal à 3. L’origine de ce coefficient multiplicateur procède d’une approximation empirique et analytique initialement documentée par Pearson : dans les distributions continues univariées modérément asymétriques, la médiane se situe approximativement aux deux tiers de la distance séparant le mode de la moyenne en partant du mode, ce qui se formalise par la relation approximative $(\bar{X} – \text{Mod}) \approx 3 \cdot (\bar{X} – \text{Med})$. En substituant cette équivalence au sein du premier coefficient, Pearson a forgé un estimateur alternatif d’une remarquable élégance mathématique.
La supériorité computationnelle et pratique de cette seconde formulation réside dans la stabilité intrinsèque de la médiane. Contrairement au mode, la médiane constitue un estimateur à point de rupture élevé (50 %), ce qui signifie qu’elle ne peut être corrompue que par la contamination de la moitié des observations d’un échantillon. De plus, la médiane possède une existence mathématique garantie et une unicité systématique au sein de toute série numérique unidimensionnelle ordonnée, contournant définitivement les problèmes d’inexistence du mode ou de multimodalité empirique.
2.3 Propriétés d’échelle et invariance mathématique
Sur le plan formel des transformations algébriques, les deux coefficients d’asymétrie de Pearson vérifient des propriétés d’invariance fondamentales qui consolident leur statut de mesures de forme canoniques. Considérons une transformation affine positive d’une variable aléatoire $X$, définie par la fonction $Y = aX + b$, où $a$ et $b$ sont des constantes réelles avec la contrainte stricte que le coefficient de dilatation $a$ soit strictement supérieur à zéro ($a > 0$). Le comportement des paramètres constitutifs des formules s’établit comme suit :
- La moyenne de la variable transformée devient : $\bar{Y} = a\bar{X} + b$.
- Le mode de la variable transformée devient : $\text{Mod}_Y = a\text{Mod}_X + b$.
- La médiane de la variable transformée devient : $\text{Med}_Y = a\text{Med}_X + b$.
- L’écart-type d’échantillon devient : $s_Y = a \cdot s_X$ (la constante additive $b$ s’annulant par centrage).
Lors du calcul du coefficient d’asymétrie sur la variable transformée $Y$, la constante d’origine $b$ s’élimine instantanément par la soustraction au numérateur : $(\bar{Y} – \text{Med}_Y) = (a\bar{X} + b) – (a\text{Med}_X + b) = a(\bar{X} – \text{Med}_X)$. En rapportant cette quantité au dénominateur transformé $s_Y = a \cdot s_X$, le facteur scalaire d’échelle $a$ se simplifie rigoureusement au numérateur et au dénominateur :
$$Sk_2(Y) = \frac{3 \cdot a(\bar{X} – \text{Med}_X)}{a \cdot s_X} = \frac{3 \cdot (\bar{X} – \text{Med}_X)}{s_X} = Sk_2(X)$$
Cette invariance absolue par transformation affine positive démontre que les coefficients de Pearson sont insensibles à la fois au changement d’origine (translation par $b$) et au changement d’échelle de mesure (dilatation ou contraction par $a$). En revanche, si la transformation affine implique un coefficient multiplicateur strictement négatif ($a < 0$), ce qui correspond à une inversion géométrique de l'orientation de l'axe, le coefficient d'asymétrie change exactement de signe sans modifier sa valeur absolue : $Sk(-X) = -Sk(X)$. Ce comportement algébrique parfaitement cohérent garantit que la métrique préserve fidèlement la polarité de l'inclinaison directionnelle de la distribution.
3. Comparaison critique : méthode du mode contre méthode de la médiane
3.1 Limites inhérentes à l’utilisation du mode
L’utilisation pratique du premier coefficient d’asymétrie de Karl Pearson — articulé autour de la valeur modale — se heurte à des obstacles structurels majeurs dans le contexte du traitement computationnel moderne des données quantitatives. La première difficulté méthodologique réside dans la vulnérabilité de la détermination du mode face aux variations de maillage et de discrétisation. Au sein d’un échantillon continu, la probabilité théorique qu’une valeur se reproduise de manière exactement identique tend vers zéro. Le mode empirique brut ne peut alors être extrait qu’à travers une classification artificielle en intervalles d’égales largeurs (bins), une opération dont les frontières arbitraires influencent lourdement l’emplacement final du sommet modal.
Un second écueil rédhibitoire concerne l’absence fréquente d’unicité modale. Les distributions réelles observées en psychologie, en biologie ou en économie manifestent régulièrement des profils bimodaux ou multimodaux. Face à une distribution présentant deux pics d’égale amplitude — ce qui se produit par exemple lors du mélange latent de deux sous-populations physiologiques distinctes (hommes et femmes, témoins et cliniques) —, le numérateur du premier coefficient de Pearson devient indéterminé. Le calcul perd toute validité conceptuelle, le mode ne pouvant résumer un pic unique qui servirait de référence univoque.
Enfin, le mode s’avère incapable de refléter le barycentre global de la masse distributionnelle. Par nature, le mode constitue une mesure exclusivement locale : il indique le point d’inflexion maximal sans tenir compte de la configuration ou de la répartition spatiale du reste des observations. Un échantillon de taille $N = 100$ peut comporter un mode unique situé à $X = 10$ simplement parce que cette valeur particulière apparaît trois fois, tandis que l’intégralité des 97 autres observations est dispersée de façon homogène entre $50$ et $100$. Dans une telle configuration, ancrer l’analyse d’asymétrie sur ce mode local génère une estimation totalement biaisée et déconnectée de la géométrie globale des données.
3.2 Avantages psychométriques et statistiques du recours à la médiane
Face aux apories du mode, l’adoption de la médiane au sein du second coefficient d’asymétrie de Pearson offre des garanties statistiques d’un niveau nettement supérieur. Le premier avantage réside dans l’existence et l’unicité mathématique du cinquantième centile. Pour tout ensemble de données comportant $N$ observations univariées, ordonnées selon une relation d’ordre naturelle, la médiane est toujours définie de manière univoque, qu’il s’agisse de la valeur centrale exacte (pour $N$ impair) ou de la demi-somme des deux observations centrales (pour $N$ pair). Cette propriété fondamentale élimine structurellement tout risque d’indétermination numérique au sein des scripts de calcul automatisés dans des logiciels comme Excel.
Sur le plan psychométrique, la médiane offre une concordance exceptionnelle avec les propriétés de mesure des échelles fréquemment administrées en sciences du comportement. Les instruments d’évaluation clinique, les inventaires de personnalité ou les échelles de type Likert génèrent des données de niveau strictement ordinal ou quasi-d’intervalle. Dans ce cadre épistémologique précis, la médiane respecte fidèlement les propriétés topologiques des scores ordonnés sans postuler une métrique continue parfaite. De plus, sa résistance aux perturbations locales la rend insensible aux dérives causées par des erreurs de saisie sporadiques ou des comportements aberrants de passation.
Dans l’analyse expérimentale des latences motrices et cognitives (temps de réaction chronométriques), la médiane est universellement privilégiée par la communauté des neurosciences et de la psychologie cognitive. Sachant que ces chronométries intègrent inévitablement des décrochages attentionnels matérialisés par des temps de réponse disproportionnellement longs, la médiane offre une ancre centrale robuste. L’estimation du second coefficient d’asymétrie de Pearson permet alors de capturer fidèlement la dynamique de l’effort cognitif sans que l’indicateur ne soit artificiellement corrompu par deux ou trois essais déviants au sein du protocole d’enregistrement.
3.3 Critères de sélection de la formule appropriée selon les données
Le choix entre le premier et le second coefficient d’asymétrie de Pearson ne doit pas être laissé au hasard, mais doit découler d’un diagnostic formel de la morphologie distributionnelle de la variable étudiée. Le tableau synthétique suivant explicite les critères d’arbitrage méthodologique recommandés en statistique appliquée :
| Critère d’évaluation | Premier coefficient (Mode) | Second coefficient (Médiane) |
|---|---|---|
| Nature de la distribution | Unimodale stricte, continue, fortement concentrée. | Unimodale à modérément asymétrique, continue ou discrète. |
| Sensibilité aux valeurs extrêmes | Modérée sur le mode, mais forte sur la moyenne et l’écart-type. | Excellente robustesse du centile 50 %, équilibre optimal. |
| Taille d’échantillon recommandée | $N > 200$ pour stabiliser l’estimation modale. | Applicable dès $N ge 15$, stable pour tout échantillon. |
| Comportement computationnel dans Excel | Risque élevé d’erreur d’exécution #N/A. |
Stabilité absolue, calcul déterministe garanti sans erreur. |
| Recommandation académique globale | Usage marginal, réservé aux distributions théoriques lissées. | Choix canonique recommandé en psychométrie et sciences empiriques. |
Au regard des standards contemporains de la recherche expérimentale et des recommandations de l’American Psychological Association (APA), l’usage de la formulation fondée sur la médiane ($Sk_2$) s’impose de façon préférentielle. Sauf justification théorique impérative réclamant explicitement l’isolement du mode, l’analyste quantitative doit systématiquement privilégier la seconde formule de Pearson lors de l’implémentation opérationnelle sous tableur.
4. Pertinence de l’asymétrie de Pearson en recherche psychologique et psychométrique
4.1 Phénomènes d’effets plancher et d’effets plafond
L’évaluation psychométrique et clinique est intrinsèquement confrontée à des contraintes de calibration instrumentale qui se manifestent fréquemment par des déformations unilatérales des distributions observées. L’un des phénomènes les plus documentés est celui de l’effet plancher (floor effect). Cet artefact métrologique se manifeste lorsqu’un instrument d’évaluation présente un niveau de difficulté disproportionné par rapport aux capacités de la cohorte évaluée, ou lorsqu’il quantifie une pathologie à très faible prévalence dans un échantillon non clinique issu de la population générale. Dans ce cas, une écrasante majorité des participants accumule les scores minimaux possibles de l’échelle, engendrant une barrière infranchissable à gauche.
Du point de vue distributionnel, l’effet plancher engendre une asymétrie positive prononcée : la masse des observations est comprimée contre la borne inférieure gauche de l’abscisse, tandis qu’une minorité d’individus symptomatiques s’étire dans une longue traîne vers les valeurs élevées de l’échelle. Le calcul du coefficient d’asymétrie de Pearson fournit alors une quantification précise du degré de saturation bas de l’outil, alertant le clinicien sur la perte de sensibilité différentielle du test dans les zones non pathologiques.
À l’inverse, l’effet plafond (ceiling effect) survient lorsqu’un test d’aptitude cognitive, neuropsychologique ou d’acquisition pédagogique s’avère excessivement aisé pour la population cible. Les scores s’accumulent alors massivement contre la borne supérieure maximale de l’instrument, créant une compression à droite et une traîne d’individus en difficulté qui s’étire vers les valeurs faibles. Il en résulte une asymétrie négative marquée. L’asymétrie de Pearson devient ainsi un indice de diagnostic métrologique essentiel lors de la phase de validation de contenu et d’étalonnage d’un questionnaire, révélant si les items possèdent un pouvoir discriminant suffisant sur l’ensemble du spectre d’aptitude latente.
4.2 Distributions des temps de réaction et variables comportementales
En neuropsychologie cognitive et en chronométrie mentale, l’étude de la latence comportementale — mesurée entre l’apparition d’un stimulus perceptif et le déclenchement d’une réponse motrice — offre une illustration paradigmatique de non-normalité structurelle. Les chronométries mentales ne suivent en aucun cas une distribution gaussienne symétrique : elles obéissent naturellement à des familles de lois asymétriques à queue droite lourde, telles que la distribution ex-gaussienne, la loi de Wald (distribution gaussienne inverse) ou la loi Gamma.
Cette asymétrie positive intrinsèque s’explique par des contraintes biologiques et computationnelles incompressibles. Il existe une barrière physiologique absolue en deçà de laquelle aucun influx nerveux ne peut se propager (typiquement 100 à 150 millisecondes pour un temps de réaction simple), interdisant toute dispersion vers la gauche. En revanche, les défaillances momentanées du contrôle attentionnel exécutif, les micro-somnolences ou les fluctuations de la charge mentale provoquent régulièrement des réponses ralenties étalées dans une très longue traîne vers la droite, pouvant atteindre plusieurs milliers de millisecondes.
L’utilisation du coefficient d’asymétrie de Pearson dans l’analyse de ces chronométries comportementales remplit une double mission. Premièrement, elle permet de caractériser quantitativement la stabilité attentionnelle d’un sujet ou d’un groupe clinique (les patients atteints de trouble déficitaire de l’attention ou de lésions frontales présentant généralement une asymétrie positive beaucoup plus explosive que les témoins sains). Deuxièmement, la magnitude de ce coefficient guide le choix d’une transformation d’assainissement préalable : une valeur d’asymétrie de Pearson modérée orientera vers une transformation racine carrée, tandis qu’une asymétrie sévère légitimera une transformation logarithmique népérienne ($LN$) ou inverse ($1/X$).
4.3 Échelles d’attitudes et questionnaires de personnalité
Dans l’évaluation de la personnalité et des attitudes sociopsychologiques à travers des questionnaires auto-rapportés (auto-évaluations sur échelles de Likert en 5 ou 7 points), la morphologie des réponses est fréquemment altérée par des biais psychosociaux systématiques. Le plus prégnant de ces biais est le biais de désirabilité sociale, qui pousse les répondants à surévaluer leurs comportements pro-sociaux, vertueux ou adaptés, tout en minimisant l’expression de leurs traits indésirables, agressifs ou déviants.
Lorsqu’un inventaire évalue par exemple des traits tels que l’agréabilité, l’honnêteté, l’empathie ou la propension à coopérer, la distribution des réponses présente classiquement une asymétrie négative significative : la majorité des individus se situent spontanément dans le pôle supérieur de l’échelle, créant une queue étirée vers les scores modestes. Inversement, lors de l’évaluation de traits sombres (machiavélisme, psychopathie subclinique) ou d’échelles de détresse affective et idéations suicidaires, la distribution bascule dans une asymétrie positive sévère. Les individus asymptomatiques s’agglutinent sur le score minimal « pas du tout d’accord », et seuls quelques individus en détresse aiguë colonisent l’extrémité supérieure.
Avant d’engager des modélisations dimensionnelles sophistiquées, telles que l’analyse factorielle exploratoire (AFE), l’analyse factorielle confirmatoire (AFC) ou des modèles d’équations structurelles (SEM), le diagnostic d’asymétrie de Pearson est un passage obligé. Lorsque les items manifestent une asymétrie substantielle, l’estimation factorielle classique par le maximum de vraisemblance (ML) génère des matrices de corrélations de Pearson artificiellement atténuées, faussant le nombre de facteurs extraits et gonflant les indices d’ajustement globaux ($Chi^2$, RMSEA). L’identification de ces asymétries via les formules de Pearson alerte le psychomètre sur la nécessité de basculer vers des estimateurs robustes adaptés aux variables ordinales catégorielles, tels que le WLSMV (Weighted Least Squares Mean and Variance adjusted).
5. Préparation de l’environnement de travail et structuration des données dans Excel
5.1 Architecture optimale d’une feuille de calcul pour l’analyse statistique
La mise en œuvre de procédures biométriques et psychométriques au sein de Microsoft Excel requiert une rigueur d’organisation spatiale absolue pour prévenir les erreurs de pointage référentiel et garantir la reproductibilité intégrale des calculs. L’architecture d’un classeur d’analyse statistique doit impérativement respecter le principe de séparation stricte entre la zone des données sources brutes et la zone des calculs analytiques et métadonnées.
Les données empiriques doivent être ordonnées sous le format tabulaire relationnel canonique (tidy data) : chaque ligne horizontale matérialise une unité observationnelle unique (un participant, un patient, une session expérimentale), et chaque colonne verticale correspond à une variable mesurée univoque. La première ligne (ligne 1) est strictement réservée aux en-têtes mnémoniques courts, formulés sans espaces, caractères accentués ou symboles complexes susceptibles d’altérer l’interprétation des plages nommées (par exemple, ID_Sujet, Score_Anxiete, Temps_Reaction).
La zone analytique dédiée aux calculs descriptifs et aux coefficients de Pearson doit être positionnée soit sur une feuille de calcul distincte reliée par des liaisons dynamiques, soit décalée latéralement sur la même feuille (par exemple à partir de la colonne D ou E), en laissant au minimum deux colonnes intercalaires vierges de toute inscription. Il convient de proscrire absolument l’insertion de totaux, de moyennes ou de calculs intermédiaires directement au bas des colonnes de données brutes. Cette pratique néfaste compromet l’automatisation des plages par le biais de formules matricielles dynamiques et augmente drastiquement le risque d’inclure accidentellement les cellules de synthèse dans les arguments des fonctions statistiques.
5.2 Audit de qualité et nettoyage préalable des données
Avant toute implémentation algorithmique, un audit de conformité métrologique s’impose afin d’éliminer les artefacts susceptibles de distordre silencieusement le calcul de la moyenne, de la médiane et de l’écart-type. Les pièges les plus insidieux dans Excel découlent de la présence de valeurs non numériques travesties en texte. Une cellule contenant une chaîne alphanumérique ou un nombre précédé accidentellement d’une apostrophe est ignorée sans message d’alerte par des fonctions comme MOYENNE() et ECARTYPE.STANDARD(), ce qui modifie clandestinement la taille effective de l’échantillon ($N$) prise en compte au dénominateur.
Le protocole d’assainissement doit débuter par l’éradication des espaces insécables (code ASCII 160), très fréquents lors de l’importation de données extraites de logiciels de passation en ligne (Qualtrics, Google Forms, Gorilla). L’utilisation imbriquée des fonctions textuelles =SUPPRESPACE(EPURAGE(A2)) ou la commande « Rechercher et remplacer » permet de purger intégralement la colonne de ces résidus invisibles. Par la suite, il est essentiel de contrôler les frontières théoriques de l’échelle psychométrique administrée par le biais d’une règle de validation des données :
- Sélectionner l’intégralité du vecteur de scores (par exemple
A2:A21). - Accéder à l’onglet Données > Validation des données.
- Définir un critère d’autorisation autorisant uniquement les nombres entiers ou décimaux compris strictement entre le score plancher théorique et le score plafond théorique de l’instrument psychométrique.
Enfin, la gestion des cellules vides requiert une doctrine méthodologique explicite : toute cellule vide doit correspondre à une valeur manquante déclarée et ne doit jamais être assimilée par défaut à un score nul ($0$), sous peine d’injecter artificiellement une asymétrie positive monumentale dans les données.
5.3 Configuration des fonctions et paramètres régionaux d’Excel
L’exécution fiable de protocoles quantitatifs dans Excel exige une vigilance accrue quant à l’harmonisation linguistique et régionale du logiciel. Microsoft Excel adapte le nom de ses fonctions internes et ses séparateurs syntaxiques en fonction des paramètres régionaux définis dans le système d’exploitation de la station de travail. Dans l’environnement francophone standard (France, Belgique, Suisse, Canada francophone), le séparateur décimal conventionnel est la virgule (,), tandis que le séparateur d’arguments au sein des formules mathématiques est le point-virgule (;).
Cette configuration contraste frontalement avec l’environnement anglo-saxon standard où le point (.) matérialise les décimales et la virgule (,) délimite les arguments fonctionnels. Lors de l’importation de fichiers de données sériels (fichiers au format .csv ou .tsv) issus d’environnements expérimentaux programmés en Python ou en R, les décimales matérialisées par des points risquent d’être interprétées par Excel comme de simples dates ou des chaînes de texte non calculables. L’analyste doit impérativement configurer le comportement d’Excel via le menu Fichier > Options > Options avancées > section Options d’édition, en décochant la case « Utiliser les séparateurs système » pour forcer manuellement le séparateur décimal approprié si la conversion n’a pas été exécutée lors de l’importation.
Enfin, il convient de certifier que le mode de calcul du classeur est configuré sur son état nominal standard : Automatique (accessible sous l’onglet Formules > Options de calcul). L’activation accidentelle du mode « Manuel » fige les résultats des formules et bloque l’actualisation dynamique des coefficients de Pearson lors de l’amendement des scores de l’échantillon.
6. Étape 1 : Création et encodage du jeu de données psychologiques dans Excel
6.1 Définition d’un scénario expérimental d’évaluation clinique
Afin de concrétiser les développements théoriques et d’offrir une démonstration empirique reproductible, nous concevons un scénario expérimental issu de la psychopathologie quantitative. Considérons une étude transversale menée au sein d’une clinique universitaire, visant à évaluer le niveau de symptomatologie anxieuse auprès d’un groupe pilote de vingt participants ($N = 20$). Les sujets sont évalués au moyen d’une version validée de l’inventaire d’anxiété situationnelle (échelle continue graduée de $0$ à $60$ points, où un score de $0$ traduit une absence complète de tension anxieuse et un score de $60$ signale une crise panique aiguë).
La cohorte a été recrutée au sein d’un centre d’accueil généraliste, de sorte que la grande majorité des sujets présente des niveaux d’anxiété bas à modérés, tandis qu’une fraction restreinte de patients manifestant des troubles paniques sévères enregistre des scores particulièrement élevés. Cette configuration génère délibérément une distribution asymétrique positive, caractéristique des profils cliniques rencontrés en pratique de terrain. Chaque participant est identifié par un code alphanumérique standardisé garantissant l’anonymisation de l’évaluation.
6.2 Saisie structurée du tableau de données de référence
Ouvrez une nouvelle feuille de calcul dans Microsoft Excel et renommez l’onglet en Pearson_Skewness. Procédez à l’encodage direct des données brutes en respectant l’affectation matricielle suivante : la colonne A accueille l’identifiant du sujet, et la colonne B contient le score d’anxiété mesuré. Saisissez rigoureusement les valeurs numériques telles que répertoriées dans le tableau d’expérimentation ci-dessous :
| Cellule (Ligne) | Colonne A : ID_Participant | Colonne B : Score_Anxiete |
|---|---|---|
| Ligne 2 | SUBJ_01 | 12 |
| Ligne 3 | SUBJ_02 | 14 |
| Ligne 4 | SUBJ_03 | 15 |
| Ligne 5 | SUBJ_04 | 15 |
| Ligne 6 | SUBJ_05 | 16 |
| Ligne 7 | SUBJ_06 | 16 |
| Ligne 8 | SUBJ_07 | 16 |
| Ligne 9 | SUBJ_08 | 17 |
| Ligne 10 | SUBJ_09 | 18 |
| Ligne 11 | SUBJ_10 | 19 |
| Ligne 12 | SUBJ_11 | 20 |
| Ligne 13 | SUBJ_12 | 21 |
| Ligne 14 | SUBJ_13 | 22 |
| Ligne 15 | SUBJ_14 | 24 |
| Ligne 16 | SUBJ_15 | 25 |
| Ligne 17 | SUBJ_16 | 28 |
| Ligne 18 | SUBJ_17 | 32 |
| Ligne 19 | SUBJ_18 | 38 |
| Ligne 20 | SUBJ_19 | 44 |
| Ligne 21 | SUBJ_20 | 52 |
Pour sécuriser les calculs futurs et conférer au classeur un caractère d’ingénierie professionnelle, nous attribuons un nom de plage explicite à ce vecteur de données. Sélectionnez avec votre curseur la plage de cellules B2:B21. Rendez-vous dans la zone de texte située à l’extrême gauche de la barre de formule (la « Zone Nom »), tapez le descripteur univoque ScoresCliniques et validez impérativement en pressant la touche Entrée du clavier. Désormais, toute formule mathématique pourra invoquer directement ce vecteur par l’étiquette ScoresCliniques, garantissant des formules lisibles, élégantes et protégées contre les glissements de références relatifs.
6.3 Visualisation préliminaire de la forme de distribution
Avant d’extraire les paramètres scalaires numériques, il est hautement recommandé d’exécuter une inspection visuelle directe de la forme distributionnelle. Microsoft Excel propose depuis ses versions récentes un type de graphique spécifiquement dédié à cette démarche : l’Histogramme statistique.
Pour générer cette visualisation au sein de votre feuille de calcul :
- Sélectionnez la plage des données brutes
ScoresCliniques(cellulesB2:B21). - Accédez au ruban supérieur d’Excel, cliquez sur l’onglet Insertion, puis au sein du groupe « Graphiques », cliquez sur l’icône Insérer un graphique statistique et sélectionnez l’option Histogramme.
- Un histogramme apparaît instantanément sur la feuille de travail. Pour optimiser sa granularité diagnostique, effectuez un double-clic sur l’axe horizontal (axe des abscisses) pour afficher le volet latéral « Format de l’axe ».
- Sous la section « Options d’axe », activez l’option Largeur des classes et configurez la valeur numérique sur
5,0(ou sélectionnez un nombre fixe de 6 classes).
L’observation du graphique généré est sans ambiguïté : la structure morphologique révèle une accumulation spectaculaire de fréquences dans la portion gauche du graphique (pics massifs entre 15 et 20 points), tandis que la partie droite s’étire dans une longue traîne descendante clairsemée matérialisée par les scores isolés de 38, 44 et 52. Cette asymétrie visuelle confirme la rupture de la symétrie gaussienne et valide empiriquement la pertinence du calcul formel des coefficients d’asymétrie de Pearson.
7. Étape 2 : Calcul du coefficient d’asymétrie de Pearson avec le mode dans Excel
7.1 Calcul des statistiques intermédiaires requises
La résolution analytique du premier coefficient d’asymétrie de Pearson ($Sk_1$) réclame l’estimation préliminaire de trois métriques descriptives fondamentales : la moyenne arithmétique d’échantillon ($\bar{X}$), le mode univarié ($\text{Mod}$) et l’écart-type d’échantillon ($s$). Nous configurons un espace de synthèse au sein de notre feuille de calcul dans les colonnes D et E.
Dans la colonne D, saisissez les libellés identificatoires des paramètres, puis encodez rigoureusement les formules Excel standardisées correspondantes dans la colonne E adjacente :
- En cellule
D2, inscrivezMoyenne (X_bar), puis enE2, entrez la formule :=MOYENNE(ScoresCliniques) - En cellule
D3, inscrivezMode (Mod), puis enE3, entrez la formule :=MODE.SIMPLE(ScoresCliniques) - En cellule
D4, inscrivezEcart-type echantillon (s), puis enE4, entrez la formule :=ECARTYPE.STANDARD(ScoresCliniques)
L’évaluation numérique immédiate par le moteur d’Excel renvoie les grandeurs d’échantillonnage suivantes :
- La moyenne arithmétique s’établit précisément à : $\bar{X} = 22,400$
- Le mode s’établit de manière univoque à : $\text{Mod} = 16,000$ (la valeur 16 étant répétée à 3 reprises au sein de l’échantillon, aux lignes 6, 7 et 8)
- L’écart-type corrigé d’échantillon s’établit à : $s \approx 10,748$ (précisément $10,747827…$)
7.2 Assemblage de la formule du premier coefficient de Pearson
Dès lors que les métriques élémentaires sont extraites, nous pouvons procéder à l’assemblage computationnel de la première formule de Pearson. Dans la cellule D5, tapez le libellé Pearson Skewness 1 (Mode). Deux démarches d’encodage sont envisageables : l’appel direct aux cellules intermédiaires ou l’encapsulation unifiée au sein d’une formule globale autonome.
Si vous référencez directement les cellules de calcul intermédiaires, entrez dans la cellule E5 l’expression syntaxique suivante :
=(E2 - E3) / E4
Si vous souhaitez formaliser une équation autonome intégrale, compacte et indépendante de toute table intermédiaire — ce qui est vivement conseillé dans les tableaux de bord industriels —, saisissez directement en E5 la formulation consolidée :
=(MOYENNE(ScoresCliniques) - MODE.SIMPLE(ScoresCliniques)) / ECARTYPE.STANDARD(ScoresCliniques)
Décomposons rigoureusement la cinématique arithmétique opérée par Excel :
- Le numérateur évalue l’écart brut entre la valeur centrale gravitationnelle et la valeur la plus fréquente : $\bar{X} – \text{Mod} = 22,400 – 16,000 = 6,400$. Le signe positif indique d’emblée que la moyenne est tirée vers le haut par rapport au sommet modal.
- Le dénominateur évalue la dispersion moyenne d’échantillon : $s = 10,748$.
- Le quotient standardisé final s’établit à : $Sk_1 = 6,400 / 10,747827 = 0,595469…$
Arrondi conventionnellement à trois décimales conformément aux standards de publication scientifique, le premier coefficient d’asymétrie de Pearson pour notre jeu de données s’élève à +0,595. Cette valeur positive confirme mathématiquement la présence d’une asymétrie vers la droite.
7.3 Gestion des cas d’erreurs potentielles avec le mode
L’implémentation du premier coefficient de Pearson au sein de feuilles de calcul automatisées présente un risque structurel d’instabilité logicielle lié aux spécificités de la fonction MODE.SIMPLE(). Si l’échantillon soumis à l’évaluation ne comprend aucune valeur dupliquée — ce qui survient de façon systématique lors du traitement de mesures continues hautement précises (comme des mesures physiologiques de cortisol salivaire ou des temps de réponse mesurés au millième de seconde) —, la fonction MODE.SIMPLE() échoue de manière critique et renvoie le code d’erreur standard #N/A (valeur non disponible).
Cette défaillance contamine immédiatement la formule globale du coefficient d’asymétrie, propageant l’erreur #N/A à l’ensemble du modèle analytique. De surcroît, dans les scénarios où la distribution présente une multimodalité parfaite (par exemple, la valeur 15 présente deux fois et la valeur 30 présente deux fois également), la fonction MODE.SIMPLE() adopte un comportement arbitraire : elle sélectionne aveuglément la première modalité rencontrée selon l’ordre d’agencement physique des lignes dans la feuille de calcul, biaisant silencieusement le résultat sans émettre la moindre alerte logicielle.
Pour parer à l’interruption des calculs par le code d’erreur #N/A, il est impératif d’encapsuler la formule dans une structure de contrôle conditionnel via la fonction SI.NON.DISP() ou SIERREUR(). Nous recommandons d’implémenter en cellule E5 la version sécurisée suivante :
=SI.NON.DISP((MOYENNE(ScoresCliniques) - MODE.SIMPLE(ScoresCliniques)) / ECARTYPE.STANDARD(ScoresCliniques); "Mode indéterminé : Calcul impossible")
Cette précaution algorithmique garantit que le tableur documente explicitement la non-applicabilité du premier coefficient sans corrompre le fonctionnement du reste de la feuille d’analyse statistique.
8. Étape 3 : Calcul du coefficient d’asymétrie de Pearson avec la médiane dans Excel
8.1 Extraction de la médiane et calcul du numérateur ajusté
Face aux fragilités opérationnelles documentées du mode, nous procédons désormais au déploiement de la métrique reine : le second coefficient d’asymétrie de Pearson ($Sk_2$), reposant sur l’ordonnancement médian. Pour orchestrer ce calcul dans notre tableau de synthèse (colonnes D et E), nous ajoutons en cellule D6 le descripteur Mediane (Med).
Dans la cellule E6, introduisez la fonction statistique dédiée à l’extraction du second quartile :
=MEDIANE(ScoresCliniques)
Le moteur de calcul d’Excel procède instantanément à l’ordonnancement interne des vingt observations. La taille de l’échantillon étant un nombre pair ($N = 20$), la médiane correspond à la demi-somme arithmétique de la 10e et de la 11e observation du vecteur ordonné. En consultant notre tableau de données préalablement trié par ordre croissant :
- 10e observation (SUBJ_10) = 19
- 11e observation (SUBJ_11) = 20
- Médiane = $(19 + 20) / 2 = 19,500$
La valeur retournée en E6 est donc strictement égale à 19,500. Nous observons d’emblée la configuration spatiale ordonnée des trois paramètres de position de notre échantillon clinique :
$$\text{Mod} (16,000) < \text{Med} (19,500) < \bar{X} (22,400)$$
Cette chaîne d’inégalités strictes constitue la signature classique et théorique d’une distribution unimodale asymétrique positive. La distance séparant la moyenne de la médiane s’élève à : $\bar{X} – \text{Med} = 22,400 – 19,500 = 2,900$. Conformément aux développements théoriques de Karl Pearson exposés au chapitre 2, cette distance est ensuite modulée par le facteur d’amplification théorique égal à trois, produisant un numérateur ajusté de : $3 \cdot 2,900 = 8,700$.
8.2 Implémentation complète de la formule globale dans Excel
Nous pouvons à présent implémenter l’expression intégrale du second coefficient d’asymétrie de Pearson. En cellule D7, saisissez l’étiquette Pearson Skewness 2 (Médiane). Au sein de la cellule E7, saisissez la formulation en exploitant les références intermédiaires :
=3 * (E2 - E6) / E4
Pour concevoir une cellule totalement autonome, imperméable à toute suppression accidentelle des lignes intermédiaires de la feuille de travail, implémentez la formulation canonique directe suivante en E7 :
=3 * (MOYENNE(ScoresCliniques) - MEDIANE(ScoresCliniques)) / ECARTYPE.STANDARD(ScoresCliniques)
Il convient de porter une attention méticuleuse au parenthésage de cette expression. En vertu des règles de priorité arithmétique appliquées par le compilateur d’Excel, l’omission des parenthèses englobant la soustraction $(MOYENNE – MEDIANE)$ conduirait le logiciel à évaluer prioritairement la multiplication $3 \cdot MOYENNE$, puis à soustraire la quantité divisée $MEDIANE / ECARTYPE$, générant une aberration numérique totale.
L’exécution de la formule correctement parenthésée fournit le résultat numérique suivant :
$$Sk_2 = \frac{3 \cdot (22,400 – 19,500)}{10,747827} = \frac{8,700}{10,747827} = 0,809466…$$
Après application d’un arrondi académique à trois décimales, le second coefficient d’asymétrie de Pearson s’établit à +0,809. L’indicateur confirme avec une remarquable robustesse l’asymétrie positive du jeu de données. La comparaison entre la première métrique ($Sk_1 = +0,595$) et la seconde ($Sk_2 = +0,809$) montre une parfaite convergence directionnelle de signe (toutes deux positives), tout en matérialisant une amplitude plus affirmée pour la formulation médiane, qui intègre avec une plus grande sensibilité l’ensemble de la dispersion ordonnée de la traîne supérieure.
8.3 Automatisation et modularisation par les formules dynamiques
Pour les utilisateurs opérant sous les versions modernes d’Excel (Microsoft 365, Excel 2021 ou versions ultérieures), il est possible de mobiliser des fonctions de programmation fonctionnelle avancée pour encapsuler l’intégralité du calcul au sein d’une routine modulaire élégante. La fonction LET() permet d’assigner des noms à des variables de calcul intermédiaires à l’intérieur d’une formule unique, évitant la redondance des calculs, optimisant les performances de recalcul de la mémoire vive et rendant le code transparent pour un audit académique.
Vous pouvez encoder dans une cellule indépendante la formule dynamique suivante :
=LET(data; ScoresCliniques; m; MOYENNE(data); med; MEDIANE(data); s; ECARTYPE.STANDARD(data); 3 * (m - med) / s)
L’architecture de cette formule dynamique se déploie selon une logique de clarté absolue :
data; ScoresCliniques: assigne la plage source à la variable localedata.m; MOYENNE(data): calcule et stocke la moyenne dans la variable internem.med; MEDIANE(data): calcule et stocke la médiane dans la variable internemed.s; ECARTYPE.STANDARD(data): calcule et stocke l’écart-type d’échantillon dans la variable internes.3 * (m - med) / s: exécute la synthèse analytique terminale de Pearson.
Une fois cette architecture validée, il est recommandé de verrouiller et protéger les cellules de calcul (via le menu Format de cellule > onglet Protection > cocher Verrouillée, puis activer Protéger la feuille dans l’onglet Révision). Cette mesure préventive garantit l’intégrité pérenne de vos routines quantitatives contre toute frappe accidentelle d’opérateurs de saisie.
9. Comparaison des résultats de Pearson avec la fonction native COEFFICIENT.ASYMETRIE d’Excel
9.1 Fondement mathématique de la fonction native COEFFICIENT.ASYMETRIE
Microsoft Excel intègre dans sa bibliothèque statistique native une fonction préconfigurée dédiée au calcul de l’asymétrie, intitulée COEFFICIENT.ASYMETRIE() (ou SKEW() dans la version linguistique anglaise). Il est capital pour l’analyste de comprendre que cette fonction native ne repose pas sur les formulations canoniques de Karl Pearson basées sur le mode ou la médiane, mais applique une mécanique d’estimation entièrement différente : le calcul du troisième moment centré standardisé, corrigé pour le biais d’échantillonnage selon la formulation développée par R.A. Fisher.
L’équation algébrique interne exécutée par la fonction COEFFICIENT.ASYMETRIE() d’Excel s’énonce formellement comme suit pour un échantillon de taille $n$ :
$$G_1 = \frac{n}{(n – 1)(n – 2)} \sum_{i=1}^{n} \left( \frac{X_i – \bar{X}}{s} \right)^3$$
Où $X_i$ représente chaque observation individuelle, $\bar{X}$ la moyenne d’échantillon et $s$ l’écart-type d’échantillon. Cette formulation procède de l’élévation au cube des écarts standardisés à la moyenne. Le terme multiplicateur $n / ((n – 1)(n – 2))$ constitue le facteur de correction d’échantillon de Fisher, indispensable pour garantir que l’indice $G_1$ représente un estimateur sans biais du paramètre d’asymétrie de la population théorique parente.
La conséquence mathématique fondamentale de l’élévation à la puissance trois réside dans une hypersensibilité aux scores situés dans les queues de distribution. Alors que l’écart linéaire $(\bar{X} – \text{Med})$ au sein de la formule de Pearson traite la divergence centrale de manière pondérée, l’élévation au cube dans la formule de Fisher démultiplie l’influence des points extrêmes. Une observation très éloignée de la moyenne exercera ainsi un impact proportionnellement exponentiel sur la fonction native d’Excel, là où le second coefficient de Pearson maintiendra une appréciation plus équilibrée et structurelle de la forme globale du corps de la distribution.
9.2 Confrontation directe des valeurs sur le jeu de données expérimental
Afin de mettre en relief les convergences qualitatives et les divergences d’échelle quantitatives entre ces approches, implémentons la fonction native au sein de notre tableau de bord. En cellule D8, inscrivez l’étiquette Fisher-Pearson Natif (SKEW), puis saisissez en cellule E8 la formule native :
=COEFFICIENT.ASYMETRIE(ScoresCliniques)
Le moteur d’Excel renvoie pour cette fonction la valeur numérique de +1,191 (précisément $1,191244…$). Dressons un tableau comparatif rigoureux des trois métriques d’asymétrie calculées sur notre échantillon clinique de vingt participants :
| Métrique statistique | Formule sous-jacente | Formule Excel utilisée | Valeur calculée | Orientation diagnostique |
|---|---|---|---|---|
| Pearson 1 (Mode) | $(\bar{X} – \text{Mod}) / s$ | =(E2-E3)/E4 |
+0,595 | Asymétrie positive modérée |
| Pearson 2 (Médiane) | $3 \cdot (\bar{X} – \text{Med}) / s$ | =3*(E2-E6)/E4 |
+0,809 | Asymétrie positive substantielle |
| Fisher-Pearson (Natif) | Troisième moment ajusté | =COEFFICIENT.ASYMETRIE(B2:B21) |
+1,191 | Asymétrie positive sévère |
L’analyse comparative de ces résultats livre des enseignements méthodologiques cruciaux :
Premièrement, nous observons une parfaite cohérence de polarité. Les trois indicateurs affichent un signe positif indiscutable, certifiant sans la moindre ambiguïté que la distribution des scores d’anxiété s’étire vers les valeurs pathologiques élevées. Sur le plan de la détection de l’orientation du biais distributionnel, les trois méthodes manifestent une concordance diagnostique absolue.
Deuxièmement, nous constatons une divergence d’amplitude systématique : l’indice de Fisher-Pearson natif ($+1,191$) dépasse nettement le second coefficient de Pearson ($+0,809$), lui-même supérieur au premier coefficient ($+0,595$). Cette inflation de la fonction native d’Excel résulte directement de la présence des scores extrêmes $44$ et $52$. Élevés à la puissance trois, ces deux scores isolés tirent massivement l’indice de Fisher vers le haut. À l’inverse, le second coefficient de Pearson, borné par la résistance médiane, offre une estimation plus tempérée de l’asymétrie structurelle du groupe.
9.3 Réglementation méthodologique du choix de l’indicateur
Face à cette pluralité d’indicateurs au sein d’Excel, quelle métrique l’expérimentateur doit-il privilégier lors de la restitution de ses travaux ? Les manuels de méthodologie quantitative et les standards éditoriaux contemporains apportent des éclairages contrastés selon la finalité poursuivie.
Pour la soumission d’articles de recherche empirique au sein de revues scientifiques internationales affiliées à l’APA, la norme conventionnelle implicite privilégie généralement le reporting du troisième moment centré issu de la fonction native COEFFICIENT.ASYMETRIE(), principalement en raison de son intégration historique par défaut dans les logiciels de référence tels que SPSS, SAS ou le package e1071 sous R. Les estimateurs de normalité multivariée et les équations de correction de non-normalité dans les logiciels de modèles d’équations structurelles (comme AMOS, EQS ou Lavaan) reposent également sur les moments d’ordre supérieur.
Néanmoins, l’usage des coefficients de Pearson conserve une supériorité pédagogique et interprétative indiscutable dans de nombreux contextes opérationnels. En diagnostic clinique individuel, en psychométrie appliquée et dans l’ingénierie de la qualité, le second coefficient de Pearson offre une lisibilité directe : il exprime littéralement la distance physique entre la moyenne et la médiane en fractions d’écart-type. Lorsque l’analyste fait face à des échantillons de taille modeste comportant de légères valeurs atypiques qui feraient exploser artificiellement l’indice basé sur le cube de Fisher, le second coefficient de Pearson constitue l’outil diagnostique le plus intègre et le plus fidèle pour juger de la véritable forme du corpus des données.
10. Interprétation statistique et psychologique des valeurs d’asymétrie obtenues
10.1 Interprétation de la polarité : asymétrie positive versus négative
L’évaluation sémiotique immédiate d’un coefficient d’asymétrie — qu’il procède de la première ou de la seconde formulation de Karl Pearson — s’articule prioritairement autour de son signe algébrique. L’interprétation rigoureuse de la polarité s’établit selon les règles canoniques suivantes :
- Polarité strictement positive ($Sk > 0$) : Ce résultat indique une asymétrie vers la droite (right-skewed distribution). Sur le plan morphologique, la queue de distribution la plus longue et la plus fine s’étire vers les valeurs numériques élevées de l’axe des abscisses. La masse critique des observations est regroupée dans la moitié inférieure de l’échelle, créant un pic de densité à gauche. La hiérarchie spatiale des paramètres est généralement caractérisée par l’inégalité $\text{Mod} < \text{Med} < \bar{X}$.
- Polarité strictement négative ($Sk < 0$) : Ce résultat indique une asymétrie vers la gauche (left-skewed distribution). Morphologiquement, la traîne d’observations s’étire vers les valeurs numériques basses ou négatives de l’échelle, tandis que la concentration majeure des données se condense sur le versant supérieur droit. L’ordonnancement théorique inverse prévaut : $\bar{X} < \text{Med} < \text{Mod}$.
- Zone de quasi-symétrie ($Sk \approx 0$) : Lorsque le coefficient oscille dans un voisinage immédiat de zéro, la distribution approche un profil de symétrie spéculaire. La moyenne arithmétique et la médiane coïncident spatialement. Les déviations positives et négatives s’équilibrent de façon harmonieuse autour du barycentre unique.
Dans notre expérimentation sur les scores d’anxiété clinique, la polarité résolument positive ($Sk_2 = +0,809$) atteste que le profil psychopathologique de la cohorte est asymétrique à droite : les participants manifestent une tendance prépondérante à des scores d’anxiété faibles à modérés, la queue supérieure étant alimentée par l’étirement minoritaire des cas de crise panique.
10.2 Seuils empiriques d’intensité et règles d’interprétation académique
Au-delà de la polarité directionnelle, l’analyste doit quantifier l’intensité ou la sévérité de l’asymétrie observée. Plusieurs repères conventionnels ont été formalisés dans la littérature statistique spécialisée pour qualifier l’ampleur de la déviation par rapport à la loi normale. Les critères décisionnels les plus réputés sont ceux établis par l’astronome et statisticien Michael Bulmer dans son traité de statistique appliquée :
- $|Sk| < 0,5$ : Asymétrie légère ou négligeable. La distribution peut être considérée comme approximativement symétrique. L’impact de la déviation sur les tests d’hypothèses paramétriques usuels est minime, permettant l’utilisation sereine des outils inférentiels classiques.
- $0,5 le |Sk| le 1,0$ : Asymétrie modérée. La déformation de la courbe de densité est substantielle. L’écart entre moyenne et médiane commence à altérer la précision des estimations descriptives. L’usage de tests paramétriques demeure toléré sous réserve de vérification de l’homoscédasticité et d’une taille d’échantillon suffisante ($N > 30$).
- $|Sk| > 1,0$ : Asymétrie hautement prononcée ou sévère. La distribution s’écarte radicalement de l’idéal gaussien. La moyenne arithmétique ne peut plus être considérée comme un descripteur central valide. L’analyste doit impérativement envisager des transformations mathématiques d’assainissement ou basculer vers des protocoles inférentiels non paramétriques robustes.
Dans le domaine spécifique de la psychométrie et de la modélisation en équations structurelles, le méthodologiste Rex Kline propose une frontière d’alerte plus permissive : une variable manifeste une non-normalité problématique lorsque la valeur absolue de son asymétrie standardisée dépasse le seuil critique de $|Sk| ge 3,0$. Au sein de notre échantillon d’évaluation clinique, la valeur obtenue de $Sk_2 = +0,809$ se situe dans la plage $[0,5 ; 1,0]$, ce qui autorise à qualifier l’asymétrie de la distribution d’asymétrie positive modérée à substantielle.
10.3 Traduction substantielle dans le contexte psychologique
L’extraction d’un coefficient statistique ne prend tout son sens que lorsqu’elle est réintégrée dans le cadre théorique du construit psychologique sous-jacent. Que signifie substantiellement un coefficient de Pearson $Sk_2 = +0,809$ pour une échelle d’évaluation de l’anxiété clinique ?
Cette asymétrie positive substantielle traduit la réalité écologique de la santé mentale au sein d’une population tout-venant ou d’une patientèle de soins primaires non hospitalière. La majeure partie des individus présente une homéostasie psychologique préservée, se matérialisant par des scores compris entre 12 et 20 points (le mode se situant à 16 et la médiane à 19,5). L’existence d’une longue queue d’asymétrie supérieure indique que l’anxiété clinique ne se distribue pas de façon continue et équilibrée comme la taille ou le poids biologique, mais fonctionne selon une logique de rupture seuil : une fraction restreinte d’individus décompense de manière aiguë sous l’effet de stresseurs majeurs, colonisant des scores compris entre 35 et 52 points.
Cette observation a des répercussions directes sur l’étalonnage de l’instrument. Si le clinicien utilisait un étalonnage normatif fondé sur la moyenne et l’écart-type (notes $z$ ou notes $T$), les scores des patients situés dans la traîne inférieure subiraient un tassement artificiel en raison de la dilatation de l’écart-type ($s \approx 10,75$) causée par les scores extrêmes. La détection formelle de l’asymétrie via le coefficient de Pearson invite explicitement l’équipe soignante à privilégier un étalonnage non linéaire basé sur les rangs percentiles ou les déciles. Cet étalonnage quantile restitue fidèlement la position relative de chaque patient sans distorsion métrologique liée à l’asymétrie de l’instrument.
11. Erreurs courantes, limites méthodologiques et pièges dans Excel
11.1 Confusions entre écart-type d’échantillon et de population
L’une des erreurs conceptuelles les plus dévastatrices lors de l’encodage des formules de Pearson sous Excel réside dans la confusion entre l’écart-type d’échantillon et l’écart-type de population. Cette confusion découle de la taxonomie des fonctions statistiques intégrées au tableur. Microsoft Excel propose en effet deux familles distinctes pour évaluer la dispersion :
ECARTYPE.STANDARD()(ouSTDEV.S()) : calcule l’écart-type d’échantillon corrigé en divisant la somme des carrés des écarts par les degrés de liberté $(n – 1)$. Il s’agit du seul estimateur non biaisé de la variabilité de la population lorsque l’analyste travaille sur un échantillon empirique extrait d’une population plus vaste.ECARTYPE.PEARSON()ouECARTYPE.P()(ouSTDEV.P()) : calcule l’écart-type de population intégrale en divisant la somme des carrés par $n$. Cette fonction postule que l’échantillon saisi constitue l’exhaustivité absolue de la population d’intérêt.
Le piège linguistique est particulièrement redoutable ici : la présence du nom propre « PEARSON » au sein de la fonction ECARTYPE.PEARSON() pousse de nombreux étudiants et chercheurs non avertis à sélectionner cette fonction en croyant à tort qu’il s’agit de la formule dédiée au coefficient d’asymétrie de Pearson. Il n’en est rien. L’utilisation de ECARTYPE.PEARSON() au dénominateur du coefficient d’asymétrie engendre une sous-estimation systématique de la dispersion par l’omission du terme correctif de Bessel $(n – 1)$.
En sous-estimant le dénominateur, l’analyste gonfle artificiellement la valeur absolue du coefficient d’asymétrie de Pearson d’un facteur égal à $\sqrt{n / (n – 1)}$. Pour notre échantillon de $N = 20$, l’utilisation erronée de ECARTYPE.PEARSON() ($s_{pop} \approx 10,476$) produirait un coefficient $Sk_2 \approx +0,830$ au lieu de la valeur rigoureuse $+0,809$, introduisant un biais méthodologique indésirable dans le compte-rendu scientifique.
11.2 Sensibilité extrême aux valeurs atypiques isolées
Bien que le second coefficient de Pearson basé sur la médiane soit infiniment plus stable face aux valeurs aberrantes que le troisième moment de Fisher, il n’en demeure pas moins sensible aux points de levier extrêmes. Cette vulnérabilité résiduelle provient de la présence conjointe de la moyenne arithmétique ($\bar{X}$) au numérateur et de l’écart-type d’échantillon ($s$) au dénominateur. Ces deux paramètres possèdent un point de rupture nul ($0 %$), ce qui signifie qu’une seule observation erronée de magnitude infinie peut corrompre leur estimation.
Imaginons qu’une erreur de saisie typographique transforme le score du sujet 20 de notre cohorte de $52$ en $520$. Observons la dérive catastrophique des indicateurs :
- La médiane demeure rigoureusement inchangée à $19,500$ (propriété de robustesse quantile absolue).
- La moyenne explose, passant instantanément de $22,400$ à $45,800$.
- L’écart-type d’échantillon est projeté de $10,75$ à plus de $111,8$.
- Le coefficient $Sk_2$ est immédiatement faussé, perdant toute représentativité du comportement de la cohorte.
Il est donc impératif, préalablement au calcul et à l’interprétation des indices de Pearson, de procéder à un dépistage systématique des points de levier univariés. Dans Excel, cette détection s’opère commodément par l’identification des observations dont l’écart à la médiane dépasse 2,5 ou 3 fois l’écart interquartile (IQR), ou par la standardisation préalable temporaire en scores $Z$. Tout écart aberrant doit faire l’objet d’un audit de traçabilité avant d’entériner les résultats distributionnels.
11.3 Mauvaises interprétations des codes d’erreur du tableur
L’automatisation des calculs statistiques sous Microsoft Excel expose l’analyste à des codes d’erreur spécifiques dont la mauvaise interprétation peut compromettre la chaîne de traitement. Le tableau ci-dessous répertorie les anomalies computationnelles les plus fréquentes rencontrées lors de l’évaluation des coefficients d’asymétrie, leurs causes structurelles et les remèdes opératoires immédiats :
| Code d’erreur Excel | Cause structurelle sous-jacente | Procédure de remédiation technique |
|---|---|---|
| #DIV/0! | L’écart-type d’échantillon au dénominateur est strictement nul ($s = 0$). Cela survient lorsque toutes les observations du vecteur sont rigoureusement identiques (variance nulle). | Vérifier l’intégrité des données brutes. Une variable constante ne possède aucune variance et son asymétrie n’a aucun sens mathématique. |
| #N/A | La fonction MODE.SIMPLE() ne détecte aucune répétition de valeur au sein de la plage sélectionnée. |
Remplacer immédiatement la méthode du mode par le second coefficient de Pearson basé sur la médiane MEDIANE(). |
| #VALEUR! | Présence d’un caractère textuel, d’un espace insécable ou d’une formule corrompue au sein de la plage source. | Nettoyer la plage de données avec CNUM(), EPURAGE() et vérifier les séparateurs décimaux (virgule vs point). |
| #NOM? | Faute de frappe dans l’intitulé d’une fonction (ex. MEDIENNE au lieu de MEDIANE) ou appel d’un nom de plage inexistant. |
Inspecter l’orthographe exacte des fonctions et valider l’existence du vecteur dans le Gestionnaire de noms d’Excel. |
12. Bonnes pratiques pour le reporting académique et la prise de décision statistique
12.1 Normes de présentation des résultats selon le style APA (7e édition)
La transcription des analyses distributionnelles au sein de rapports d’évaluation psychométrique ou de mémoires de recherche universitaire doit se conformer rigoureusement aux conventions typographiques et structurelles édictées par l’American Psychological Association (normes APA, 7e édition). Ces standards imposent des règles strictes régissant l’usage des symboles statistiques et les conventions d’arrondi décimal.
Les symboles mathématiques désignés par des lettres latines doivent impérativement être composés en caractères italiques :
- La moyenne arithmétique est notée M.
- L’écart-type d’échantillon est noté SD (pour Standard Deviation) ou ET dans les publications francophones strictes.
- La médiane est notée Mdn.
- La taille de l’échantillon d’étude est notée N (taille totale) ou n (sous-groupe).
- Le second coefficient d’asymétrie de Pearson est généralement abrégé sous le symbole Sk ou Sk₂.
Les règles de précision numérique stipulent que les paramètres descriptifs et les coefficients d’asymétrie doivent être rapportés avec deux ou trois décimales significatives stables (typiquement deux décimales pour les moyennes et écarts-types, et deux ou trois pour les coefficients de forme). De plus, lorsque le coefficient est susceptible de prendre une valeur théorique supérieure à 1 (ce qui est le cas du coefficient de Pearson), il est obligatoire de maintenir le zéro initial avant le séparateur décimal (écrire 0,81 et non ,81).
Voici un modèle canonique de paragraphe méthodologique synthétisant les résultats obtenus sur notre jeu de données cliniques :
« L’analyse exploratoire de la distribution des scores d’anxiété clinique (N = 20) met en évidence une déviation modérée à substantielle par rapport au modèle de la loi normale. Si la moyenne arithmétique s’élève à M = 22,40 (SD = 10,75), la médiane se situe quant à elle à Mdn = 19,50, traduisant un regroupement des sujets dans la zone inférieure de l’échelle clinique. Le second coefficient d’asymétrie de Karl Pearson, fondé sur la relation médiane-moyenne, confirme formellement cette orientation asymétrique positive avec une valeur standardisée de Sk₂ = +0,81 (le coefficient de Fisher-Pearson correspondant s’élevant à 1,19). Au regard de cette traîne supérieure étirée par les patients en crise aiguë, les rangs percentiles seront privilégiés pour l’étalonnage clinique individuel. »
12.2 Arbre de décision pour le choix des tests statistiques subséquents
L’estimation rigoureuse du coefficient d’asymétrie de Pearson dans Excel constitue la boussole méthodologique guidant l’analyste dans l’orientation de ses choix inférentiels. L’articulation entre l’amplitude de l’asymétrie et la sélection des tests d’hypothèses s’organise selon un algorithme décisionnel éprouvé :
Cas n° 1 : Asymétrie résiduelle faible ($|Sk_2| < 0,5$) avec effectif modéré ($N ge 30$).
Les postulats de normalité distributionnelle sont jugés raisonnablement respectés en vertu du Théorème Central Limite. L’expérimentateur maintient l’usage des tests paramétriques conventionnels : test $t$ de Student pour échantillons indépendants ou appariés, analyse de variance univariée ou factorielle (ANOVA), calcul des coefficients de corrélation linéaire de Pearson et modélisation par régression linéaire ordinaire (MCO). Ces procédures garantissent alors une puissance statistique optimale ($1 – \beta$).
Cas n° 2 : Asymétrie substantielle à sévère ($|Sk_2| ge 0,8$ à $1,0$) avec effectif restreint ($N < 30$).
Les inférences paramétriques sont formellement contre-indiquées en raison d’une déformation critique de la distribution d’échantillonnage de la moyenne. L’analyste doit immédiatement basculer vers les alternatives non paramétriques fondées sur les rangs :
- Substitution du test $t$ de Student pour échantillons indépendants par le test $U$ de Mann-Whitney (ou test de Wilcoxon-Mann-Whitney).
- Substitution du test $t$ pour mesures répétées par le test des rangs signés de Wilcoxon.
- Remplacement de l’ANOVA à un facteur par le test de Kruskal-Wallis.
- Remplacement du coefficient de corrélation linéaire de Pearson par le $rho$ de Spearman ou le $tau$ de Kendall.
Une alternative computationnelle moderne dans Excel consiste à implémenter des procédures de rééchantillonnage de type bootstrap non paramétrique. En générant par macro VBA ou formules matricielles plusieurs milliers de rééchantillons avec remise à partir des données sources, l’analyste peut dériver des intervalles de confiance empiriques robustes pour la différence des moyennes sans poser le moindre postulat sur la symétrie de la population parente.
12.3 Stratégies d’assainissement et de transformation des scores
Lorsque la conservation d’un cadre d’analyse paramétrique est impérative (par exemple pour tester des interactions factorielles complexes d’ordre supérieur dans une ANOVA multivariée où les équivalents non paramétriques font défaut), la présence d’une asymétrie de Pearson marquée réclame une stratégie d’assainissement par transformation mathématique non linéaire.
Le choix de la fonction de transformation dépend directement de la polarité et de la magnitude du coefficient d’asymétrie diagnostiqué dans Excel :
1. Asymétrie positive modérée ($0,5 le Sk_2 < 1,0$) : La transformation Racine Carrée.
Cette transformation compresse progressivement l’échelle au fur et à mesure que les scores augmentent, exerçant un effet modérateur sur les valeurs élevées de la traîne droite. Dans une colonne adjacente de votre feuille Excel, encodez pour la cellule B2 la formule : =RACINE(B2) (ou =RACINE(B2 + 1) si l’échelle psychométrique comprend des scores nuls stricts).
2. Asymétrie positive forte à sévère ($Sk_2 ge 1,0$) : La transformation Logarithmique.
La fonction logarithmique népérienne applique une compression géométrique agressive sur les valeurs extrêmes supérieures. Elle constitue le traitement standard des chronométries mentales et des variables biologiques de concentration. Dans Excel, implémentez l’expression : =LN(B2) si tous les scores sont strictement supérieurs à zéro, ou la formule logarithmique décalée =LN(B2 + 1) pour neutraliser l’indétermination mathématique de $ln(0)$.
3. Asymétrie positive explosive ($Sk_2 > 2,0$) : La transformation Inverse.
Pour les traînes extrêmement étirées, la fonction inverse renverse et contracte violemment la distribution. Dans Excel, appliquez : =1 / B2 (ou =1 / (B2 + 1)). Attention : cette fonction inversant l’ordre naturel des scores (les valeurs les plus élevées devenant les plus petites), l’analyste devra multiplier le résultat par $-1$ pour préserver la polarité interprétative de la variable ($=-1 / B2$).
4. Gestion de l’asymétrie négative ($Sk_2 < -0,5$) : La stratégie du miroir.
Les fonctions mathématiques usuelles (racine carrée, logarithme) sont inopérantes sur une asymétrie à gauche car elles compressent le versant supérieur, ce qui aggraverait l’asymétrie. La démarche scientifique impose d’exécuter au préalable une réflexion spéculaire : convertir l’asymétrie négative en asymétrie positive en soustrayant chaque score individuel d’une constante $K$ égale au score maximal observé $+ 1$ : $Score_{refle\chi} = K – X$. La transformation logarithmique est ensuite appliquée sur ce score inversé : =LN(K - B2).
La règle d’or de l’ingénierie quantitative sous Excel exige d’exécuter un contrôle de validation post-transformation. Recalculez systématiquement le second coefficient d’asymétrie de Karl Pearson sur la nouvelle colonne de données transformées. Si la procédure d’assainissement a réussi, la valeur absolue du coefficient $|Sk_2|$ doit régresser significativement pour se loger à l’intérieur de l’intervalle de quasi-symétrie $[-0,5 ; +0,5]$, attestant scientifiquement que le jeu de données est désormais harmonisé et prêt pour les modélisations inférentielles ultérieures.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bulmer, M. G. (1979). Principles of statistics. Dover Publications.
- Doane, D. P., & Seward, L. E. (2011). Measuring skewness: A forgotten statistic? Journal of Statistics Education, 19(2), 1-18. https://doi.org/10.1080/10691898.2011.11889611
- Fisher, R. A. (1930). The moments of the distribution for normal samples of measures of departure from normality. Proceedings of the Royal Society of London. Series A, Containing Papers of a Mathematical and Physical Character, 130(812), 16-28. https://doi.org/10.1098/rspa.1930.0185
- Kline, R. B. (2016). Principles and practice of structural equation modeling (4th ed.). The Guilford Press.
- Microsoft Corporation. (2024). Fonction COEFFICIENT.ASYMETRIE dans Microsoft Excel. Support Microsoft. https://support.microsoft.com/fr-fr/office/coefficient-asymetrie
- Pearson, K. (1895). Contributions to the mathematical theory of evolution.—II. Skew variation in homogeneous material. Philosophical Transactions of the Royal Society of London. A, 186, 343-414. https://doi.org/10.1098/rsta.1895.0010
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.