
L’analyse des séries temporelles, le suivi des cohortes cliniques, la modélisation économétrique et le pilotage des opérations organisationnelles reposent fondamentalement sur la précision des mesures d’intervalles chronologiques. Dans les environnements contemporains d’ingénierie des données et de bureautique décisionnelle, le tableur en nuage Google Sheets s’est imposé comme une plateforme prépondérante de collecte, de transformation et d’agrégation d’informations quantitatives. Toutefois, sous l’apparente trivialité d’un écart temporel séparant deux bornes calendaires se dissimule une complexité arithmétique et logique considérable, façonnée par les conventions grégoriennes, la variabilité de la durée des mois, l’intercalation quadriennale des années bissextiles et l’architecture sous-jacente des moteurs de calcul sériel.
Dans le cadre de la recherche scientifique, de l’évaluation psychométrique ou du contrôle de gestion rigoureux, l’imprécision dans le décompte de jours, de mois révolus ou d’années peut introduire des biais systématiques destructeurs pour la validité interne des modèles. Une sous-estimation systématique de l’âge chronologique d’un participant ou une mauvaise affectation des délais d’exposition thérapeutique corrompt les analyses statistiques inférentielles, telles que les modèles de régression de Cox ou les analyses de variance à mesures répétées. Dès lors, maîtriser les fonctions natives, les syntaxes matricielles et les mécanismes d’arbitrage computationnels de Google Sheets constitue une compétence méthodologique indispensable pour tout analyste exigeant.
Ce guide exhaustif a pour vocation d’analyser en profondeur les mécanismes mathématiques, structurels et applicatifs régissant la soustraction de dates et l’évaluation d’intervalles dans Google Sheets. De l’architecture sérielle issue de l’héritage historique des tableurs jusqu’aux fonctions itératives modernes fondées sur le calcul fonctionnel et matriciel, chaque dimension fait l’objet d’une dissection théorique et empirique. L’accent est porté tant sur les calculs en temps continu que sur la discrétisation calendaire, la gestion défensive des valeurs corrompues et l’intégration de flux dynamiques pour garantir une reproductibilité analytique absolue.
1. Introduction aux calculs chronométriques et temporels dans Google Sheets
L’évaluation quantitative du temps au sein d’un tableur requiert une abstraction mathématique préalable : la transcription d’une réalité calendaire continue, rythmée par des cycles astronomiques complexes, en un système numérique linéaire manipulable par une unité arithmétique et logique. Avant de concevoir des formules d’intervalles, il convient d’analyser la façon dont les moteurs de tableurs, et plus spécifiquement Google Sheets, transforment les repères chronologiques en entités scalaires.
1.1 Fondements de la représentation sérielle du temps dans les tableurs
À l’instar des standards établis par les pionniers de la micro-informatique décisionnelle, Google Sheets utilise une représentation sérielle continue pour stocker et traiter les données temporelles. Dans ce paradigme, chaque date du calendrier n’est pas conservée sous la forme d’un ensemble textuel articulant jour, mois et année, mais sous la forme d’un nombre réel à virgule flottante. Le point d’origine sériel, ou époque de référence (« epoch »), a été arbitrairement fixé au 30 décembre 1899 à minuit (valeur sérielle 0,0). Dès lors, le 31 décembre 1899 correspond au nombre entier 1, le 1er janvier 1900 au nombre entier 2, et ainsi de suite de manière strictement consécutive jusqu’à notre ère contemporaine et au-delà.
Cette conversion implicite du calendrier grégorien en entiers sériels consécutifs confère une simplicité mathématique remarquable aux opérations d’addition et de soustraction de jours calendaires. Lorsqu’un utilisateur saisit une date dans une cellule, le moteur applique un algorithme de conversion bidirectionnel : l’interface utilisateur restitue une chaîne formatée selon les conventions régionales en vigueur, tandis que la mémoire vive de l’application manipule exclusivement un entier sériel ou un décimal. Cette architecture assure que l’intervalle entre deux dates correspond littéralement à la distance arithmétique séparant leurs valeurs sérielles respectives.
L’incorporation de l’horodatage fin, incluant les heures, les minutes et les secondes, est élégamment résolue par la manipulation des fractions décimales de l’entier sériel. Une journée complète de 24 heures représentant l’unité entière 1,0, chaque fraction de jour correspond à une portion aliquote de cette unité. Par conséquent, une heure équivaut rigoureusement à 1/24 (approximativement 0,041667), une minute à 1/1440 (environ 0,000694), et une seconde à 1/86400 (environ 0,00001157). À titre d’illustration, la valeur sérielle 45000,75 représente le 14 mars 2023 à 18 heures précises. Cette continuité mathématique garantit la validité interne absolue des calculs différentiels, éliminant toute discontinuité entre les dimensions purement calendaires et les dimensions chronométriques intrajournalières.
1.2 Pertinence méthodologique des intervalles temporels en analyse de données
Dans le domaine des sciences expérimentales, de l’épidémiologie clinique et de la psychométrie différentielle, la quantification des intervalles temporels ne relève pas d’une simple commodité technique, mais constitue une variable dépendante ou indépendante majeure. La mesure rigoureuse de la durée de suivi (« follow-up ») au sein de protocoles longitudinaux détermine directement la robustesse des modèles de survie et la validité des taux d’incidence cumulée. Si la durée d’observation d’une cohorte est altérée par un calcul d’intervalle approximatif ignorant les spécificités des années bissextiles ou des mois inégaux, l’estimation des risques relatifs encourt un biais d’attrition temporelle susceptible de compromettre les conclusions scientifiques.
De surcroît, le calcul précis de l’âge chronologique des participants lors de passations d’épreuves cognitives ou psychométriques conditionne le calibrage des scores standardisés. Dans l’étalonnage des batteries d’évaluation intellectuelle, telles que les échelles de Wechsler, le passage d’une tranche d’âge de six mois à une autre modifie radicalement le rang centile attribué aux performances brutes d’un enfant. Une discordance de calcul de quelques jours, induite par une formule de division simpliste par 365 ou 30, peut faire basculer un individu dans une catégorie normative inadaptée, générant un faux diagnostic clinique ou faussant les résultats d’une cohorte expérimentale.
Enfin, le contrôle minutieux des délais de rétention mnésique entre sessions expérimentales requiert une traçabilité sans faille. Dans un paradigme d’apprentissage espacé (« spaced retrieval »), l’écart exact séparant la phase d’encodage initial de la phase de rappel libre doit correspondre scrupuleusement au protocole théorique préétabli. L’automatisation du calcul des intervalles dans la base de données permet d’exclure a posteriori les sujets n’ayant pas satisfait aux fenêtres de tolérance temporelle strictes, préservant ainsi l’homogénéité méthodologique requise par les instances d’évaluation par les pairs.
1.3 Typologie des erreurs courantes liées à la saisie des dates
En dépit de l’élégance du système sériel sous-jacent, le traitement des données temporelles dans Google Sheets est particulièrement vulnérable aux erreurs de saisie et de configuration logicielle. La source d’écueil la plus omniprésente découle de la confusion entre les conventions de notation régionales, singulièrement l’antagonisme entre le format jour/mois/année (JJ/MM/AAAA), prédominant dans l’espace francophone et européen, et le format mois/jour/année (MM/JJ/AAAA), en vigueur aux États-Unis. Lorsqu’un jeu de données issu d’une source anglo-saxonne est importé dans un classeur configuré selon les paramètres régionaux français, la date du 7 avril 2024 (04/07/2024 aux États-Unis) est systématiquement interprétée comme le 4 juillet 2024, introduisant une distorsion temporelle massive de près de trois mois.
Une seconde pathologie fréquente réside dans le stockage accidentel de dates sous forme de chaînes textuelles non calculables. Si un opérateur insère des caractères non numériques, des espaces superflues ou utilise des séparateurs non reconnus par la locale courante (par exemple des points au lieu de barres obliques), Google Sheets n’assigne aucun numéro sériel à la valeur et la traite comme un libellé alphanumérique aligné par défaut à gauche de la cellule. Dès cet instant, toute tentative de soustraction arithmétique ou d’exécution d’une fonction d’intervalle engendre inévitablement une erreur d’évaluation, bloquant la chaîne de calcul analytique.
Enfin, les disparités induites par les fuseaux horaires (« timezones ») constituent un facteur insidieux de dérive chronométrique, particulièrement dans les environnements de travail collaboratifs asynchrones. Chaque feuille de calcul Google Sheets dispose d’un fuseau horaire propre, paramétrable dans les paramètres du document. Si les données proviennent de formulaires électroniques externes enregistrés en temps universel coordonné (UTC) alors que le classeur opère sous le fuseau UTC+2 de l’Europe centrale, des décalages d’une journée entière peuvent survenir aux frontières de minuit. Il apparaît donc indispensable de déployer une phase systématique d’assainissement, de conversion et de typage strict des données avant toute tentative de modélisation différentielle.
2. Anatomie et syntaxe fondamentale de la fonction DATEDIF
Parmi l’éventail des fonctions temporelles mises à la disposition des utilisateurs de tableurs, la fonction DATEDIF occupe une place éminente. Héritée des versions séminales des logiciels de traitement matriciel, elle offre une interface unifiée pour calculer l’écart séparant deux repères calendaires selon des métriques de granularité variables. Une compréhension rigoureuse de ses fondements syntaxiques et de sa mécanique algorithmique s’impose pour en exploiter l’ensemble des potentialités sans encourir d’erreurs d’évaluation.
2.1 Décomposition structurelle des arguments de la fonction
La fonction DATEDIF repose sur une signature ternaire rigide, dont l’ordre des paramètres ne tolère aucune permutation arbitraire. La formulation canonique de l’instruction s’énonce selon la syntaxe suivante :
=DATEDIF(date_début; date_fin; unité)
Le premier argument, conventionnellement désigné par date_début, formalise la borne inférieure de l’intervalle chronologique considéré. Il doit impérativement s’agir d’une valeur sérielle valide, d’une référence directe à une cellule contenant une date conforme, ou du résultat d’une fonction intermédiaire générant un horodatage (comme la fonction DATE). Cet argument ancre le point d’origine à partir duquel le balayage temporel est initialisé.
Le deuxième argument, date_fin, matérialise la borne supérieure de l’intervalle temporel sous observation. Il obéit aux mêmes impératifs de typage que le premier argument. Dans l’architecture déterministe de DATEDIF, cette date terminale définit la limite exclusive ou inclusive de l’incrémentation selon l’unité retenue, incarnant le moment exact où le comptage doit cesser.
Le troisième argument, unité, conditionne la nature de la transformation mathématique opérée par le moteur. Il se présente obligatoirement sous la forme d’une chaîne de caractères alphabétiques encadrée par des guillemets doubles droits (par exemple « D », « M » ou « Y »). Ce paramètre prescrit l’échelle de mesure selon laquelle la distance séparant les deux bornes calendaires sera quantifiée, discrétisée et restituée à l’utilisateur sous la forme d’un nombre entier naturel.
2.2 Conditions préalables à l’exécution de l’algorithme DATEDIF
L’exécution intègre et exempte d’erreurs de la fonction DATEDIF est subordonnée au respect d’un ensemble de postulats arithmétiques stricts. La condition préalable la plus critique concerne l’ordre chronologique des bornes temporelles : la valeur sérielle correspondant à date_début doit obligatoirement être inférieure ou égale à la valeur sérielle de date_fin. Si cette relation d’ordre n’est pas vérifiée — c’est-à-dire si la date de départ succède dans le temps à la date terminale —, l’algorithme refuse d’opérer un calcul dans le sens rétrograde et déclenche immédiatement une erreur d’évaluation de type #NUM!.
En second lieu, la fonction exige que les deux premiers paramètres soient interprétés par le moteur comme des nombres sériels valides. La présence d’une valeur textuelle non convertible entraîne l’émission d’une erreur #VALEUR!, interrompant l’évaluation de la feuille de calcul. Lorsque date_début et date_fin pointent vers la même journée calendaire, l’algorithme présente un comportement déterministe prévisible : le différentiel retourné équivaut exactement à zéro pour l’ensemble des unités conventionnelles disponibles.
Enfin, bien que l’analyseur syntaxique de Google Sheets fasse preuve d’une certaine tolérance à l’égard de la casse typographique (les minuscules « d », « m », « y » étant généralement interprétées de façon équivalente aux majuscules « D », « M », « Y »), toute inclusion accidentelle d’espaces insécables ou de caractères invisibles au sein de la chaîne délimitant l’unité provoquera un rejet catégorique de la formule, l’unité transmise n’étant plus reconnue dans le dictionnaire interne des paramètres admis.
2.3 Intégration de DATEDIF dans l’écosystème algorithmique de Google Sheets
La présence de DATEDIF dans Google Sheets procède d’une trajectoire historique singulière au sein du génie logiciel de bureau. Conçue initialement au sein du tableur Lotus 1-2-3 dans les années 1980, cette fonction a été intégrée ultérieurement dans Microsoft Excel afin d’assurer une compatibilité descendante exhaustive avec les feuilles de calcul existantes. Google Sheets a logiquement pérennisé cet héritage pour offrir une interopérabilité complète lors de l’importation de classeurs hétérogènes.
Cette généalogie explique une anomalie documentaire notable : pendant de nombreuses années, DATEDIF est demeurée une fonction dite « non documentée » ou « semi-documentée », les assistants contextuels d’aide à la saisie de Google Sheets et d’Excel omettant de détailler sa liste de paramètres au sein des infobulles natives. Malgré cette discrétion ergonomique, la fonction bénéficie d’une optimisation de bas niveau au cœur du moteur JavaScript et C++ du tableur en nuage, conférant à son exécution une vélocité et une robustesse remarquables lors du traitement de jeux de données volumineux regroupant des centaines de milliers d’enregistrements.
Contrairement aux soustractions arithmétiques pures qui opèrent sur le continuum des nombres réels, DATEDIF implémente une logique calendaire civilisée. Elle ne se contente pas de diviser un nombre de jours par des coefficients approximatifs, mais simule fidèlement le déroulement des pages d’un calendrier réel, ce qui la distingue radicalement de fonctions financières spécialisées telles que FRACTION.ANNEE ou DUREE.
3. Calcul du différentiel en jours : Méthodes et applications concrètes
La détermination de l’écart exprimé en jours constitue l’opération chronométrique la plus élémentaire et la plus fréquente dans la gestion des données tabulaires. Qu’il s’agisse de mesurer la durée d’une hospitalisation, le délai de livraison d’un composant industriel ou la période d’incubation d’un agent pathogène, deux approches computationnelles coexistent au sein de Google Sheets : l’invocation formelle de DATEDIF avec le paramètre « D » et la soustraction arithmétique directe.
3.1 Mise en œuvre du paramètre d’unité « D »
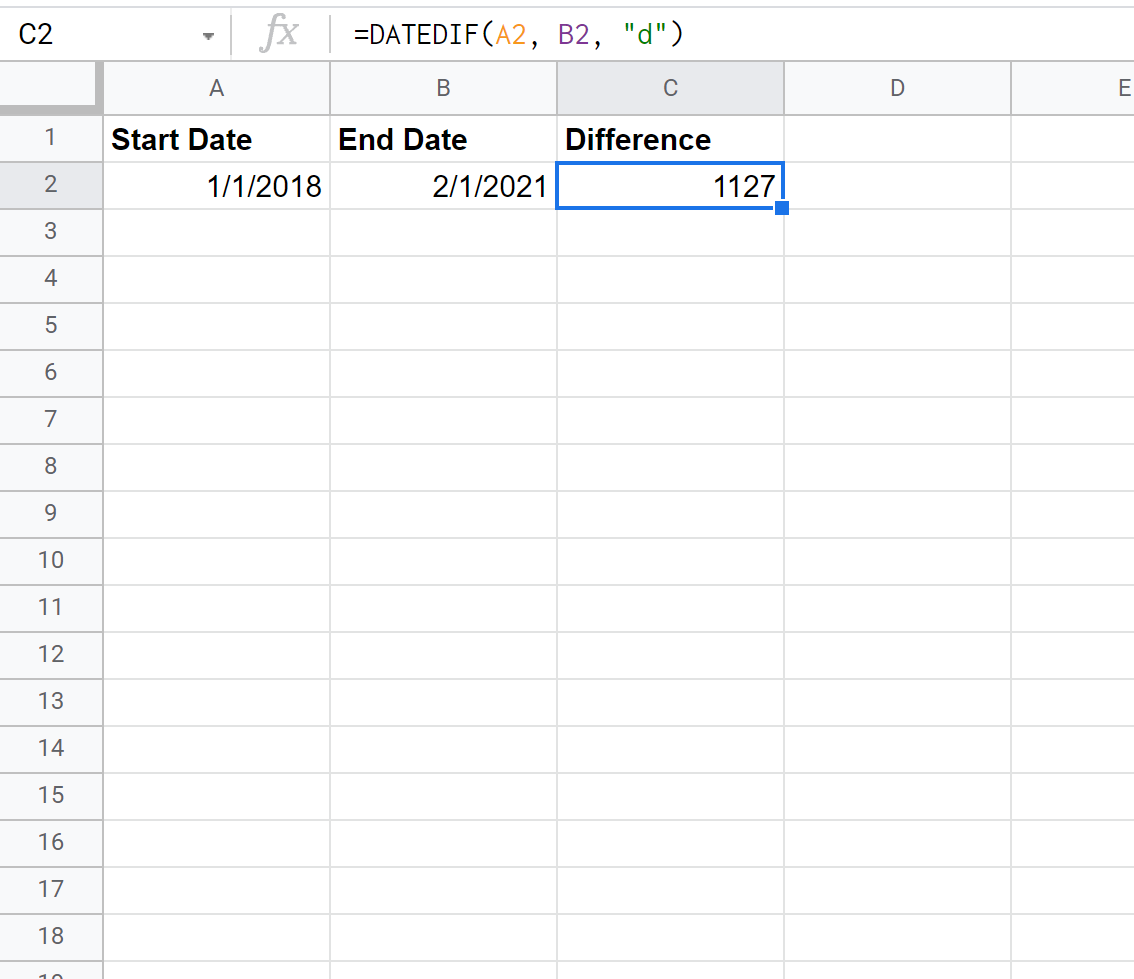
Pour extraire l’écart absolu en jours entre deux jalons temporels, la fonction DATEDIF s’utilise en renseignant le caractère « D » (pour « Days ») au niveau de son troisième argument. La formulation standard s’écrit de la façon suivante :
=DATEDIF(A2; B2; « D »)
Dans cette configuration, l’algorithme évalue la distance séparant la cellule source A2 de la cellule cible B2 et renvoie un nombre entier correspondant strictement au total des journées révolues. Cette méthode présente l’avantage d’une lisibilité documentaire immédiate au sein des formules complexes : un relecteur identifie sans équivoque l’intention méthodologique de l’analyste, qui consiste à mesurer un écart chronologique standardisé en jours civils.
Sur le plan des performances computationnelles, le calcul de millions de lignes via DATEDIF(A2; B2; « D ») démontre une efficacité algorithmique satisfaisante, bien que légèrement plus coûteuse en cycles d’horloge processeur que l’arithmétique directe, en raison de l’évaluation préalable de la chaîne textuelle du paramètre d’unité. Sur des intervalles discontinus ou des jeux de données intégrant des dates réparties sur plusieurs siècles, l’intégrité sérielle garantit une parfaite exactitude des résultats renvoyés.
3.2 Comparaison critique entre DATEDIF(« D ») et la soustraction arithmétique directe
Compte tenu de la nature sérielle des dates exposée précédemment, une méthode universellement adoptée par les praticiens du tableur consiste à effectuer une soustraction arithmétique élémentaire :
=B2 – A2
Sur le plan purement mathématique, lorsque les cellules A2 et B2 contiennent des dates entières exemptes de composantes horaires (c’est-à-dire avec une fraction décimale strictement égale à zéro), le résultat de la soustraction directe est rigoureusement identique au résultat produit par DATEDIF(A2; B2; « D »). Toutefois, des divergences subtiles émergent dès lors que les données incorporent des heures et des minutes.
La soustraction arithmétique directe préserve l’intégralité des fractions décimales issues du différentiel temporel. Par exemple, si l’événement A2 s’est produit à 08h00 et l’événement B2 le lendemain à 20h00, la soustraction retournera la valeur 1,5 (soit 36 heures effectives). À l’inverse, DATEDIF tronque systématiquement le résultat pour ne renvoyer que l’entier des journées complètes révolues, affichant ainsi 1. Le choix entre ces deux formulations dépend donc du postulat expérimental retenu : souhaite-t-on une métrique continue intégrant la précision horaire, ou une métrique discrète dénombrant exclusivement les passages de minuit ou les tranches de 24 heures révolues ?
Un danger récurrent associé à la soustraction arithmétique directe réside dans le formatage d’affichage automatique de Google Sheets. Lorsqu’une opération =B2 – A2 est validée, l’interface graphique du tableur tente fréquemment de deviner le format souhaité et applique spontanément un format de date à la cellule résultante. Une différence de 14 jours s’affichera alors de façon incongrue comme le 14/01/1900, induisant l’utilisateur non averti en erreur. La fonction DATEDIF est immunisée contre ce travers, son retour étant nativement typé comme un nombre entier brut.
3.3 Impact des années bissextiles sur le calcul absolu des jours
Le calendrier grégorien introduit une irrégularité périodique majeure à travers l’intercalation d’une journée additionnelle — le 29 février — lors des années bissextiles, définies comme étant divisibles par 4, à l’exception des années séculaires non divisibles par 400. Dans le cadre de protocoles d’observation pluriannuels, la prise en compte de cette singularité calendaire conditionne l’exactitude des séries temporelles.
La représentation sérielle continue de Google Sheets intègre nativement et de manière totalement transparente l’existence du 29 février. Chaque journée bissextile possède son propre numéro de série consécutif unique. Par voie de conséquence, un calcul d’écart journalier effectué entre le 1er janvier 2024 et le 1er mars 2024 renverra avec une exactitude irréprochable la valeur de 60 jours révolus, contre 59 jours pour un intervalle temporellement homologue situé au cours d’une année commune telle que 2023.
Cette précision arithmétique élimine les biais systématiques qui affecteraient une modélisation simpliste reposant sur la multiplication arbitraire des années écoulées par 365. Lors de comparaisons interannuelles longitudinales portant sur de longues périodes historiques, la cohérence mathématique du tableur neutralise toute distorsion cumulative, y compris lors du franchissement des frontières séculaires critiques, comme le passage de l’an 2000 qui fut bissextile conformément à la règle quadri-séculaire grégorienne.
4. Évaluation des intervalles en mois complets : Utilisation de l’unité « M »
Si le jour représente l’unité physique la plus objective de l’écoulement temporel, le mois calendaire constitue le jalon organisationnel, économique et physiologique prédominant de nos sociétés. Le calcul différentiel exprimé en mois impose toutefois d’affronter une hétérogénéité structurelle fondamentale : l’inégalité de la durée des mois civils, oscillant de 28 à 31 jours.
4.1 Mécanique d’incrémentation mensuelle selon l’unité « M »
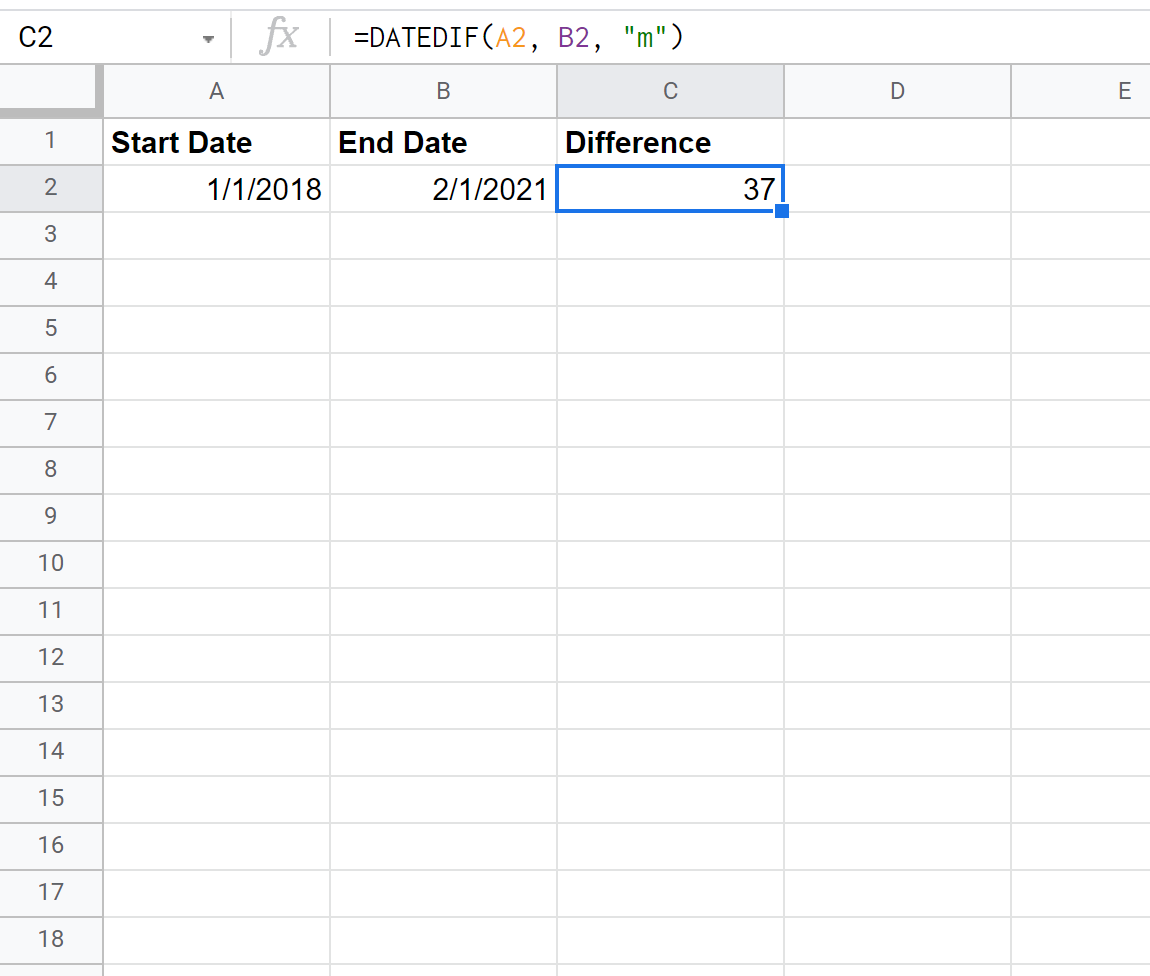
Pour quantifier l’écart séparant deux dates en termes de mois pleins, Google Sheets met à disposition le paramètre « M » au sein de la fonction DATEDIF :
=DATEDIF(A2; B2; « M »)
L’algorithme interne gouvernant l’unité « M » opère selon le principe strict du mois calendaire révolu « de quantième à quantième ». Cela implique qu’un mois complet n’est comptabilisé que si la date terminale a atteint ou dépassé le même numéro de jour dans le mois (le quantième) que celui porté par la date initiale. À titre d’exemple, l’intervalle s’étendant du 15 janvier au 14 février sera évalué à 0 mois, tandis que l’intervalle s’étendant du 15 janvier au 15 février sera exactement valorisé à 1 mois.
Ce mécanisme repose sur une règle de troncature automatique excluant impérativement les fractions de mois non achevées. L’approche offre une supériorité méthodologique absolue par rapport aux formules divisionnaires artisanales consistant à diviser la soustraction des jours par un coefficient moyen tel que 30,4375 (la durée moyenne d’un mois dans le cycle grégorien de 400 ans). Ces approximations arithmétiques génèrent des valeurs décimales ambiguës dont l’arrondi aléatoire fausse les catégorisations réglementaires ou cliniques.
4.2 Cas d’usage : Suivi des cohortes et périodicité des protocoles
L’évaluation rigoureuse des mois révolus est incontournable dans le cadre des essais cliniques et des études longitudinales en sciences sociales. Lorsqu’un protocole expérimental prescrit une administration de traitement tous les trois mois ou une batterie de tests cognitifs semestrielle, l’éligibilité temporelle d’un participant doit être calculée de façon robuste. La standardisation de l’ancienneté d’inclusion selon la formule =DATEDIF(date_inclusion; AUJOURDHUI(); « M ») permet de déterminer avec certitude si le sujet se situe dans la fenêtre temporelle exacte assignée à sa visite de contrôle.
De même, dans les recherches en psychologie du développement, l’acquisition de jalons linguistiques ou moteurs chez le nourrisson est corrélée à son âge exprimé en mois de vie. Utiliser un comptage strict de quantième à quantième garantit que l’enfant n’est qualifié d’âgé de 12 mois qu’au jour précis de son premier anniversaire civil, et non plusieurs jours auparavant sous l’effet pervers d’un raccourcissement artificiel induit par un mois de février à 28 jours.
L’harmonisation des indicateurs de conformité méthodologique au sein d’une base de données multicentrique repose ainsi sur une définition opérationnelle non contestable du mois. L’agrégation des données de suivi mensuel permet de construire des matrices d’observation temporelles sans risque de chevauchement ou d’omission d’intervalles d’évaluation critiques.
4.3 Gestion des quantièmes de fin de mois atypiques
La confrontation de l’algorithme DATEDIF aux fins de mois irrégulières révèle des particularités logiques qu’il est impératif d’anticiper pour prévenir toute contestation méthodologique. La problématique survient principalement lorsque la date de départ correspond à un quantième absent du mois de la date d’arrivée, situation emblématique observée lors des transitions débutant les 29, 30 ou 31 d’un mois pour s’achever au cours d’un mois plus court.
Considérons l’intervalle séparant le 31 janvier d’une année commune du 28 février de la même année. Le mois de février ne comportant pas de 31e jour, la question se pose de savoir si un mois complet s’est écoulé. Selon la convention adoptée par le moteur de Google Sheets, l’algorithme exige que le mois calendaire soit intégralement traversé pour déclencher l’incrémentation. Ainsi, l’écart entre le 31 janvier et le 28 février sera comptabilisé comme 0 mois révolu ; il faudra atteindre le 1er mars (ou le 29 février lors d’une année bissextile) pour voir le compteur basculer à 1 mois.
Cette disparité de traitement entre mois courts et mois longs produit des effets de seuil asymétriques. Pour pallier cette variabilité inhérente aux conventions civiles dans les contextes où l’on souhaite considérer le dernier jour d’un mois comme équivalent au dernier jour du mois suivant, des constructions logiques complémentaires adossées aux fonctions FIN.MOIS doivent être articulées. L’analyste doit mesurer l’impact de cette variance sur la variance globale de son échantillon, particulièrement lorsque la taille des cohortes temporelles est restreinte.
5. Mesure des écarts en années : Maîtrise de l’unité « Y »
L’évaluation des écarts pluriannuels cristallise les enjeux liés à la définition légale, clinique et démographique du passage du temps. Qu’il s’agisse de documenter l’âge exact d’une personne physique ou de mesurer l’exposition prolongée à une condition expérimentale au cours d’une carrière, l’unité « Y » (pour « Years ») apporte une réponse algorithmique formelle.
5.1 Calcul de l’âge chronologique strict avec l’unité « Y »
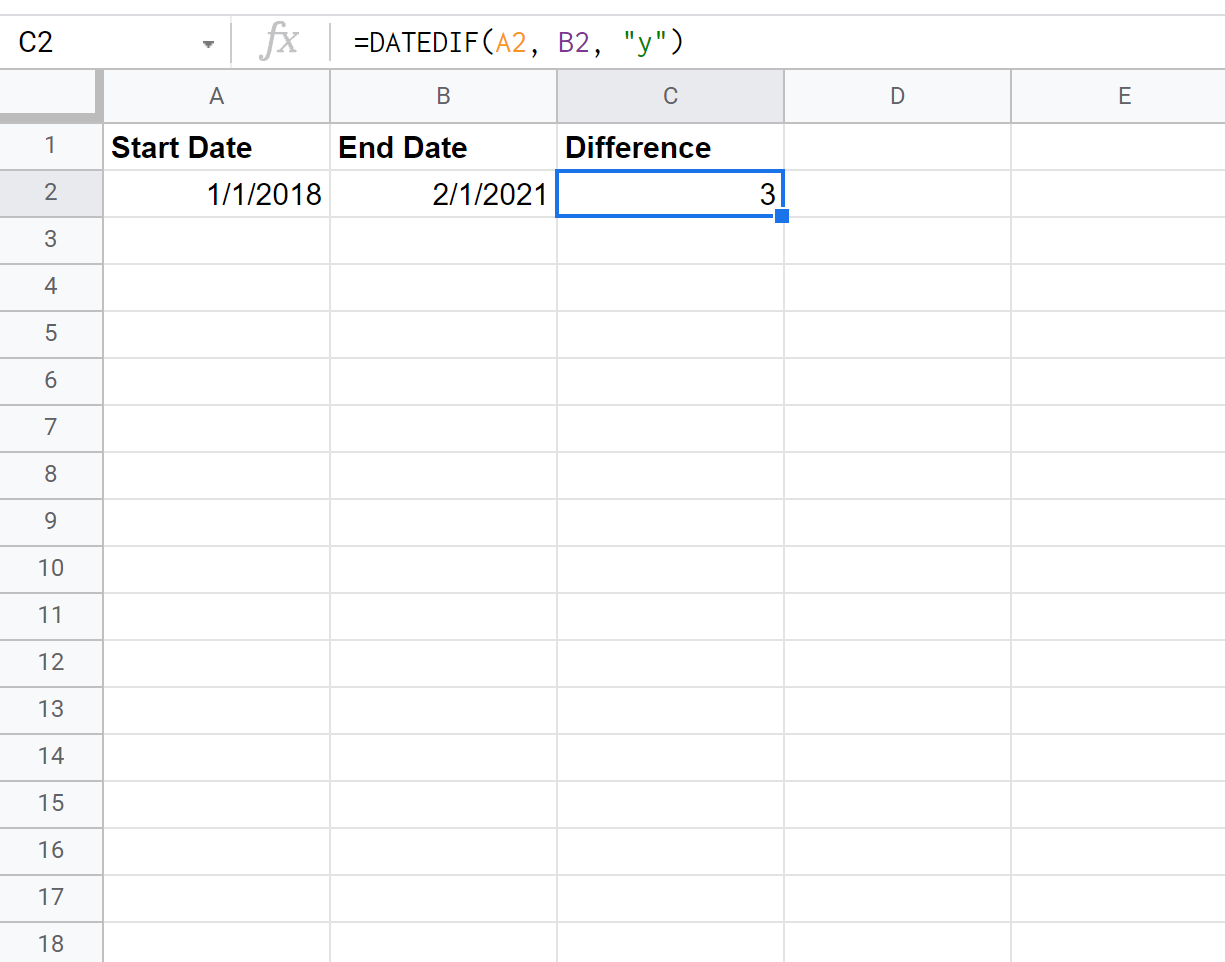
La formulation conventionnelle dédiée à l’extraction de l’âge civil en années révolues s’exprime selon le modèle suivant :
=DATEDIF(date_naissance; date_observation; « Y »)
Dans ce cadre, la fonction calcule le nombre d’années complètes écoulées entre le jalon natal et le jour de la passation ou de l’évaluation. L’algorithme obéit à la règle coutumière et juridique selon laquelle une personne n’acquiert une année d’âge supplémentaire qu’au jour précis de son anniversaire civil, excluant toute anticipation, fût-elle d’une seule fraction de journée.
Cette approche élimine définitivement les approximations fallacieuses consistant à diviser la soustraction arithmétique de deux dates par 365 ou 365,25. De telles divisions génèrent des biais notables : en raison de l’alternance des années bissextiles, une formule du type =(B2 – A2)/365,25 peut faire basculer artificiellement un sujet vers un âge supérieur la veille de son anniversaire véritable, ou retarder ce basculement au lendemain. Pour la constitution de registres médicaux ou la stratification d’échantillons en classes d’âge normalisées, seule la métrique discrète issue de l’unité « Y » assure une parfaite conformité déontologique et légale.
5.2 Analyse de la fidélité des mesures longitudinales pluriannuelles
Dans l’investigation empirique au long cours, telle que l’analyse prospective des effets différés de politiques publiques ou le suivi d’essais vaccinaux sur une décennie, l’échantillonnage à pas annuel permet de s’affranchir des fluctuations saisonnières ou circadiennes susceptibles de parasiter les signaux mesurés. L’évaluation standardisée du temps d’exposition thérapeutique via l’unité « Y » fournit une variable ordinale d’une parfaite fiabilité temporelle.
Néanmoins, la granularité annuelle induit une perte d’information quant à la dynamique continue des phénomènes observés. Dans les protocoles pédiatriques ou les études relatives au développement précoce du nourrisson, une résolution à l’échelle de l’année est totalement inopérante, un écart de douze mois séparant des stades neurodéveloppementaux incomparables. L’analyste doit impérativement identifier le seuil de basculement où la mesure en années doit céder la place à une mesure mensuelle voire journalière.
Par ailleurs, lors de la conduite d’études historiques embrassant des registres séculaires, l’analyste doit s’assurer que les dates manipulées demeurent dans le domaine de validité computationnel du tableur, qui ne saurait traiter avec exactitude les événements antérieurs au point d’origine sériel du 30 décembre 1899 sans le recours à des modules logiciels personnalisés sous Google Apps Script.
5.3 Comparaison entre DATEDIF(« Y ») et FRACTION.ANNEE
Il existe dans la bibliothèque des fonctions de Google Sheets une alternative mathématique substantielle à la fonction DATEDIF(« Y ») : la fonction FRACTION.ANNEE (équivalent francophone de la fonction YEARFRAC). La structure syntaxique de cette dernière s’énonce comme suit :
=FRACTION.ANNEE(date_début; date_fin; [base])
La différence conceptuelle séparant ces deux instructions est fondamentale. Alors que DATEDIF(« Y ») procède à une discrétisation systématique par troncature entière, renvoyant un scalaire entier, FRACTION.ANNEE renvoie un nombre à virgule flottante représentant la proportion précise de l’année écoulée entre les deux bornes calendaires. Par exemple, pour un intervalle de six mois, DATEDIF renverra 0, tandis que FRACTION.ANNEE renverra approximativement 0,5.
De surcroît, FRACTION.ANNEE intègre un argument facultatif hautement sophistiqué désigné par [base], qui permet de stipuler la convention de décompte des jours :
- Base 0 : Convention américaine 30/360 (couramment usitée dans l’industrie obligataire).
- Base 1 : Convention exacte/exacte (rapportant le nombre réel de jours écoulés au nombre réel de jours de l’année considérée, gérant idéalement les années bissextiles).
- Base 2 : Convention exacte/360.
- Base 3 : Convention exacte/365.
- Base 4 : Convention européenne 30/360.
Pour reproduire le comportement discret de DATEDIF tout en bénéficiant de la souplesse de FRACTION.ANNEE, certains analystes combinent cette dernière avec la fonction TRONQUE : =TRONQUE(FRACTION.ANNEE(A2; B2; 1)). Toutefois, sur le plan de la parcimonie algorithmique, DATEDIF demeure le choix préconisé pour l’extraction de l’âge civil en années complètes.
6. Combinaisons avancées : Les unités résiduelles « YM », « YD » et « MD »
Au-delà des métriques d’intervalles absolues, la puissance analytique de la fonction DATEDIF réside dans sa capacité à décomposer un différentiel temporel global en composantes vectorielles modulaires. Grâce aux arguments d’unités résiduelles, il devient possible d’isoler les fractions de temps restantes après soustraction des unités supérieures.
6.1 Extraction des mois résiduels via l’argument « YM »
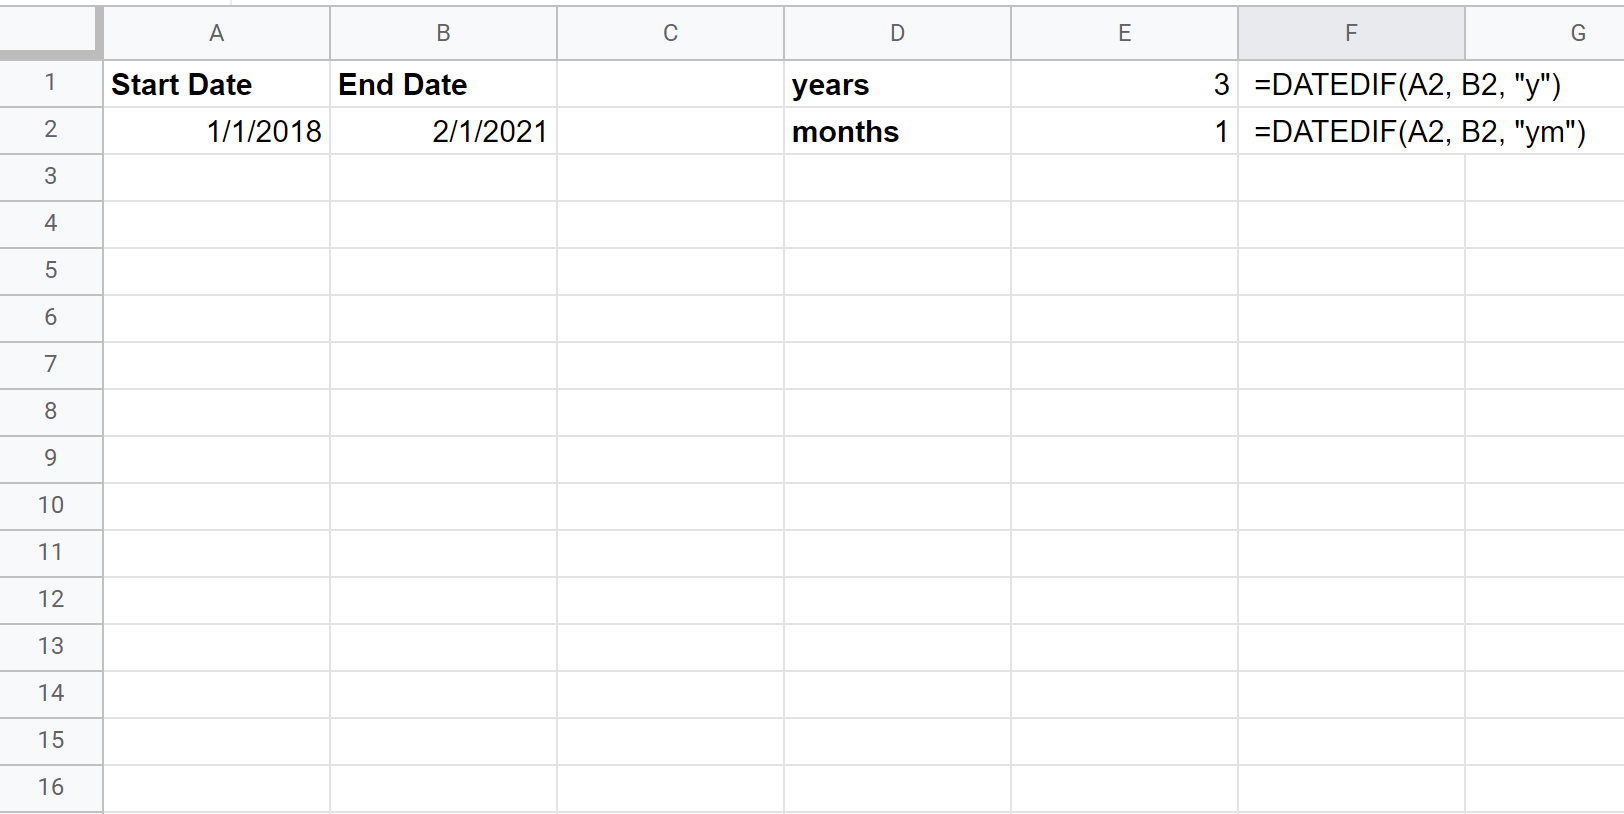
L’unité « YM » (pour « Years-Months ») calcule le nombre de mois calendaires complets séparant deux dates après avoir préalablement et mathématiquement extrait toutes les années complètes écoulées. La formule se configure ainsi :
=DATEDIF(A2; B2; « YM »)
Le résultat produit par cette instruction est obligatoirement un nombre entier borné de manière inclusive entre 0 et 11. Par exemple, si l’intervalle séparant deux repères calendaires s’établit à 2 ans et 7 mois, la fonction configurée avec l’unité « Y » retournera la valeur 2, tandis que la même formule paramétrée avec « YM » restituera isolément le solde de 7 mois.
Cette opération réalise une décomposition modulaire élégante, dispensant l’opérateur d’avoir à formuler de fastidieuses opérations d’arithmétique modulaire manuelle pour retrancher les blocs de douze mois. L’algorithme assure une synchronisation parfaite des quantièmes interannuels sans subir de dérive liée aux années bissextiles intercalées.
6.2 Isolement des jours résiduels sans considérer les années : L’unité « YD »
L’unité résiduelle « YD » (pour « Years-Days ») permet d’extraire la distance journalière résiduelle séparant le quantième de début du quantième de fin, comme si les deux événements s’étaient produits au cours de la même année calendaire. La syntaxe canonique est la suivante :
=DATEDIF(A2; B2; « YD »)
Cette métrique s’avère particulièrement pertinente dans les disciplines telles que la chronobiologie, l’agronomie expérimentale ou l’épidémiologie environnementale, où les chercheurs étudient des phénomènes saisonniers ou des rythmes circannuels. Par exemple, pour déterminer si des pics d’allergies printanières se manifestent à la même distance temporelle relative chaque année, l’unité « YD » neutralise le décalage des années civiles pour mesurer un écart de calendrier pur.
Il importe toutefois de souligner une précaution méthodologique relative à l’intercalation du 29 février : si l’intervalle enjambe une fin de mois de février bissextile dans l’une des années mais non dans l’autre, des asymétries de 24 heures peuvent survenir. L’analyste doit documenter explicitement cette variabilité lors de l’intégration du résidu journalier dans des modèles prédictifs continus.
6.3 Calcul des jours résiduels au sein du mois courant avec l’unité « MD »
L’unité « MD » (pour « Months-Days ») constitue le jalon ultime de la décomposition vectorielle d’un intervalle temporel. Elle calcule le nombre de jours calendaires subsistant entre deux dates après déduction complète de toutes les années et de tous les mois entiers révolus :
=DATEDIF(A2; B2; « MD »)
La valeur retournée est un entier théoriquement compris entre 0 et 30 jours, dépendant de la longueur spécifique du mois précédent la date terminale. Elle permet de répondre précisément à la question : « Combien de jours supplémentaires se sont écoulés depuis le franchissement du dernier mois complet ? ».
Il est impératif d’émettre ici un avertissement technique rigoureux à l’attention des analystes de données : l’algorithme sous-jacent à l’unité « MD » dans les moteurs de calcul historiques (dont Google Sheets et Microsoft Excel partagent la logique patrimoniale) comporte une anomalie algorithmique documentée sur certaines transitions calendaires critiques impliquant des fins de mois inégales (notamment entre fin janvier et début mars). Dans certaines configurations exceptionnelles, l’algorithme peut renvoyer une valeur négative ou un résultat numériquement incohérent.
Pour s’assurer d’une fiabilité absolue lors de la production de rapports scientifiques critiques, il est vivement recommandé de procéder à une validation croisée arithmétique. Celle-ci peut s’opérer en recalculant les jours résiduels au moyen d’une soustraction entre la date de fin et une date intermédiaire reconstituée via la fonction DATE et MOIS, garantissant ainsi l’étanchéité formelle des calculs statistiques.
7. Concaténation et restitution textuelle structurée des intervalles
La production de livrables scientifiques, de dossiers d’inclusion médicale ou de tableaux de bord exécutifs ne saurait se contenter de colonnes disjointes isolant les années, les mois et les jours. La restitution d’un intervalle sous forme d’une chaîne linguistique articulée (par exemple « 4 ans, 3 mois et 12 jours ») constitue une exigence ergonomique fondamentale pour la transmission limpide des résultats.
7.1 Construction d’expressions composites lisibles pour l’expérimentateur
L’assemblage des composantes discrètes issues de DATEDIF fait intervenir les opérateurs de concaténation de chaînes de caractères. Dans Google Sheets, l’opérateur esperluette (&) permet de fusionner des résultats de calculs algorithmiques avec des constantes textuelles descriptives. La formulation canonique s’articule comme suit :
=DATEDIF(A2; B2; « Y ») & » ans, » & DATEDIF(A2; B2; « YM ») & » mois et » & DATEDIF(A2; B2; « MD ») & » jours »
Cette formule évalue simultanément les trois dimensions de l’intervalle temporel et compile une représentation synthétique immédiatement interprétable au sein d’une cellule unique. Cette pratique optimise l’encombrement spatial des visualisations de données tout en offrant aux cliniciens et chercheurs une lecture instantanée de l’ancienneté d’un sujet ou de la durée exacte d’une phase expérimentale sans exiger d’effort cognitif de conversion mentale.
7.2 Gestion des règles d’accord grammatical et de modularité linguistique
La formule élémentaire de concaténation présente une faiblesse esthétique et linguistique manifeste : elle ne tient pas compte des accords de nombre au singulier et au pluriel, produisant fréquemment des énoncés disgracieux tels que « 1 ans, 0 mois et 1 jours ». Pour satisfaire aux normes d’excellence rédactionnelle exigées par les publications académiques et institutionnelles, il convient d’encapsuler chaque segment temporel au sein d’une structure conditionnelle régie par la fonction SI.
Une construction robuste doit accomplir deux missions : accorder les lexèmes en fonction de la valeur quantitative (singulier pour 0 ou 1, pluriel pour les valeurs supérieures) et masquer de manière proactive les composantes nulles pour éviter des mentions redondantes :
=SI(DATEDIF(A2;B2; »Y »)>0; DATEDIF(A2;B2; »Y ») & SI(DATEDIF(A2;B2; »Y »)>1; » ans « ; » an « ); « ») & SI(DATEDIF(A2;B2; »YM »)>0; DATEDIF(A2;B2; »YM ») & » mois « ; « ») & SI(DATEDIF(A2;B2; »MD »)>0; DATEDIF(A2;B2; »MD ») & SI(DATEDIF(A2;B2; »MD »)>1; » jours »; » jour »); « »)
Bien que d’une complexité typographique apparente plus élevée, cette automatisation produit des restitutions narratives d’une élégance irréprochable sans nécessiter l’exécution de scripts externes susceptibles de ralentir le classeur.
7.3 Emploi conjoint des fonctions TEXTJOIN et JOINDRE.TEXTE
Pour optimiser la lisibilité des formules complexes et éradiquer définitivement la présence d’espaces orphelines ou de séparateurs erratiques lorsque certaines composantes temporelles équivalent à zéro, Google Sheets propose la fonction JOINDRE.TEXTE (ou son équivalent anglophone TEXTJOIN). Cette fonction se structure autour de trois paramètres principaux : un délimiteur unifié, un booléen ordonnant l’omission des cellules vides, et les chaînes de caractères à compiler.
En articulant judicieusement JOINDRE.TEXTE avec des blocs conditionnels SI renvoyant une chaîne vide en cas de valeur nulle, l’analyste crée un flux d’affichage dynamique où les séparateurs (comme la virgule ou le mot de liaison « et ») ne sont intercalés qu’entre les unités effectivement présentes. Cette pratique simplifie considérablement la maintenance du code au sein des matrices de données de recherche partagées et assure une standardisation exemplaire lors des phases d’exportation vers des suites d’analyses statistiques spécialisées.
8. Gestion des dates dynamiques et calculs temporels en temps réel
Dans de multiples scénarios de surveillance continue — veille épidémiologique, pharmacovigilance ou gestion prévisionnelle des échéances de protocoles —, l’intervalle temporel ne relie pas deux dates historiques statiques, mais mesure l’écart séparant un événement antérieur de l’instant présent. Cette dimension dynamique transforme le tableur en un système réactif en continu.
8.1 Calculs asynchrones à partir de la fonction AUJOURDHUI
La fonction AUJOURDHUI() constitue le pivot central de la mesure dynamique du temps dans Google Sheets. Dépourvue d’arguments, elle interroge l’horloge système de l’infrastructure serveurs de Google pour renvoyer la valeur sérielle entière correspondant au jour calendaire courant. Son imbrication au sein de la fonction DATEDIF s’opère naturellement :
=DATEDIF(A2; AUJOURDHUI(); « D »)
Cette formule recalcule de manière automatique l’ancienneté d’admission d’un patient hospitalisé ou le nombre de jours écoulés depuis le début d’un essai thérapeutique lors de chaque réouverture de la feuille de calcul ou lors de la modification de toute cellule dépendante. Il convient de souligner que AUJOURDHUI() est une fonction volatile : son exécution systématique à chaque cycle de recalcul impose une consommation de ressources mémoires qu’il convient de modérer au sein des classeurs massifs comportant des dizaines de milliers de lignes sous peine de dégrader les temps de réponse du navigateur.
8.2 Suivi des jalons de recherche et alertes d’échéance
L’association de calculs différentiels dynamiques et de mécanismes de mise en forme conditionnelle permet d’ériger de véritables systèmes d’alerte méthodologique. Dans le cadre d’un protocole où une biopsie de contrôle doit être obligatoirement effectuée à 90 jours (avec une marge de tolérance de plus ou moins 5 jours), l’analyste peut concevoir une colonne différentielle calculant l’écart restant :
=date_butoir – AUJOURDHUI()
En appliquant des règles graphiques automatisées sur cette colonne (par exemple un surlignage chromatique rouge dès lors que l’écart devient inférieur à 7 jours, ambre entre 8 et 15 jours, et vert au-delà), l’équipe clinique dispose d’un outil de pilotage opérationnel en temps réel. Cette proactivité organisationnelle prévient de manière drastique les déviations de protocoles et l’apparition de données manquantes consécutives au dépassement non anticipé des fenêtres de visite autorisées.
8.3 Précautions relatives à la volatilité temporelle en recherche expérimentale
Si la volatilité de la fonction AUJOURDHUI() apporte un confort incontestable pour le suivi opérationnel, elle représente un danger épistémologique majeur pour la recherche expérimentale et la reproductibilité des analyses de données. Dans un essai conduit sous le référentiel des Bonnes Pratiques Cliniques (BPC/ICH), le temps doit impérativement pouvoir être figé à des jalons d’analyse prédéterminés (clôture de base, gel d’étape intermédiaire).
Conserver des formules volatiles au sein d’un jeu de données d’archives expose l’équipe de recherche au risque d’une altération insidieuse des variables dérivées : une analyse descriptive réexécutée six mois plus tard sur la même feuille affichera des âges et des durées de traitement artificiellement gonflés par le glissement continu de l’horloge système. Il est donc indispensable, lors de chaque phase de gel des données, de convertir systématiquement les colonnes dynamiques en valeurs constantes au moyen de l’opération canonique : Édition > Copier, puis Édition > Collage spécial > Coller uniquement les valeurs. Cette traçabilité documentaire garantit la reproductibilité des calculs statistiques ultérieurs.
9. Fonctions alternatives pour le calcul d’intervalles ouvrés et ouvrables
Le temps calendaire continu, mesuré de façon universelle par DATEDIF, ne coïncide pas nécessairement avec le temps d’activité effectif d’un laboratoire, d’un centre hospitalier ou d’une organisation industrielle. Lorsque la métrique d’intérêt réside dans l’effort humain ou l’avancement opérationnel d’un projet de recherche, l’analyste doit mobiliser des algorithmes capables d’exclure les interruptions d’activité institutionnelles et hebdomadaires.
9.1 Quantification de l’effort expérimental via NB.JOURS.OUVRES
La fonction NB.JOURS.OUVRES répond spécifiquement à la problématique de la mesure du temps de travail productif en éliminant d’emblée les fins de semaine conventionnelles (samedis et dimanches) ainsi qu’un répertoire librement personnalisable de jours fériés. Sa signature syntaxique se décline ainsi :
=NB.JOURS.OUVRES(date_début; date_fin; [jours_fériés])
L’argument facultatif [jours_fériés] consiste en une référence vectorielle pointant vers une plage de cellules contenant les dates calendaires chômées spécifiques à l’institution ou au pays d’exercice de l’équipe de recherche. L’algorithme dénombre l’ensemble des jours compris entre la date de départ et la date d’arrivée, identifie et retranche chaque samedi et dimanche, puis soustrait tout jour férié stipulé tombant au cours d’un jour de semaine.
Cette approche fournit une estimation d’une rigueur absolue pour calculer le délai effectif de traitement d’échantillons biologiques en laboratoire ou quantifier la charge de travail requise pour la saisie de formulaires d’observation clinique dans les systèmes d’acquisition électronique de données.
9.2 Personnalisation des rythmes hebdomadaires avec NB.JOURS.OUVRES.INTL
Dans un contexte international ou au sein de structures fonctionnant selon des régimes de travail atypiques (tels que les services d’urgences hospitalières, les animaleries de recherche ou les laboratoires ouverts 6 jours sur 7), la définition conventionnelle du week-end occidental du samedi-dimanche devient obsolète. La fonction NB.JOURS.OUVRES.INTL a été conçue pour offrir une paramétrisation exhaustive des jours de repos :
=NB.JOURS.OUVRES.INTL(date_début; date_fin; [week_end]; [jours_fériés])
Le paramètre [week_end] peut être instancié de deux manières distinctes : soit par le truchement d’un code numérique standardisé (par exemple 1 pour samedi-dimanche, 2 pour dimanche-lundi, 11 pour dimanche uniquement), soit, de manière beaucoup plus puissante, via une chaîne de masquage binaire composée strictement de sept caractères « 0 » ou « 1 » représentant les jours consécutifs du lundi au dimanche. Dans cette chaîne de masquage, un « 1 » dénote un jour de repos non ouvré, tandis qu’un « 0 » spécifie un jour ouvré normal.
Par exemple, une chaîne de masquage formulée sous la syntaxe « 0000010 » définit une semaine opérationnelle où seul le samedi est considéré comme chômé, le dimanche demeurant ouvré. Cette granularité permet d’harmoniser avec une fidélité absolue les plannings et les décomptes d’intervalles au sein de cohortes d’études multicentriques implantées dans des régions géographiques aux traditions hebdomadaires divergentes, telles que le Moyen-Orient ou l’Asie du Sud.
9.3 Comparaison fonctionnelle entre DATEDIF et les fonctions de jours ouvrés
Le tableau analytique ci-dessous synthétise les critères d’arbitrage méthodologique régissant le choix entre DATEDIF et les fonctions spécialisées de calcul d’intervalles ouvrés en contexte expérimental :
- DATEDIF(« D ») : Mesure le temps physique continu absolu. Aucun jour n’est exclu. Idéal pour les constantes biologiques, la cinétique enzymatique, l’âge chronologique, les durées de survie et la modélisation statistique causale.
- NB.JOURS.OUVRES : Mesure le temps organisationnel standardisé. Exclut automatiquement le samedi et le dimanche et les jours fériés spécifiés. Approprié pour les délais de transmission logistique, le temps de revue des comités de protection des personnes et la gestion de projet clinique.
- NB.JOURS.OUVRES.INTL : Mesure le temps opérationnel sur-mesure. Permet une définition binaire intégrale des rythmes de repos hebdomadaires. Recommandé pour les essais internationaux multicentriques et les unités de recherche à astreinte permanente.
Confondre ces deux catégories temporelles engendre des erreurs d’inférence substantielles. Attribuer à un phénomène purement biologique un délai mesuré en jours ouvrés introduirait une variance artificielle induite par le calendrier civil, tandis qu’évaluer la performance administrative d’une équipe de recherche sur la base des jours calendaires bruts ignorerait les contraintes légales d’activité, faussant l’allocation des ressources.
10. Gestion des anomalies, validation des formats et résolution des erreurs
L’intégrité computationnelle d’un jeu de données temporelles est fréquemment compromise par des anomalies de saisie, des incohérences topologiques de dates ou des divergences de formatage typographique. L’élaboration d’une feuille de calcul scientifique exige la mise en œuvre d’une architecture défensive systématique pour neutraliser ces artefacts à la source.
10.1 Diagnostic et résolution de l’erreur #NUM! dans DATEDIF
L’occurrence de l’erreur #NUM! lors de l’exécution de la fonction DATEDIF signale quasi universellement une violation de la relation d’ordre chronologique fondamentale : la valeur sérielle de date_début s’avère strictement supérieure à celle de date_fin. Confronté à un intervalle négatif, le moteur interne interrompt le traitement et émet ce message d’anomalie numérique.
Dans les registres volumineux compilant des saisies manuelles décentralisées, des inversions accidentelles entre la date d’apparition d’un symptôme et la date de consultation médicale sont fréquentes. Pour immuniser la chaîne de calcul contre ces ruptures d’évaluation, une formulation défensive élégante consiste à ordonner dynamiquement les deux arguments en combinant les fonctions scalaires MIN et MAX :
=DATEDIF(MIN(A2; B2); MAX(A2; B2); « D »)
En assignant systématiquement la valeur temporelle la plus ancienne à la borne inférieure via MIN(A2; B2) et la plus récente à la borne terminale via MAX(A2; B2), l’analyste neutralise l’erreur #NUM! et garantit le calcul de la distance chronologique absolue séparant les deux jalons, quelle que soit leur disposition relative dans les colonnes d’origine.
10.2 Résolution de l’erreur #VALEUR! liée aux formats de date corrompus
L’émergence de l’erreur d’évaluation #VALEUR! traduit l’incapacité structurelle du moteur de Google Sheets à interpréter l’une des cellules cibles comme un nombre sériel valide. Ce phénomène se produit de manière privilégiée lors de l’importation de fichiers CSV hétérogènes au sein desquels les dates sont encapsulées sous forme de chaînes de texte brutes, fréquemment polluées par des séparateurs atypiques ou des inversions de mois et de jours.
Pour diagnostiquer rigoureusement la cause sous-jacente d’une cellule suspecte, l’analyste peut recourir à la fonction d’audit logique ESTNUM :
=ESTNUM(A2)
Si la formule renvoie FAUX alors que la cellule affiche visuellement un libellé de date, la nature textuelle de la valeur est formellement démontrée. La remédiation nécessite alors le déploiement de la fonction DATEVAL, chargée de convertir une chaîne alphanumérique conforme en numéro de série grégorien. Si les formats importés comportent des séparateurs hétéroclites (points, barres d’espacement ou tirets cadratins), l’utilisation d’expressions régulières via la fonction REGEXREPLACE permet de standardiser préalablement la structure textuelle avant de la soumettre à l’analyseur chronologique du tableur.
10.3 Encadrement sécurisé des formules par SIERREUR et ESTERREUR
Dans une architecture de traitement de données à grande échelle destinée à être exportée vers des plateformes d’analyse statistique comme R ou Python, la présence de codes d’erreurs graphiques (#NUM!, #VALEUR!, #N/A) corrompt les matrices d’importation et provoque l’échec des scripts d’analyse inférentielle. Il est donc indispensable d’encapsuler les formules chronologiques au sein de fonctions de confinement d’erreurs.
La fonction SIERREUR offre une syntaxe concise pour intercepter toute anomalie d’évaluation et substituer une valeur de repli prédéfinie (par exemple une cellule vide symbolisée par deux guillemets successifs « », ou une constante conventionnelle de valeur manquante comme -999) :
=SIERREUR(DATEDIF(A2; B2; « D »); « »)
Dans les contextes méthodologiques stricts où la distinction entre les types d’erreurs doit être documentée pour l’audit de qualité des données, la conjonction des fonctions SI et ESTERREUR permet de tracer finement les motifs d’exclusion des dossiers non conformes, assurant la traçabilité des valeurs manquantes dans le rapport d’analyse final.
11. Automatisation matricielle et calculs à grande échelle
Lorsque le volume des observations atteint des dizaines ou des centaines de milliers d’enregistrements, la pratique consistant à étirer manuellement une formule sur toute la hauteur d’une colonne devient prohibitive, source d’erreurs et néfaste pour la mémoire du navigateur. Google Sheets met à disposition des paradigmes matriciels modernes permettant d’automatiser le calcul des intervalles de manière instantanée et centralisée.
11.1 Déploiement sur des jeux de données massifs avec ARRAYFORMULA
La fonction emblématique ARRAYFORMULA permet d’exécuter une instruction scalaire unique sur l’ensemble d’une plage vectorielle en projetant automatiquement les résultats vers le bas sans nécessiter de duplication manuelle de la formule.
Néanmoins, une limite algorithmique majeure doit être signalée : la fonction DATEDIF ne prend pas nativement en charge le calcul matriciel distribué au sein d’une fonction ARRAYFORMULA. L’exécution d’une formule telle que =ARRAYFORMULA(DATEDIF(A2:A; B2:B; « D »)) n’évalue que la première ligne du tableau et échoue à se propager sur les lignes subordonnées.
Pour surmonter cette restriction dans le cadre du calcul d’écarts journaliers, la solution matricielle la plus rapide et la plus économe en ressources consiste à recourir à la soustraction arithmétique vectorielle directe :
=ARRAYFORMULA(SI((A2:A » ») * (B2:B » »); B2:B – A2:A; « »))
Cette instruction soustrait d’un seul coup l’intégralité du vecteur de dates de début A2:A du vecteur de dates de fin B2:B, tout en conditionnant l’opération à la non-vacuité simultanée des deux cellules sources au moyen de la multiplication logique booléenne.
11.2 Calculs conditionnels filtrés via BYROW et LAMBDA
Pour les calculs nécessitant impérativement la logique mensuelle ou annuelle propre à DATEDIF (unités « M », « Y », « YM », etc.) sur des plages matricielles entières, l’apparition des fonctions d’ordre supérieur de la famille LAMBDA a apporté une avancée majeure. L’association de BYROW et de LAMBDA permet d’appliquer la fonction DATEDIF ligne par ligne tout en maintenant une formule unique logée dans l’en-tête de colonne :
=BYROW(A2:B; LAMBDA(ligne; SI(OU(INDEX(ligne; 1; 1)= » »; INDEX(ligne; 1; 2)= » »); « »; DATEDIF(INDEX(ligne; 1; 1); INDEX(ligne; 1; 2); « M »))))
Dans ce modèle d’exécution, la fonction BYROW segmente la plage A2:B en vecteurs unidimensionnels horizontaux (lignes). L’expression LAMBDA encapsule la logique de calcul en évaluant si l’une des cellules de la ligne est vacante avant d’appliquer rigoureusement la fonction DATEDIF. Cette architecture fonctionnelle moderne concilie l’exhaustivité des fonctionnalités de DATEDIF avec les avantages d’une maintenance centralisée du code.
11.3 Gestion des lignes vides au sein des colonnes de calcul matriciel
Un écueil pernicieux inhérent aux formules matricielles étirées sur l’intégralité d’une colonne (telles que A2:A) concerne le traitement involontaire des lignes vacantes situées au bas de la zone de saisie active. Dans l’arithmétique des tableurs, une cellule totalement vide est implicitement évaluée comme ayant une valeur numérique égale à zéro.
Or, nous avons établi que la valeur sérielle 0 correspond précisément au 30 décembre 1899. Par voie de conséquence, si une formule différentielle matricielle n’inclut aucun garde-fou logique, elle tentera de calculer la distance séparant le 30/12/1899 d’une autre cellule vide (également évaluée à 0), ou d’une date valide, remplissant des milliers de lignes de zéros parasites ou de valeurs aberrantes s’étendant sur plus d’un siècle. Outre la pollution visuelle des tableaux de bord, cette anomalie surcharge inutilement la mémoire vive allouée par le navigateur.
L’introduction d’un filtre conditionnel logique préalable — par exemple SI(ESTVIDE(A2:A);; Formule) ou SI(A2:A= » »;; Formule) — garantit que les lignes non renseignées sont ignorées, préservant la propreté structurelle et la célérité computationnelle de la base de données.
12. Bonnes pratiques de standardisation et modélisation des données temporelles
L’exactitude des calculs chronométriques dans Google Sheets ne dépend pas exclusivement de la maîtrise des formules algorithmiques, mais découle tout autant de la gouvernance globale appliquée à la structure des données tout au long de leur cycle de vie. L’adoption de normes d’ingénierie rigoureuses prémunit les projets de recherche contre les dérives analytiques.
12.1 Adoption stricte de la norme internationale ISO 8601
La règle d’or universelle en matière d’ingénierie et de science des données temporelles réside dans l’adoption sans concession de la norme internationale ISO 8601. Ce standard stipule que toute notation calendaire doit impérativement s’articuler selon une hiérarchie descendante d’ordre de grandeur :
AAAA-MM-JJ (par exemple : 2024-04-18)
L’alignement systématique des masques de saisie et des exports de données sur le format ISO 8601 éradique définitivement l’ambiguïté destructrice séparant les conventions régionales américaines (MM/JJ/AAAA) et européennes (JJ/MM/AAAA). Une date enregistrée sous la forme 2024-04-07 est interprétée de façon parfaitement univoque par l’ensemble des systèmes d’exploitation, des serveurs Web et des logiciels de traitement statistique (R, SPSS, Python Pandas, SAS, Stata), assurant une interopérabilité sans faille lors des transferts de données transnationaux.
12.2 Configuration des paramètres régionaux de la feuille de calcul
Un classeur Google Sheets ne fonctionne pas en vase clos : ses algorithmes d’analyse lexicale s’appuient sur les paramètres régionaux (« locale ») assignés au document dans le menu Fichier > Paramètres. Ce paramètre détermine le séparateur syntaxique utilisé au sein des formules ainsi que l’interprétation par défaut des dates non conformes à la norme ISO.
Il est impératif de veiller à l’alignement harmonieux entre la localisation géographique des opérateurs de saisie et les paramètres du classeur. Dans une feuille configurée selon les paramètres de la France, le séparateur d’arguments au sein des fonctions est obligatoirement le point-virgule (;), tandis que le séparateur décimal est la virgule (,). À l’inverse, dans une feuille configurée selon les standards des États-Unis, le séparateur d’arguments est la virgule (,) et le séparateur décimal est le point (.).
Une discordance à ce niveau engendre des corruptions de saisie de grande ampleur, les utilisateurs insérant des points-virgules provoquant des erreurs de syntaxe immédiates, ou saisissant des dates avec des barres obliques interprétées à l’envers. L’audit périodique des métadonnées régionales du document partagé constitue une mesure d’hygiène numérique indispensable dans tout projet collaboratif.
12.3 Documentation méthodologique et dictionnaire des variables dérivées
Conformément aux principes de la science ouverte et de la reproductibilité expérimentale, aucune transformation temporelle ne doit demeurer implicite au sein d’une base de données de recherche. Toute colonne calculant un différentiel de dates (qu’il s’agisse de l’âge d’un participant, d’un délai d’incubation ou d’une durée de traitement) doit faire l’objet d’une consignation explicite au sein d’un feuillet de métadonnées ou d’un dictionnaire des variables dédié.
Cette documentation méthodologique doit obligatoirement stipuler :
- Les cellules d’origine ayant servi de bornes chronologiques (date initiale et date terminale).
- L’algorithme et la fonction précis mobilisés (ex. : DATEDIF avec unité « M », arithmétique vectorielle directe, ou NB.JOURS.OUVRES).
- La règle formelle appliquée pour la gestion des cas limites (quantièmes de fin de mois atypiques, années bissextiles, congés légaux).
- L’unité finale retenue et son caractère discret (années révolues tronquées) ou continu (décimales issues de FRACTION.ANNEE).
- L’historique des versions et modifications apportées aux formules au cours de la vie du projet.
Cette rigueur documentaire garantit que des tiers ou des auditeurs indépendants seront en mesure de recalculer et de vérifier à l’identique l’ensemble des variables dérivées temporelles, préservant ainsi la crédibilité scientifique et la pérennité institutionnelle des travaux menés au sein de l’environnement Google Sheets.
Références
International Organization for Standardization. (2019). Date and time — Representations for information interchange — Part 1: Basic rules (ISO Standard No. 8601-1:2019). https://www.iso.org/standard/70907.html
Google Workspace Documentation. (2024). Fonction DATEDIF dans Google Sheets. Google Support. https://support.google.com/docs/answer/6055612
Google Workspace Documentation. (2024). Fonction NB.JOURS.OUVRES dans Google Sheets. Google Support. https://support.google.com/docs/answer/3093058
International Council for Harmonisation of Technical Requirements for Pharmaceuticals for Human Use. (2016). Integrated addendum to ICH E6(R1): Guideline for good clinical practice E6(R2). ICH Official Guidelines. https://www.ich.org/page/efficacy-guidelines
Wickham, H., & Grolemund, G. (2017). R for data science: Import, tidy, transform, visualize, and model data. O’Reilly Media. https://r4ds.had.co.nz/
Microsoft Corporation. (2023). DATEDIF function. Microsoft Support. https://support.microsoft.com/en-us/office/datedif-function-25dba1a4-2812-480b-84dd-8b32a451b35c