
L’analyse discriminante linéaire (souvent abrégée sous l’acronyme anglophone LDA pour Linear Discriminant Analysis) constitue l’un des piliers méthodologiques fondamentaux de la statistique multivariée et de l’apprentissage automatique supervisé. Développée originellement dans le contexte de la morphométrie et de la taxonomie biologique, cette technique élégante poursuit un double objectif à la fois géométrique et décisionnel : d’une part, réduire la dimensionnalité d’un ensemble de variables explicatives continues en projetant les observations dans un sous-espace vectoriel optimal, et d’autre part, établir des frontières de décision linéaires permettant d’affecter avec une précision quantifiable de nouvelles observations à des catégories mutuellement exclusives. Contrairement aux approches purement descriptives, l’analyse discriminante capitalise sur l’étiquetage préalable des données pour guider la projection factorielle, maximisant de ce fait les écarts perceptibles entre les sous-populations étudiées.
Dans le paysage contemporain de la science des données, où foisonnent des algorithmes hautement paramétriques qualifiés de « boîtes noires », tels que les réseaux de neurones profonds ou les forêts aléatoires, l’analyse discriminante linéaire conserve une place prépondérante au sein du milieu académique et industriel. Sa transparence structurelle, son assise probabiliste bayésienne rigoureuse et son efficacité computationnelle sur des échantillons de taille modeste en font un instrument analytique de premier plan, particulièrement plébiscité en épidémiologie, en bio-informatique, en économétrie et en psychométrie quantitative. L’environnement statistique GNU R, réputé pour son écosystème d’outils d’une puissance inégalée, offre un cadre programmatique idéal pour implémenter, diagnostiquer et interpréter l’analyse discriminante linéaire sous toutes ses coutures mathématiques.
Ce traité exhaustif a pour vocation d’exposer de manière méthodique, rigoureuse et pas à pas l’ensemble des fondements théoriques, des prérequis diagnostiques, des protocoles de codage et des subtilités d’interprétation inhérents à la modélisation discriminante linéaire sous R. En parcourant chaque étape du cycle analytique — depuis la vérification de la normalité multivariée et de l’homoscédasticité matricielle jusqu’à la construction d’hyperplans séparateurs et la validation croisée d’apprentissage —, cet article s’adresse aux chercheurs, analystes de données et statisticiens désireux de maîtriser la puissance prédictive et explicative de la méthode de Fisher dans un cadre scientifique irréprochable.
1. Fondements théoriques et mathématiques de l’analyse discriminante linéaire
1.1 Origine et objectifs de la méthode de Fisher
L’analyse discriminante linéaire puise ses racines historiques directes dans les travaux pionniers du statisticien et généticien britannique Sir Ronald Aylmer Fisher. En 1936, dans son article séminal intitulé The Use of Multiple Measurements in Taxonomic Problems publié dans les Annals of Eugenics, Fisher cherchait à résoudre un défi taxinomique concret soumis par le botaniste Edgar Anderson : comment différencier avec exactitude plusieurs espèces sympatriques d’iris (Iris setosa, Iris versicolor et Iris virginica) à partir de mesures morphologiques continues portant sur la longueur et la largeur de leurs sépales et pétales. Face à l’insuffisance d’une simple juxtaposition d’analyses de variance univariées, Fisher formalisa une approche d’optimisation algébrique combinatoire devenue classique.
Sur le plan conceptuel, il est indispensable de dissocier la démarche de Fisher de celle de l’analyse en composantes principales (ACP) introduite par Karl Pearson et Harold Hotelling. Alors que l’ACP opère une réduction de dimensionnalité strictement non supervisée, cherchant les axes d’inertie maximale sans considération aucune pour une éventuelle appartenance de groupe, la LDA constitue une méthode supervisée. L’objectif fondamental de la méthode fisherienne réside dans la recherche d’une combinaison linéaire des prédicteurs qui maximise le ratio de la variance inter-classes (la dispersion entre les barycentres des groupes) sur la variance intra-classe (la dispersion des individus autour de leur barycentre respectif). En d’autres termes, il s’agit de trouver un axe de projection le long duquel les groupes apparaissent les plus resserrés sur eux-mêmes tout en étant les plus éloignés les uns des autres.
Au fil des décennies, cette méthodologie s’est affranchie de son cadre strictement morphologique pour investir avec succès l’ensemble des sciences quantitatives, et plus particulièrement les sciences du comportement, la psychiatrie expérimentale et la neuropsychologie. Dans ces disciplines, où les chercheurs cherchent fréquemment à discriminer des typologies cliniques distinctes (par exemple, des sous-types d’amnésie, des profils de rémission sous traitement psychotrope ou des degrés de dépendance comportementale) sur la base de batteries complexes de tests psychométriques standardisés, l’analyse discriminante linéaire apporte une clarté interprétative sans équivalent en matérialisant les axes synthétiques qui structurent la divergence des profils observés.
1.2 Formulation mathématique et géométrie de l’espace discriminant
D’un point de vue analytique, considérons un ensemble de données constitué de $n$ observations réparties au sein de $K$ classes distinctes, chaque individu étant décrit par un vecteur de $p$ variables quantitatives explicatives noté $\mathbf{x} in \mathbb{R}^p$. Soit $n_k$ le nombre d’individus appartenant à la classe $C_k$, de sorte que $\sum_{k=1}^K n_k = n$. La moyenne empirique du vecteur des prédicteurs au sein de la classe $C_k$ est désignée par $boldsymbol{\mu}_k = \frac{1}{n_k} \sum_{i in C_k} \mathbf{x}_i$, tandis que la moyenne générale de l’ensemble de l’échantillon est notée $boldsymbol{\mu} = \frac{1}{n} \sum_{i=1}^n \mathbf{x}_i$. La dispersion globale des données se décompose rigoureusement, en vertu du théorème de Huygens, en deux matrices de variance-covariance fondamentales de dimensions $p \times p$ : la matrice de dispersion intra-classe, notée $\mathbf{S}_W$ (pour Within-class scatter matrix), et la matrice de dispersion inter-classes, notée $\mathbf{S}_B$ (pour Between-class scatter matrix).
La matrice de dispersion intra-classe $\mathbf{S}_W$ capture la variabilité résiduelle interne aux groupes. Elle est définie par la somme des matrices de dispersion de chaque groupe :
$$\mathbf{S}_W = \sum_{k=1}^K \sum_{i in C_k} (\mathbf{x}_i – boldsymbol{\mu}_k)(\mathbf{x}_i – boldsymbol{\mu}_k)^T$$
Parallèlement, la matrice de dispersion inter-classes $\mathbf{S}_B$ mesure l’écartement des centres de gravité spécifiques par rapport au centre de gravité global :
$$\mathbf{S}_B = \sum_{k=1}^K n_k (boldsymbol{\mu}_k – boldsymbol{\mu})(boldsymbol{\mu}_k – boldsymbol{\mu})^T$$
L’objectif de Fisher consiste à identifier un vecteur unitaire de projection $\mathbf{w} in \mathbb{R}^p$ maximisant le critère scalaire de Rayleigh généralisé, formalisé par le quotient :
$$J(\mathbf{w}) = \frac{\mathbf{w}^T \mathbf{S}_B \mathbf{w}}{\mathbf{w}^T \mathbf{S}_W \mathbf{w}}$$
La résolution analytique de ce problème d’optimisation sous contrainte s’opère par le calcul différentiel. En égalisant le gradient de $J(\mathbf{w})$ à zéro, on démontre que les vecteurs discriminants optimaux correspondent aux vecteurs propres de l’opérateur $\mathbf{S}_W^{-1} \mathbf{S}_B$. Il s’agit dès lors de résoudre le problème aux valeurs propres généralisées suivant :
$$\mathbf{S}_W^{-1} \mathbf{S}_B \mathbf{w} = \lambda \mathbf{w}$$
Dans ce cadre géométrique, chaque vecteur propre $\mathbf{w}$ définit les coefficients d’une fonction canonique discriminante, et la valeur propre associée $lambda$ quantifie la proportion relative du pouvoir de séparation imputable à cette dimension. De surcroît, la métrique naturelle qui régit l’assignation spatiale au sein de cet espace factoriel n’est point la distance euclidienne canonique, mais la distance de Mahalanobis, laquelle pondère chaque distance spatiale par l’inverse de la matrice de covariance commune, neutralisant ainsi les distorsions d’échelle et les corrélations mutuelles entre les prédicteurs.
1.3 Distinction entre LDA binaire et LDA multivariée à classes multiples
Lorsque le problème de classification implique strictement deux modalités ($K = 2$), l’analyse discriminante linéaire présente des propriétés mathématiques remarquables qui l’apparentent étroitement au modèle linéaire général classique. Dans ce scénario binaire, la matrice $\mathbf{S}_B$ est de rang 1, car le sous-espace reliant les deux barycentres est une droite définie par le vecteur $(boldsymbol{\mu}_1 – boldsymbol{\mu}_2)$. Par conséquent, le vecteur séparateur optimal s’exprime directement sous forme close sans passer par une décomposition spectrale itérative complexe :
$$\mathbf{w} propto \mathbf{S}_W^{-1} (boldsymbol{\mu}_1 – boldsymbol{\mu}_2)$$
Ce résultat établit un pont théorique formel avec la régression par moindres carrés ordinaires (MCO) : si l’on assigne une variable indicatrice binaire convenablement codée comme variable dépendante continue, les coefficients de régression estimés sont strictement proportionnels aux poids discriminants obtenus par la LDA de Fisher.
Dès lors que le nombre de classes dépasse deux ($K ge 3$), nous basculons dans l’analyse discriminante canonique à classes multiples. Puisque la matrice $\mathbf{S}_B$ est construite à partir des $K$ centres de gravité de dimension $p$, son rang algébrique maximal est borné par la quantité $min(p, K – 1)$. Ainsi, le nombre de fonctions discriminantes linéaires non triviales et mutuellement orthogonales ne peut en aucun cas excéder le nombre de groupes diminué d’une unité, ni le nombre de variables descriptives disponibles. Cette contrainte dimensionnelle confère à la LDA une remarquable parcimonie géométrique : par exemple, un problème comportant trois catégories sera intégralement et fidèlement représentable dans un plan factoriel bi-dimensionnel formé par les deux premières variables canoniques, indépendamment du fait que l’on dispose initialement de dix ou cent prédicteurs continus.
Sur le plan décisionnel, l’attribution d’un nouvel individu $\mathbf{x}^*$ repose sur les principes de la théorie bayésienne de la décision. En notant $\pi_k$ la probabilité a priori d’appartenance à la classe $C_k$ (déterminée empiriquement par la proportion observée $\frac{n_k}{n}$ ou imposée par la prévalence connue dans la population générale) et $f_k(\mathbf{x})$ la fonction de densité conditionnelle de la classe, le théorème de Bayes permet d’établir la probabilité a posteriori formelle :
$$P(C_k mid \mathbf{x}^*) = \frac{\pi_k f_k(\mathbf{x}^*)}{\sum_{j=1}^K \pi_j f_j(\mathbf{x}^*)}$$
La règle d’affectation optimale de Bayes attribue l’individu $\mathbf{x}^*$ à la modalité $k$ pour laquelle cette probabilité conditionnelle a posteriori est maximale, ce qui revient à minimiser le risque de classement erroné sous un schéma de coût d’erreur symétrique.
2. Hypothèses statistiques fondamentales et diagnostics préalables
2.1 Hypothèse de normalité multivariée des variables explicatives
L’assise probabiliste de l’analyse discriminante linéaire repose sur l’hypothèse centrale selon laquelle le vecteur aléatoire des prédicteurs $\mathbf{X}$ suit une distribution gaussienne multivariée conditionnellement à chaque classe $C_k$, ce qui s’écrit formellement $\mathbf{X} mid C_k \sim \mathcal{N}_p(boldsymbol{\mu}_k, boldsymbol{\Sigma})$. Cette présomption implique non seulement que chaque variable prise isolément présente une distribution normale unidimensionnelle, mais également que toutes les combinaisons linéaires possibles de ces variables demeurent normalement distribuées. La violation substantielle de cette hypothèse affaiblit le caractère optimal de la règle de décision bayésienne linéaire et altère la fiabilité des probabilités d’appartenance calculées.
Dans l’environnement de calcul R, l’évaluation empirique de cette normalité conjointe exige le recours à des tests d’hypothèse multivariés spécifiques implémentés dans des packages spécialisés tels que MVN ou mvdalab. Les trois épreuves statistiques les plus reconnues sont :
- Le test de normalité multivariée d’Henze-Zirkler, apprécié pour sa remarquable puissance statistique tant sur de petits que sur de grands échantillons.
- Le test de Mardia, qui décompose l’asymétrie multivariée (multivariate skewness) et l’aplatissement multivarié (multivariate kurtosis), fournissant ainsi un diagnostic précis sur la nature géométrique de la déviation.
- Le test de Royston, qui procède par extension conjointe du test de Shapiro-Wilk univarié aux structures de covariance corrélées.
Au-delà des valeurs critiques associées à ces tests formels, dont la sensibilité excessive aux variations mineures dans les grands échantillons peut conduire à des rejets injustifiés, l’inspection visuelle demeure indispensable. Elle s’effectue couramment par le tracé de diagrammes quantile-quantile multivariés (Chi-deux Q-Q plot), où le carré des distances de Mahalanobis des observations par rapport au centre moyen de leur groupe est confronté aux quantiles théoriques d’une loi du $\chi^2$ à $p$ degrés de liberté. En présence d’asymétries prononcées, le praticien mettra en œuvre des stratégies d’assainissement distributif, notamment les transformations de puissance de Box-Cox ou les transformations logarithmiques univariées préalables, afin de rapprocher les variables de la stricte gaussianité.
2.2 Homogénéité des matrices de covariance (homoscédasticité)
L’hypothèse maîtresse différenciant la LDA de ses alternatives quadratiques réside dans l’homogénéité postulée des matrices de variance-covariance intra-groupes. Le modèle impose que toutes les classes partagent strictement la même matrice de dispersion interne, à savoir $boldsymbol{\Sigma}_1 = boldsymbol{\Sigma}_2 = dots = boldsymbol{\Sigma}_K = boldsymbol{\Sigma}$. Cette contrainte algébrique est fondamentale : c’est elle qui garantit que les termes quadratiques dans l’expression des densités de probabilité gaussiennes s’annulent mutuellement lors du calcul des rapports de vraisemblance, réduisant ainsi les frontières de classification à des hyperplans strictement affines ou linéaires dans $\mathbb{R}^p$.
Le protocole canonique pour tester l’égalité de plusieurs matrices de covariance sous R consiste à exécuter le test M de Box, accessible via les packages biotools ou heplots. Ce test évalue l’hypothèse nulle $H_0 : boldsymbol{\Sigma}_1 = boldsymbol{\Sigma}_2 = dots = boldsymbol{\Sigma}_K$ contre l’hypothèse alternative d’une disparité matricielle d’au moins deux groupes. Toutefois, une précaution méthodologique majeure s’impose : le test M de Box est notoirement hyper-sensible aux infractions même subtiles à la normalité multivariée. Une asymétrie des distributions peut engendrer un taux de faux positifs massif, incitant le statisticien à rejeter $H_0$ à tort.
Lorsque l’hétérogénéité des covariances est rigoureusement démontrée — c’est-à-dire que la dispersion spatiale ou les structures de corrélation entre prédicteurs diffèrent substantiellement d’une classe à l’autre —, la LDA perd son statut d’estimateur optimal sans biais. Le maintien obstiné d’un modèle linéaire dans une telle configuration conduit à une sous-estimation systématique du taux d’erreur de classification pour la classe présentant la plus large dispersion, et réciproquement. La méthodologie statistique commande alors d’abandonner la LDA pour s’orienter vers l’analyse discriminante quadratique (QDA), qui alloue à chaque modalité sa propre matrice de covariance $boldsymbol{\Sigma}_k$.
2.3 Absence de multicollinéarité parfaite et gestion des données aberrantes
L’estimation des coefficients discriminants repose mathématiquement sur l’inversion de la matrice intra-classes globale $\mathbf{S}_W$. De ce fait, une interdépendance linéaire stricte ou quasi-parfaite entre deux ou plusieurs prédicteurs entraîne la singularité ou le conditionnement instable de cette matrice. Lorsque le déterminant de $\mathbf{S}_W$ tend vers zéro, le calcul informatique de son inverse par décomposition de Cholesky ou inversion spectrale produit des erreurs numériques massives ou une explosion des variances d’échantillonnage des coefficients discriminants.
Le diagnostic préventif de la multicollinéarité s’établit par le calcul du facteur d’inflation de la variance (VIF pour Variance Inflation Factor) sur l’ensemble des prédicteurs continus. Bien que le VIF soit traditionnellement formalisé dans le contexte de la régression linéaire multivariée, son application via des modèles linéaires auxiliaires sous R permet d’isoler rapidement les variables redondantes. En règle générale, un indice VIF excédant le seuil conventionnel de 5 ou 10 signale une collinéarité dommageable nécessitant soit l’exclusion de l’une des variables en jeu, soit l’agrégation de celles-ci au moyen d’un score composite.
Parallèlement, la présence d’observations aberrantes ou hautement influentes représente une menace critique pour l’analyse discriminante. Les estimateurs des moyennes de groupes $boldsymbol{\mu}_k$ et de la matrice $\mathbf{S}_W$ étant des estimateurs classiques fondés sur les moments d’ordre un et deux, ils exhibent un point de rupture statistique très faible ($1/n$). Une poignée d’individus atypiques peut considérablement déplacer les centroïdes ou étirer artificiellement les covariances communes. L’identification rigoureuse de ces points s’articule autour du calcul des distances de Mahalanobis individuelles calculées au sein de chaque groupe et de l’inspection des leviers. Enfin, une attention soutenue doit être accordée au dimensionnement de l’échantillon : chaque sous-groupe $C_k$ doit impérativement comporter un effectif $n_k$ significativement supérieur au nombre de prédicteurs $p$ (idéalement $n_k > 3p$ voire $5p$) pour prémunir le système contre les pathologies d’indétermination matricielle.
3. Étape 1 : Configuration de l’environnement R et chargement des bibliothèques
3.1 Installation et chargement des packages statistiques de référence
L’écosystème R dispose d’une infrastructure logicielle particulièrement fournie pour conduire l’ensemble des investigations liées à l’analyse discriminante linéaire. Le socle algorithmique indispensable réside dans le package historique MASS (Modern Applied Statistics with S), élaboré par Venables et Ripley, qui contient l’implémentation de référence de la fonction lda(). Cette bibliothèque standard fait partie intégrante de la distribution de base de R, mais nécessite d’être explicitement attachée dans la session de travail.
Pour assurer la visualisation graphique avancée, la manipulation fluide des tables de données, ainsi que l’orchestration des procédures de rééchantillonnage et d’évaluation, le statisticien intègre une suite de packages complémentaires modernes. Le package caret (Classification and REgression Training) s’impose comme la plateforme unifiée privilégiée pour standardiser les protocoles de partitionnement, de validation croisée et d’extraction des métriques d’exactitude. En matière de rendu visuel, la combinaison des librairies ggplot2, ggpubr et scales garantit une liberté totale de personnalisation graphique. Enfin, les bibliothèques biotools et heplots fournissent les primitives nécessaires pour conduire les vérifications d’homoscédasticité multivariée, tandis que le package MVN offre une interface exhaustive pour les tests de normalité.
L’initialisation formelle de l’environnement d’analyse s’exécute traditionnellement au moyen de commandes telles que install.packages(c("MASS", "caret", "ggplot2", "heplots", "biotools", "MVN")) suivi de leurs appels respectifs via la fonction library(). Il convient de prêter une attention rigoureuse aux conflits d’espaces de noms pouvant survenir entre fonctions homologues (comme la fonction select() qui peut être masquée par MASS si dplyr est chargé concomitamment), un risque que l’on neutralisera en recourant à la syntaxe explicite par double deux-points (ex. MASS::lda()).
3.2 Gestion de la reproductibilité et configuration de l’espace de travail
La reproductibilité computationnelle constitue l’un des piliers méthodologiques de toute démarche scientifique contemporaine. Étant donné que les procédures ultérieures impliquent un fractionnement stochastique du jeu de données initial en compartiments d’entraînement et d’évaluation, il est impératif de fixer la graine du générateur pseudo-aléatoire sous-jacent. Cela s’accomplit sans ambiguïté par l’instruction set.seed(42) — ou tout autre entier invariant choisi de manière explicite — avant toute étape d’échantillonnage aléatoire.
Une bonne pratique de laboratoire logiciel consiste également à figer les options d’affichage de la console R afin de favoriser une lecture claire et normalisée des matrices de confusion et des vecteurs de coefficients. L’ajustement du paramètre global via options(digits = 4, scipen = 999) permet de limiter l’arrondi décimal à quatre chiffres significatifs tout en supprimant l’affichage en notation scientifique pour les nombres de magnitude intermédiaire.
Enfin, l’archivage rigoureux des métadonnées de calcul représente une condition sine qua non pour la traçabilité des résultats empiriques. L’appel final à sessionInfo() au sein du script d’analyse documente avec exactitude la version précise de l’interpréteur R, l’architecture du système d’exploitation hôte ainsi que les numéros de version de l’ensemble des bibliothèques dynamiques attachées, prévenant toute disparité future dans le comportement des algorithmes numériques de décomposition spectrale.
4. Étape 2 : Importation, inspection et préparation des données
4.1 Chargement et inspection structurelle du jeu de données
Afin d’illustrer chaque facette opérationnelle de la LDA avec une clarté maximale, l’usage du célèbre jeu de données Fisher’s Iris constitue une démarche didactique irremplaçable. Intégré nativement dans l’environnement de base sous le nom iris, cet ensemble documente 150 spécimens de fleurs réparties équitablement en trois espèces biologiques (50 observations pour setosa, 50 pour versicolor, et 50 pour virginica). Les quatre variables prédictrices continues quantifient la longueur des sépales (Sepal.Length), la largeur des sépales (Sepal.Width), la longueur des pétales (Petal.Length) et la largeur des pétales (Petal.Width), toutes exprimées en centimètres.
L’inspection structurelle préalable débute par l’application de fonctions d’audit globales telles que str(iris), head(iris, 5) et summary(iris). Cette étape cardinale vise à s’assurer que les quatre prédicteurs sont rigoureusement typés en tant que variables numériques à virgule flottante (num) et que la variable cible, Species, est encodée formellement en tant que facteur catégoriel nominal (factor) comportant précisément trois niveaux. La présence accidentelle d’une variable réponse typée en chaîne de caractères (character) compromettrait l’exécution de la fonction lda().
Il est simultanément indispensable de contrôler l’intégrité de la table de données par rapport aux valeurs absentes en formulant l’instruction sum(is.na(iris)). Dans ce jeu historique, aucune valeur manquante n’est présente ; si tel avait été le cas, il aurait fallu statuer entre une imputation multiple par chaînes d’équations (MICE) ou une suppression raisonnée des lignes incomplètes, sous réserve que l’hypothèse de disparition complètement aléatoire (MCAR) soit plausible.
4.2 Analyse exploratoire et statistiques descriptives par groupe
Avant d’ajuster le moindre modèle prédictif, une exploration descriptive approfondie doit cartographier les régularités empiriques sous-jacentes. L’évaluation de la séparabilité primaire des groupes impose le calcul systématique des métriques de tendance centrale (moyennes arithmétiques) et de dispersion (écarts-types) pour chaque prédicteur, conditionnellement aux modalités de la classe cible. Cette stratification statistique s’obtient avec une élégance syntaxique en utilisant le package dplyr via des enchaînements de fonctions d’agrégation groupée (group_by(Species) %>% summarise_all(list(mean = mean, sd = sd))).
L’examen des interrelations linéaires bivariées constitue le second axe incontournable de cette phase exploratoire. La construction d’une matrice de corrélations de Pearson entre les quatre prédicteurs continus permet de déceler d’éventuelles redondances morphologiques. Dans le cas d’iris, il apparaît notoirement que Petal.Length et Petal.Width présentent un coefficient de corrélation linéaire linéaire particulièrement élevé (souvent supérieur à $r = 0.96$), ce qui annonce une contribution conjointe déterminante mais nécessite une vigilance accrue quant à l’inversion matricielle.
Enfin, la synthèse visuelle s’orchestre par la génération de diagrammes de dispersion croisés par paires (pairs plot) enrichis de tracés de densité par noyaux gaussiens stratifiés, au moyen de fonctions telles que pairs() ou de l’utilitaire avancé GGally::ggpairs(). Ces visualisations révèlent immédiatement qu’Iris setosa s’isole géométriquement avec une netteté spectaculaire sur les variables pétalaires, tandis que le chevauchement relatif entre versicolor et virginica constitue le véritable défi d’optimisation discriminante.
4.3 Standardisation et mise à l’échelle des prédicteurs
Sur le plan de la théorie mathématique pure, l’analyse discriminante linéaire possède la propriété remarquable d’être invariante sous toute transformation affine inversible des prédicteurs. Cela signifie que la multiplication d’une variable par une constante scalaire ou l’addition d’une constante de translation ne modifie en rien la qualité intrinsèque de la séparation géométrique, les valeurs propres de Fisher demeurant formellement invariantes et les frontières de classement conservant leur topologie exacte.
Cependant, en pratique appliquée et pour les besoins de l’interprétabilité humaine, la standardisation préalable (centrage sur la moyenne empirique et réduction par l’écart-type empirique via l’application de la fonction scale() de R) s’avère hautement profitable. En ramenant l’ensemble des prédicteurs à une échelle sans unité commune caractérisée par une moyenne nulle ($\mu = 0$) et une variance unitaire ($\sigma^2 = 1$), cette normalisation z-score permet une comparaison directe de la magnitude relative des coefficients associés à chaque fonction discriminante canonique.
Une précaution méthodologique élémentaire, mais fréquemment omise, doit être solennellement rappelée : la normalisation ne doit jamais être exécutée globalement sur la totalité du jeu de données avant le fractionnement en sous-ensembles d’apprentissage et de test. Les paramètres de mise à l’échelle (la moyenne et l’écart-type de référence) doivent impérativement être calculés sur l’unique échantillon d’entraînement, puis appliqués de manière strictly passive sur l’échantillon d’évaluation afin de proscrire toute fuite d’information statistique (data leakage) susceptible de biaiser l’estimation des performances du modèle.
5. Étape 3 : Partitionnement raisonné des données (Apprentissage et Test)
5.1 Principe théorique de la validation croisée d’apprentissage
L’évaluation rigoureuse d’un classifieur statistique impose une distinction étanche entre la phase d’optimisation structurelle des paramètres (l’ajustement des hyperplans et l’estimation des matrices de dispersion) et la phase d’évaluation de son pouvoir de généralisation prédictive. L’ajustement et l’évaluation d’un modèle discriminant linéaire sur un jeu unique de données engendre immanquablement un optimisme de classification — ou biais d’apprentissage —, le modèle ayant capté une partie des fluctuations idiosyncrasiques et du bruit d’échantillonnage propres aux observations disponibles.
L’estimation objective du taux d’erreur futur exige par conséquent de tester les fonctions discriminantes sur un ensemble indépendant d’observations dites « hors échantillon » (out-of-sample data). La répartition équilibrée couramment admise dans la littérature scientifique préconise de consacrer une fraction substantielle des données — typiquement 70 % à 80 % — à l’apprentissage (training set) pour assurer une convergence stable de l’inverse de la matrice intra-classes $\mathbf{S}_W^{-1}$, tout en réservant les 20 % à 30 % restants à l’évaluation pure (testing set).
Ce partitionnement doit impérativement respecter la structure taxonomique du problème par le truchement d’un fractionnement stratifié. Dans les configurations réelles où certaines classes sont naturellement sous-représentées, un échantillonnage aléatoire simple risquerait d’exclure totalement une modalité minoritaire du jeu d’évaluation ou d’en réduire l’effectif à un seuil statistique non significatif, altérant la validité de l’inférence.
5.2 Mise en œuvre du fractionnement stratifié sous R
Pour implémenter ce découpage dans l’environnement R en garantissant une rigueur méthodologique absolue, la fonction createDataPartition() issue du package caret constitue le mécanisme standard d’excellence. Contrairement à une banale fonction d’extraction probabiliste univariée telle que sample(), createDataPartition() analyse la fréquence d’apparition de chaque modalité de la variable réponse fournie en argument et préserve fidèlement ces ratios au sein des deux sous-ensembles créés.
Le protocole de codage s’articule comme suit :
- Définition de l’ancrage pseudo-aléatoire au moyen de l’instruction
set.seed(123)afin d’assurer l’exacte reproductibilité de la sélection d’individus. - Génération du vecteur d’indices d’entraînement par l’instruction
train_index <- createDataPartition(iris$Species, p = 0.80, list = FALSE), ce qui alloue formellement 80 % des données à l’apprentissage et 20 % à la validation. - Scission physique de la table globale en deux sous-structures distinctes :
train_data <- iris[train_index, ]ettest_data <- iris[-train_index, ].
La validation empirique du fractionnement s’effectue immédiatement en inspectant les tables de contingence marginales via l’appel table(train_data$Species) et table(test_data$Species). L’analyste s’assure ainsi que les proportions respectives des espèces sont rigoureusement homogènes d’un sous-ensemble à l’autre (ici, exactement 40 spécimens d’entraînement et 10 spécimens de test pour chacune des trois modalités), sanctuarisant la représentativité comparative de l’étude.
6. Étape 4 : Ajustement et estimation du modèle LDA avec la fonction lda()
6.1 Syntaxe formelle et spécification de l’équation discriminante
L’estimation algorithmique du modèle s’opère au moyen de la fonction fondamentale lda() fournie par la bibliothèque MASS. La signature syntaxique standard de cette fonction repose sur l’idiome des formules symboliques de Wilkinson-Rogers, traditionnellement employé dans l’ensemble de l’écosystème de modélisation statistique de R. La relation fonctionnelle prend la forme générale lda(formula = Species ~ Sepal.Length + Sepal.Width + Petal.Length + Petal.Width, data = train_data), ou plus synthétiquement lda(Species ~ ., data = train_data) dès lors que l’ensemble des colonnes résiduelles constitue les régresseurs prédictifs.
Un paramètre optionnel d’une grande profondeur conceptuelle réside dans l’argument prior. Par défaut, si ce paramètre est omis, la fonction lda() assigne automatiquement à chaque classe une probabilité a priori égale à sa fréquence empirique observée au sein du jeu d’entraînement, soit $\pi_k = n_k / n$. Toutefois, dans les configurations scientifiques où l’échantillon d’apprentissage est artificiellement équilibré (par exemple à la suite d’un suréchantillonnage volontaire en épidémiologie clinique), alors que la prévalence réelle de la pathologie dans la population cible est infinitésimale, le modélisateur peut spécifier manuellement un vecteur probabiliste via prior = c(0.90, 0.05, 0.05), garantissant que la règle d’attribution bayésienne reflète la réalité écologique de terrain.
D’autres arguments spécialisés complètent la commande, tels que l’argument method = "moment" (utilisant les estimateurs classiques non biaisés de la moyenne et de la covariance) ou des approches fondées sur des estimateurs plus robustes (tels que "mve" pour l’estimateur de volume d’ellipsoïde minimal), ainsi que le paramètre CV dédié à l’exécution directe d’une validation croisée unitaire.
6.2 Modélisation pas à pas sur les données d’entraînement
L’ajustement effectif du modèle consiste à instancier l’objet résultat en lui allouant un identifiant pérenne dans l’environnement de session, classiquement via la commande :
modele_lda <- lda(Species ~ ., data = train_data)
Lors de l’exécution interne de cette instruction, R procède à une série d’opérations algébriques denses : centrage des données par classe, estimation de la matrice intra-classes commune $\mathbf{S}_W$ par agrégation pondérée des matrices de covariance empiriques, décomposition spectrale symétrique par décomposition en valeurs singulières (SVD) — algorithme préféré pour sa robustesse numérique à l’inversion matricielle directe — et calcul des vecteurs directeurs maximisant le ratio de dispersion de Fisher.
Durant cette phase critique, le praticien doit observer scrupuleusement les éventuels messages émis dans la console. L’apparition d’un avertissement explicite tel que « variables are collinear » signale immédiatement qu’une variable explicative présente une dépendance linéaire quasi-parfaite avec les autres ou affiche une variance nulle, ce qui contraint l’algorithme à tronquer le rang de l’espace vectoriel d’inversion. Dans le contexte de notre partitionnement d’iris, la commande s’exécute sans la moindre alerte, attestant de l’excellente conditionnalité mathématique de la matrice intra-classes. L’objet modele_lda est alors prêt pour l’analyse structurelle.
7. Étape 5 : Interprétation approfondie des sorties du modèle
7.1 Analyse des probabilités a priori et des moyennes de groupes
L’interrogation textuelle de l’objet ajusté, obtenue simplement en appelant print(modele_lda), restitue une cartographie synthétique extrêmement dense de la morphologie discriminante. Le premier bloc de sortie détaille les Prior probabilities of groups (probabilités a priori des groupes). Dans le cadre de notre entraînement stratifié équilibré sur 120 spécimens, la console affiche une probabilité uniforme de 0.3333 (ou 1/3) pour chacune des trois modalités d’iris. Ces valeurs constituent le point d’ancrage probabiliste préalable à toute observation des caractéristiques physiques d’un individu.
Le second bloc statistique présente la table des Group means (moyennes des groupes). Il s’agit du tableau récapitulant les coordonnées exactes du centre de gravité $boldsymbol{\mu}_k$ de chaque espèce dans l’espace des quatre dimensions d’origine. L’analyse critique de ce tableau révèle des contrastes morphologiques substantiels. Par exemple, pour l’espèce setosa, la moyenne de Petal.Length se situe aux alentours de 1.46 cm, alors qu’elle s’élève respectivement à 4.26 cm pour versicolor et culmine à 5.55 cm pour virginica.
Ces profils moyens multivariés constituent l’assise géométrique fondamentale de l’analyse : c’est l’ampleur des écarts géométriques entre ces barycentres qui fournit la matière première à la matrice de dispersion inter-classes $\mathbf{S}_B$. Les variables dont les moyennes de groupes présentent les plus fortes divergences relatives par rapport à leur variabilité interne émergent intuitivement comme les composantes majeures des futurs axes canoniques de discrimination.
7.2 Interprétation des coefficients des fonctions discriminantes linéaires
Le composant le plus central des résultats de lda() réside dans le tableau intitulé Coefficients of linear discriminants. Ce bloc matriciel fournit les poids réels $\mathbf{w}$ alloués à chaque variable d’origine pour forger les axes discriminants synthétiques successifs (notés traditionnellement LD1 et LD2). Chaque colonne de cette matrice représente formellement l’équation d’une fonction discriminante canonique de Fisher. Par exemple, le premier axe discriminant s’exprime sous la forme :
$$LD1 = w_{11} \times \text{Sepal.Length} + w_{12} \times \text{Sepal.Width} + w_{13} \times \text{Petal.Length} + w_{14} \times \text{Petal.Width}$$
Il importe de souligner avec rigueur la distinction sémantique entre les coefficients bruts (non standardisés) et les coefficients standardisés :
- Les coefficients bruts fournis nativement par R s’appliquent directement aux mesures physiques telles quelles, dans leur unité d’origine (en centimètres). Leurs grandeurs numériques reflètent conjointement l’importance intrinsèque du prédicteur et l’inverse de son amplitude dimensionnelle d’échelle.
- Pour statuer formellement sur l’importance discriminante relative de chaque prédicteur, l’analyste doit examiner les coefficients standardisés, calculés en multipliant le coefficient brut par l’écart-type intra-classe mutualisé de la variable concernée.
L’analyse vectorielle sur les données iris met en lumière que Petal.Length et Petal.Width se voient attribuer des magnitudes pondérales dominantes le long du premier axe canonique LD1. Un score LD1 fortement négatif caractérise de manière quasi-infaillible l’espèce setosa, tandis que des scores intermédiaires et positifs indiquent le basculement progressif vers versicolor et virginica. Le second axe LD2, orthogonal au premier, mobilise principalement la variable Sepal.Width pour raffiner la discrimination géométrique résiduelle entre les deux espèces les plus morphologiquement enchevêtrées.
7.3 Proportion de trace et pouvoir explicatif des axes
Le bloc conclusif de la restitution textuelle indique la Proportion of trace associée à chaque dimension discriminante. Algébriquement, cette valeur correspond au rapport entre la valeur propre $\lambda_m$ associée au $m$-ième axe canonique et la trace totale de l’opérateur de Fisher (la somme des valeurs propres non nulles) :
$$\text{Proportion of trace}_m = \frac{\lambda_m}{\sum_{j=1}^{\min(p, K-1)} \lambda_j}$$
Cet indicateur quantifie avec précision la fraction de l’inertie discriminante globale expliquée par chaque axe factoriel respectif.
Dans l’analyse des données d’iris sous R, les sorties révèlent typiquement qu’environ 99 % de la trace totale est captée par l’unique premier axe LD1, tandis que le second axe LD2 ne concentre qu’approximativement 1 % de l’inertie discriminante résiduelle. Ce déséquilibre spectaculaire démontre que la séparation des trois espèces végétales repose quasi-intégralement sur une structure unidimensionnelle dominante induite par la morphologie des pétales. Même si le second axe demeure mathématiquement indispensable pour lever les dernières ambiguïtés marginales entre versicolor et virginica, il n’apporte qu’un pouvoir séparateur marginal comparativement à l’axe majeur.
8. Étape 6 : Prédiction et classification sur de nouvelles observations
8.1 Utilisation de la méthode générique predict()
Une fois le modèle estimé sur les données d’entraînement, son exploitation opérationnelle s’effectue par l’invocation de la méthode générique predict(), configurée spécifiquement pour la classe d’objet retournée par MASS::lda. L’assignation formelle s’écrit :
predictions_test <- predict(modele_lda, newdata = test_data)
L’entité résultante, predictions_test, n’est pas un simple vecteur catégoriel, mais une structure de type liste composite encapsulant trois éléments analytiques majeurs :
predictions_test$class: Un vecteur factoriel contenant l’étiquette de la classe définitivement assignée à chaque observation du jeu de test en vertu de la règle de décision bayésienne de probabilité maximale.predictions_test$posterior: Une matrice de dimensions $n_{test} \times K$ consignant les probabilités conditionnelles a posteriori d’appartenance à chacune des $K$ modalités pour chaque individu testé.predictions_test$x: Une matrice de dimensions $n_{test} \times \min(p, K-1)$ regroupant les coordonnées factorielles individuelles (ou scores discriminants) de chaque observation projetée dans l’espace canonique des axesLD1etLD2.
L’accès direct aux scores discriminants predictions_test$x offre la possibilité de visualiser précisément la façon dont de nouveaux profils individuels se positionnent par rapport aux barycentres historiques calculés lors de l’apprentissage initial, matérialisant géométriquement la robustesse de l’inférence prédictive.
8.2 Exploitation des probabilités a posteriori d’appartenance
L’exploitation fine de la matrice posterior transcende la simple catégorisation déterministe en fournissant un indicateur fondamental du degré de certitude ou d’ambiguïté associé à chaque décision de classement. Chaque ligne de cette matrice respecte rigoureusement la contrainte de fermeture probabiliste, sa somme vectorielle étant strictement égale à 1 ($\sum_{k=1}^K P(C_k mid \mathbf{x}_i) = 1$).
L’analyste de données consacre une attention soutenue aux cas qualifiés de « frontières ». Lorsqu’une fleur de l’échantillon test présente un profil de probabilités tranché (par exemple $P(\text{setosa}) = 0.999$, $P(\text{versi\color}) = 0.001$, $P(\text{virginica}) = 0.000$), le classement est caractérisé par un degré de confiance maximal. En revanche, si une observation présente des probabilités d’appartenance compétitives (par exemple $P(\text{versi\color}) = 0.52$ et $P(\text{virginica}) = 0.48$), cette indécision signale que le vecteur morphologique se situe géométriquement aux abords immédiats de l’hyperplan séparateur optimal.
Dans de nombreuses applications réelles — singulièrement en diagnostic médical ou en détection de fraude financière —, les coûts associés aux erreurs de classement sont asymétriques. Le seuil de décision standard dicté par le maximum de vraisemblance a posteriori (seuil de $0.5$ dans les problèmes binaires) peut alors être modulé de manière paramétrique pour favoriser la sensibilité au détriment de la spécificité, en imposant une pénalité financière ou clinique formelle aux faux négatifs.
9. Étape 7 : Évaluation rigoureuse des performances et validation croisée
9.1 Construction et lecture critique de la matrice de confusion
L’outil élémentaire de diagnostic des performances d’un modèle de classification réside dans la table croisée de contingence, universellement désignée sous le nom de matrice de confusion. Elle confronte de manière exhaustive les appartenances catégorielles réelles et observées (la vérité de terrain ou ground truth issue de test_data$Species) aux attributions prédictives produites par le modèle (predictions_test$class). Sous R, sa génération basique s’obtient par la commande table(Observe = test_data$Species, Predit = predictions_test$class).
L’analyse d’une telle matrice met en relief :
- Les éléments situés sur la diagonale principale, qui correspondent aux classements exacts (les vrais positifs pour chaque modalité respective).
- Les éléments extradiagonaux, qui matérialisent les erreurs de classification et documentent la nature directionnelle des confusions (par exemple, un spécimen biologique de variété versicolor classé erronément comme virginica).
Le taux d’exactitude global (Accuracy) se déduit directement par le ratio de la trace de cette matrice sur l’effectif total du jeu de test. À l’inverse, le taux d’erreur empirique représente le complément à l’unité de cette exactitude. Pour une analyse industrielle approfondie, la fonction confusionMatrix() de la bibliothèque caret s’impose en fournissant instantanément un rapport exhaustif intégrant l’intervalle de confiance à 95 % de l’exactitude calculé par la méthode exacte de Clopper-Pearson.
9.2 Indicateurs d’efficacité : Sensibilité, Spécificité et Kappa de Cohen
Dans les contextes multivariés à classes multiples, l’exactitude globale brute peut s’avérer trompeuse, particulièrement en présence de déséquilibres d’effectifs notables. Il est dès lors indispensable de décomposer l’efficacité du système au moyen de métriques stratifiées calculées pour chaque modalité selon la logique « classe contre toutes les autres » (One-vs-All) :
- La sensibilité (ou rappel / Recall) : probabilité que le classifieur identifie correctement la classe $C_k$ sachant que l’individu lui appartient effectivement.
- La spécificité : capacité du modèle à rejeter judicieusement l’appartenance à la classe $C_k$ pour les individus appartenant aux autres modalités.
- La valeur prédictive positive (ou précision) : probabilité conditionnelle qu’un individu classé dans la modalité $C_k$ lui appartienne véritablement en réalité.
Pour synthétiser la performance au-delà de l’effet d’aubaine statistique généré par la prévalence de base, le coefficient Kappa de Cohen ($kappa$) joue un rôle d’arbitre statistique essentiel. Il standardise le degré d’accord inter-juges (entre la vérité observée et l’algorithme) en soustrayant la probabilité d’accord purement attribuable au hasard :
$$\kappa = \frac{P_o – P_e}{1 – P_e}$$
où $P_o$ représente l’exactitude observée et $P_e$ l’exactitude théorique attendue sous hypothèse d’indépendance statistique. Un coefficient $kappa$ excédant 0.85 caractérise un accord quasi-parfait, attestant de la viabilité prédictive des fonctions discriminantes retenues.
9.3 Validation croisée à K blocs et méthode Leave-One-Out (LOOCV)
Bien que la division simple en un jeu d’entraînement et un jeu de test offre une première évaluation non biaisée, cette estimation demeure sujette à la variabilité inhérente au découpage stochastique initial. Pour garantir une inférence hautement généralisable, le recours à la validation croisée s’avère indispensable.
La bibliothèque MASS intègre une implémentation directe et native de la méthode de validation croisée unitaire (Leave-One-Out Cross-Validation ou LOOCV) via la syntaxe lda(Species ~ ., data = iris, CV = TRUE). Dans ce mode de fonctionnement, l’algorithme réitère $n$ ajustements successifs : à chaque itération, une observation unique est exclue, les fonctions discriminantes sont estimées sur les $n-1$ individus résiduels, puis appliquées pour prédire l’individu mis à l’écart. Cette procédure supprime toute dépendance à un découpage arbitraire et fournit un estimateur quasi-sans biais du risque de généralisation futur.
Parallèlement, la validation croisée à K blocs répétés (Repeated k-Fold Cross-Validation), par exemple avec 10 blocs et 5 répétitions orchestrée au travers de la fonction trainControl() du package caret, permet d’établir des distributions empiriques d’exactitude et d’en quantifier précisément l’écart-type d’échantillonnage. La confrontation de ces taux d’erreur croisés atteste de la formidable résilience de la LDA face au surajustement lorsque le ratio $n/p$ demeure confortablement élevé.
10. Étape 8 : Visualisation graphique avancée des résultats
10.1 Projection des individus dans le plan factoriel discriminant
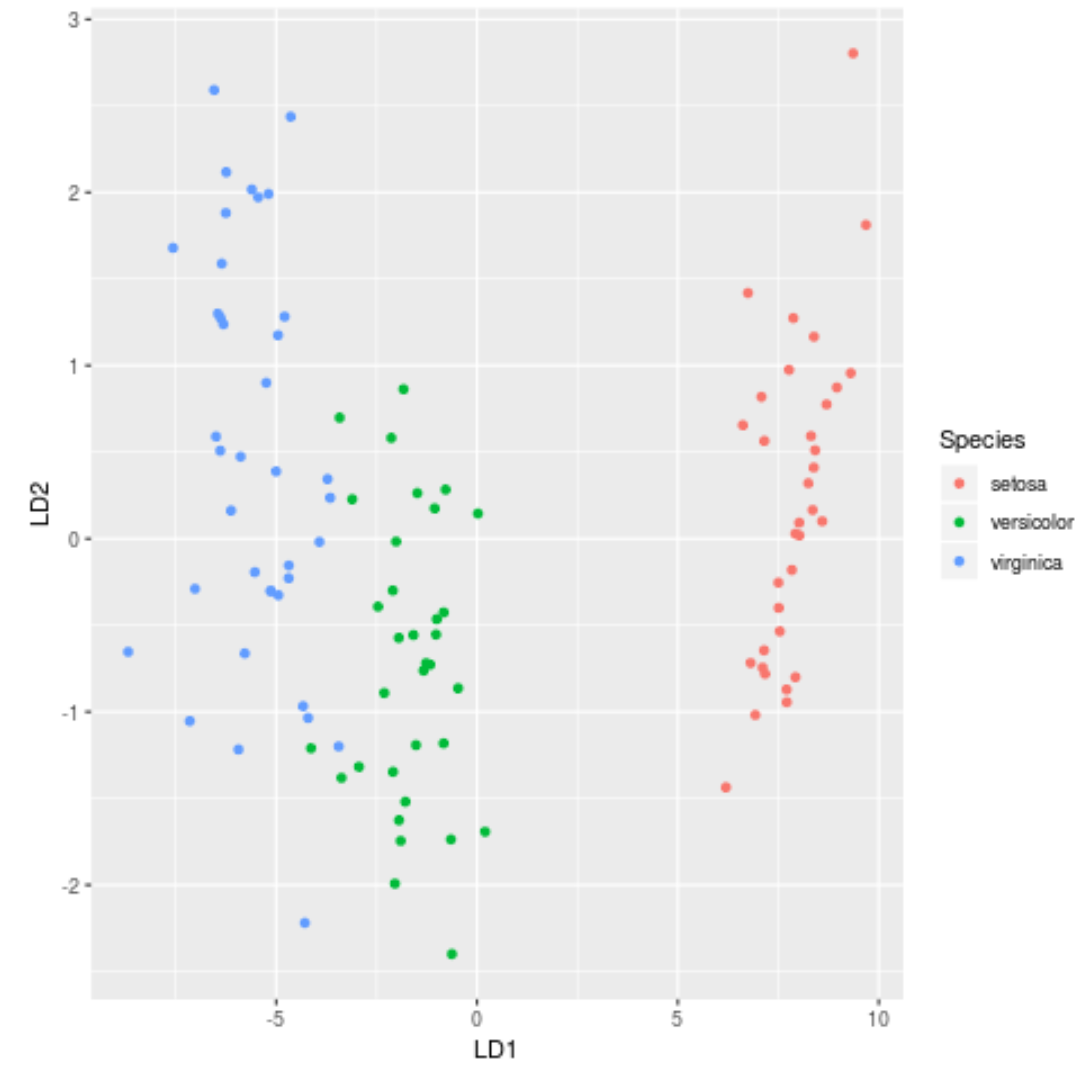
L’expression graphique de l’analyse discriminante linéaire atteint son paroxysme d’intelligibilité avec la projection des individus au sein du premier plan factoriel constitué par les axes canoniques LD1 et LD2. Cette cartographie bi-dimensionnelle condense l’intégralité du pouvoir séparateur du modèle tout en matérialisant l’inertie respective de chaque nuage de points.
Pour édifier cette figure avec le package ggplot2, le statisticien concatène préalablement les scores factoriels issus de modele_lda avec les étiquettes réelles et prédites de l’échantillon. La syntaxe graphique superpose plusieurs strates géométriques indispensables :
- Des nuages de points différenciés (
geom_point()) dont la couleur sémantique encode la classe taxonomique réelle et la morphologie du symbole (rond, triangle, carré) désigne le verdict d’assignation prédit, permettant d’identifier immédiatement les observations mal classées au premier coup d’œil. - Le calcul et l’affichage des centroïdes factoriels de chaque groupe (
stat_summary()ou ajout manuel des moyennes de coordonnées), concrétisant les pôles d’attraction de chaque population. - Le tracé d’ellipses de confiance multivariées à 95 % (via
stat_ellipse(type = "norm")), qui illustrent visuellement le respect de l’homoscédasticité lorsque leurs contours géométriques présentent des orientations et des volumes comparables.
Ce graphique factoriel permet de vérifier visuellement l’isolement complet du nuage d’Iris setosa dans la zone gauche de l’axe horizontal LD1, tandis que la légère contiguïté entre les ellipses de versicolor et virginica reflète exactement les marges de décision captées par la matrice de confusion.
10.2 Tracé des frontières de décision dans l’espace des variables
Une représentation visuelle complémentaire consiste à expliciter les frontières de décision effectives directement au sein du repère cartésien formé par deux prédicteurs d’origine (par exemple Petal.Length face à Petal.Width). Cette technique implique la modélisation préalable d’une sous-LDA restreinte à ces deux covariables d’intérêt.
La méthodologie algorithmique sous R se déploie comme suit :
- Génération d’une grille matricielle dense recouvrant de manière exhaustive l’intervalle bi-dimensionnel des variables d’intérêt par la fonction
expand.grid(), avec un pas d’échantillonnage régulier de 0.02 cm. - Interrogation de la sous-LDA ajustée pour prédire la classe d’appartenance sur chaque nœud artificiel de ce maillage spatial dense à l’aide de
predict(). - Superposition surfacique au moyen de
geom_raster()ougeom_tile()de zones d’assignation colorées de façon translucide en arrière-plan, surmontées des points empiriques réels du jeu de données.
Cette visualisation met en évidence de manière graphique la linéarité absolue des frontières de partitionnement produites par la LDA. Contrairement aux contours d’assignation sinueux caractéristiques des méthodes à noyaux ou des arbres de décision, les séparatrices de Fisher apparaissent sous la forme d’hyperplans strictement rectilignes, illustrant visuellement l’assomption mathématique d’une matrice de variance-covariance rigoureusement commune à toutes les classes.
10.3 Graphiques de densité et histogrammes des scores canoniques
Dans les configurations où le premier axe discriminant concentre la quasi-totalité du pouvoir explicatif — comme c’est le cas ici où LD1 explique plus de 99 % de la variance inter-classes —, l’inspection univariée de la distribution de cette variable composite apporte une lisibilité analytique immédiate. Le package MASS met à disposition une méthode graphique native particulièrement directe : l’invocation de plot(modele_lda) génère instantanément une série d’histogrammes et d’estimations de densité par noyau pour chaque modalité le long des coordonnées canoniques de LD1.
Sous ggplot2, ce tracé gagne en élégance grâce à l’usage de geom_density(alpha = 0.4) en projetant les trois courbes de densité de probabilité conditionnelle sur un axe horizontal unique. Ce graphique matérialise avec éloquence le concept d’écartement de Fisher : la distribution associée à setosa ne présente aucun chevauchement avec les deux autres, tandis que les densités de versicolor et de virginica n’affichent qu’un très discret entrelacement au niveau de leurs queues de distribution respectives.
L’observation attentive de la forme de ces densités empiriques constitue également un contrôle diagnostique a posteriori : des courbes approximativement en cloche et symétriques réconfortent le chercheur quant à la validité de l’hypothèse de normalité des scores discriminants dans l’espace projeté.
11. Comparaison méthodologique : LDA face aux techniques alternatives
11.1 Analyse discriminante linéaire versus Analyse discriminante quadratique (QDA)
L’alternative paramétrique la plus immédiate à la LDA est l’analyse discriminante quadratique (QDA), accessible sous R au travers de la fonction qda() du package MASS. La divergence fondamentale entre ces deux méthodes réside dans la relaxation de l’hypothèse d’homoscédasticité : la QDA renonce à imposer une matrice de dispersion commune $boldsymbol{\Sigma}$ et autorise chaque modalité $k$ à posséder sa propre matrice de covariance $boldsymbol{\Sigma}_k$.
Sur le plan décisionnel, cette flexibilité introduit des termes quadratiques dans l’expression des frontières bayésiennes, lesquelles prennent la géométrie de coniques (paraboles, ellipses, hyperboles). Toutefois, cette liberté structurelle s’accompagne d’un coût statistique non négligeable en vertu du dilemme classique biais-variance. Alors que la LDA requiert l’estimation de $p(p + 1)/2$ paramètres de covariance pour la matrice commune, la QDA impose l’estimation de $K \times [p(p + 1)/2]$ paramètres. Dès que le nombre de prédicteurs $p$ augmente ou que certaines classes disposent d’un effectif $n_k$ modeste, la QDA souffre d’une instabilité d’échantillonnage majeure et d’un risque élevé de surapprentissage.
L’arbitrage formel entre LDA et QDA s’opère sur la base des diagnostics préalables :
- Si le test M de Box confirme l’égalité des matrices de dispersion et que le volume de données est restreint, la LDA s’impose catégoriquement par son principe de parcimonie et sa variance minimale.
- Si l’hétérogénéité des covariances est substantielle et que chaque classe dispose d’un effectif largement suffisant ($n_k gg p^2$), la QDA réduira significativement le biais d’estimation et produira une séparation de bien meilleure qualité.
11.2 Analyse discriminante versus Régression logistique multinomiale
La comparaison entre l’analyse discriminante linéaire et la régression logistique multinomiale (implémentée par exemple via la fonction multinom() du package nnet) illustre la distinction théorique fondamentale entre les approches génératives et les approches discriminatives en apprentissage statistique :
- La LDA est un modèle génératif : elle modélise conjointement la distribution conjointe $P(\mathbf{X}, Y) = P(Y)P(\mathbf{X} mid Y)$ en apprenant la façon dont les prédicteurs sont générés au sein de chaque classe sous l’hypothèse gaussienne, avant d’appliquer la règle d’inversion bayésienne pour dériver les probabilités a posteriori.
- La régression logistique est un modèle discriminatif : elle s’abstient de toute hypothèse distributionnelle sur les covariables explicatives $\mathbf{X}$ et modélise directement la probabilité conditionnelle $P(Y mid \mathbf{X})$ au moyen de transformations logit linéaires estimées par le maximum de vraisemblance conditionnelle.
Sur le plan de l’efficacité asymptotique, la théorie statistique (notamment les démonstrations de Bradley Efron) établit que lorsque l’hypothèse de normalité multivariée est strictement respectée, la LDA est asymptotiquement plus efficiente que la régression logistique ; elle requiert environ 30 % d’observations en moins pour atteindre le même niveau de précision paramétrique. À l’inverse, dès que les variables indépendantes comportent des prédicteurs qualitatifs binaires (variables indicatrices), des distributions asymétriques ou des queues épaisses de type loi de Student, la régression logistique se révèle infiniment plus robuste et impartiale, ne souffrant pas de la dégradation de performance qu’infligent les violations distributionnelles à la méthode de Fisher.
11.3 LDA versus Approches d’apprentissage automatique (SVM et Forêts Aléatoires)
Face à l’avènement des méthodes algorithmiques issues du machine learning — au premier rang desquelles figurent les machines à vecteurs de support (SVM) et les forêts aléatoires (Random Forests) —, la LDA occupe une position d’arbitre et de point de comparaison fondamental (baseline model). Les classifieurs SVM à noyau linéaire partagent avec la LDA la recherche d’un hyperplan séparateur, mais optimisent un critère géométrique différent : alors que la LDA capitalise sur l’intégralité des données via les moments moyens et globaux pour maximiser l’inertie de Rayleigh, les SVM ne considèrent qu’un sous-ensemble critique d’individus situés aux frontières de classes (les vecteurs de support) pour maximiser la marge géométrique dure ou souple.
Lorsque la structure de partitionnement sous-jacente est hautement non linéaire — par exemple des motifs en spirales imbriquées ou des interactions factorielles complexes d’ordre supérieur —, la LDA échoue structurellement par essence géométrique, tandis que les forêts aléatoires ou les SVM à noyau gaussien (RBF) capturent ces topologies contournées sans effort de paramétrage explicite.
Cependant, cette adaptabilité prédictive se paie au prix d’une opacité quasi-totale des décisions internes (nature de boîte noire), d’un coût computationnel substantiel et d’un risque permanent de surajustement nécessitant une régularisation minutieuse des hyperparamètres. Dans un cadre de recherche académique exigeant une interprétation causale, une validation de construit psychométrique ou une justification devant des instances réglementaires (comme en finance ou en pharmacologie), la LDA demeure souvent préférée pour sa transparence mathématique, sa stabilité face aux petites perturbations de l’échantillon et sa sobriété computationnelle absolue.
12. Bonnes pratiques, pièges fréquents et applications pratiques
12.1 Erreurs méthodologiques courantes et comment les contourner
La pratique empirique de l’analyse discriminante est jalonnée de pièges méthodologiques insidieux susceptibles de corrompre l’intégrité scientifique des conclusions. Le premier écueil réside dans la sélection préalable supervisée de prédicteurs effectuée sur la totalité du jeu de données avant toute partition de validation. Lorsqu’un analyste teste un millier de variables par des tests t de Student sur l’ensemble de l’échantillon, en sélectionne les vingt plus significatives pour ensuite entraîner et tester une LDA par validation croisée, les taux d’erreur estimés sont massivement biaisés à la baisse par contamination d’information. Toute sélection ou transformation de caractéristiques doit impérativement être encapsulée au sein de la boucle d’apprentissage d’entraînement.
Un deuxième piège courant réside dans la mauvaise interprétation de la magnitude des coefficients discriminants bruts. Attribuer une importance prépondérante à une variable sous prétexte que son coefficient numérique au sein du vecteur $\mathbf{w}$ est élevé constitue une erreur d’analyse flagrante si les variables ne partagent pas rigoureusement la même unité de mesure. Seuls les coefficients canoniques standardisés (ou les corrélations structurelles canoniques entre les variables d’origine et les scores discriminants) autorisent une inférence hiérarchique valide sur le rôle séparateur spécifique de chaque prédicteur.
Enfin, le déséquilibre sévère de la distribution des classes représente une pathologie silencieuse majeure. Dans un contexte où une modalité ne concentre que 2 % de la cohorte, une fonction discriminante calée sur des probabilités a priori empiriques pourra afficher une exactitude trompeuse de 98 % en assignant la totalité des individus à la modalité majoritaire. L’analyste doit impérativement corriger ce biais soit par l’ajustement rationnel de l’argument prior, soit en recourant à des techniques d’équilibrage d’échantillonnage de type SMOTE (Synthetic Minority Over-sampling Technique), tout en focalisant l’évaluation sur l’indice Kappa et les courbes ROC-AUC plutôt que sur l’exactitude brute.
12.2 Régularisation pour les données de grande dimension (LDA pénalisée)
L’analyse discriminante linéaire classique s’effondre irrémédiablement face au « fléau de la dimensionnalité » (curse of dimensionality), c’est-à-dire dès lors que le nombre de variables prédictrices $p$ approche ou excède le volume de l’échantillon $n$ ($p ge n$). Dans cette configuration — systématiquement rencontrée en génomique, en protéomique ou dans l’analyse de signaux neuro-immatriciels (IRMf, EEG) —, la matrice de dispersion intra-classe $\mathbf{S}_W$ devient singulière, non inversible, et ses valeurs propres s’annulent, rendant l’algorithme de Fisher inopérant sous sa forme standard.
Pour surmonter cette impasse algébrique, la théorie statistique moderne a développé des techniques de régularisation et de rétrécissement matriciel (shrinkage). L’analyse discriminante régularisée (RDA), introduite originellement par Jerome Friedman et accessible sous R via le package klaR, consiste à modifier artificiellement la matrice de covariance en lui injectant une pénalisation de crête (ridge) :
$$\mathbf{S}_{W,\text{reg}} = (1 – \lambda)\mathbf{S}_W + \lambda \sigma^2 \mathbf{I}_p$$
où $lambda in [0, 1]$ est un paramètre de régularisation contrôlant le compromis entre la covariance empirique et une matrice identité sphérique $\mathbf{I}_p$, garantissant une inversibilité stricte et stable.
Parallèlement, des approches de LDA pénalisée par une norme $ell_1$ de type Lasso (implémentées dans des packages spécialisés tels que penalizedLDA ou sparseLDA) permettent d’annuler purement et simplement certains coefficients discriminants lors de la décomposition de Fisher. Cette sélection parcimonieuse (sparse) permet d’isoler un sous-ensemble restreint de biomarqueurs ou de gènes hautement explicatifs tout en projetant les données dans un sous-espace discriminant régularisé de très haute stabilité.
12.3 Applications empiriques en psychométrie et sciences comportementales
Dans le domaine de la psychométrie et des sciences comportementales, l’analyse discriminante linéaire constitue un puissant instrument de validation empirique des construits théoriques et d’aide au diagnostic différentiel. Un paradigme de recherche classique consiste à administrer un questionnaire standardisé d’évaluation de la personnalité ou de la symptomatologie clinique — comme les inventaires du MMPI ou du NEO-PI — à plusieurs cohortes diagnostiques préalablement identifiées par un collège d’experts (par exemple, des individus présentant un trouble dépressif majeur, un trouble bipolaire en phase euthymique, ou des témoins sains).
L’application de la LDA permet alors de vérifier dans quelle mesure les dimensions psychométriques sous-jacentes parviennent véritablement à différencier ces typologies pathologiques. La première fonction discriminante LD1 reflète généralement un gradient global de détresse psychologique ou de sévérité névrotique, tandis que le second axe canonique LD2 sépare spécifiquement les mécanismes d’intériorisation face aux conduites d’extériorisation et d’impulsivité. Cette modélisation autorise les psychométristes à estimer le pouvoir de discrimination marginal de chaque sous-échelle clinique et à réduire la longueur des tests psychologiques en élaguant les items n’apportant aucune variance discriminante significative.
Pour soumettre de tels travaux aux exigences éditoriales des revues académiques internationales (conformément aux directives méthodologiques de l’American Psychological Association), le chercheur doit structurer la restitution de sa LDA selon un protocole strict :
- Mention explicite de la vérification préalable des hypothèses d’homogénéité matricielle (valeur du M de Box) et de normalité multivariée.
- Documentation transparente des tailles d’échantillons intra-groupes et justification de la fixation des probabilités a priori.
- Restitution tabulaire complète des corrélations structurelles canoniques, des valeurs propres, des proportions de trace et des coefficients standardisés.
- Présentation des résultats de la matrice de confusion adossée à une validation croisée rigoureuse démontrant la reproductibilité hors-échantillon du classifieur.
En observant scrupuleusement l’ensemble de ces préceptes algorithmiques, méthodologiques et statistiques au sein de l’environnement de calcul R, l’analyste déploie l’analyse discriminante linéaire dans toute son authenticité mathématique, conciliant de façon harmonieuse la puissance prédictive du modèle et une élégante clarté explicative des phénomènes multivariés complexes.
Références
- Box, G. E. P. (1949). A general distribution theory for a class of likelihood criteria. Biometrika, 36(3/4), 317-346. https://doi.org/10.2307/2332671
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37-46. https://doi.org/10.1177/001316446002000104
- Efron, B. (1975). The efficiency of logistic regression compared to normal discriminant analysis. Journal of the American Statistical Association, 70(352), 892-898. https://doi.org/10.1080/01621459.1975.10480319
- Fisher, R. A. (1936). The use of multiple measurements in taxonomic problems. Annals of Eugenics, 7(2), 179-188. https://doi.org/10.1111/j.1469-1809.1936.tb02137.x
- Friedman, J. H. (1989). Regularized discriminant analysis. Journal of the American Statistical Association, 84(405), 165-175. https://doi.org/10.1080/01621459.1989.10478752
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Henze, N., & Zirkler, B. (1990). A class of invariant consistent tests for multivariate normality. Communications in Statistics – Theory and Methods, 19(10), 3595-3617. https://doi.org/10.1080/03610929008830400
- Kuhn, M. (2008). Building predictive models in R using the caret package. Journal of Statistical Software, 28(5), 1-26. https://doi.org/10.18637/jss.v028.i05
- Mardia, K. V. (1970). Measures of multivariate skewness and kurtosis with applications. Biometrika, 57(3), 519-530. https://doi.org/10.2307/2334770
- Venables, W. N., & Ripley, B. D. (2002). Modern Applied Statistics with S (4th ed.). Springer. https://doi.org/10.1007/978-0-387-21706-2
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4