
L’analyse quantitative moderne et la modélisation computationnelle reposent fondamentalement sur la capacité à extraire des lois fonctionnelles intelligibles à partir de signaux empiriques bruités. L’ajustement de courbe, communément désigné sous le vocable anglo-saxon de curve fitting, constitue l’un des piliers méthodologiques transversaux aux sciences physiques, à la bio-informatique, aux sciences cognitives et à l’ingénierie des données. En établissant une passerelle mathématique entre des observations discrètes et des formulations analytiques continues, cette discipline permet non seulement de synthétiser l’information observée, mais également de tester des hypothèses mécanistiques rigoureuses quant aux processus générateurs sous-jacents.
Dans le paradigme contemporain du calcul scientifique, le langage Python s’est imposé comme l’environnement de référence pour l’implémentation de ces techniques. Grâce à un écosystème hautement optimisé s’appuyant sur des bibliothèques de bas niveau interfacées en C et Fortran, telles que NumPy et SciPy, le chercheur ou le praticien dispose d’outils algorithmiques d’une puissance sans précédent. Qu’il s’agisse de résoudre des systèmes linéaires surdéterminés ou d’optimiser des surfaces de coût non convexes via des méthodes d’atténuation des moindres carrés, la maîtrise de ces bibliothèques requiert une compréhension intime des fondements théoriques, des contraintes d’optimisation numérique et des limites statistiques inhérentes à l’inférence paramétrique.
Ce traité exhaustif se propose d’explorer méthodiquement l’art et la science de l’ajustement de courbes en Python. Depuis la formalisation variationnelle des moindres carrés ordinaires jusqu’aux procédures robustes d’estimation en présence de valeurs aberrantes, en passant par l’analyse différentielle des résidus, la sélection de modèles par la théorie de l’information et le déploiement de fonctions non linéaires archétypales, chaque concept sera disséqué avec une rigueur mathématique et algorithmique absolue. L’objectif est de fournir un cadre opératoire complet permettant de transformer des séries de données brutes en modèles prédictifs fiables, parcimonieux et réfutables au sens épistémologique.
1. Fondements théoriques de l’ajustement de courbe (Curve Fitting)
1.1 Définition mathématique et objectifs de l’ajustement
L’ajustement de courbe peut être formellement défini comme la recherche d’une fonction mathématique continue, notée f(x; θ), appartenant à une famille paramétrique ou non paramétrique prédéterminée, qui approxime de manière optimale un ensemble discret d’observations expérimentales. Soit un ensemble de N paires de données bidimensionnelles notées {(xi, yi)} pour i = 1, …, N, où xi représente la variable indépendante ou explicative, et yi désigne la variable dépendante ou réponse observée. L’objectif mathématique central réside dans la détermination d’un vecteur de paramètres θ = [θ1, θ2, …, θp]T au sein d’un espace fonctionnel de dimension p (avec généralement p << N), de telle sorte que la divergence globale entre les valeurs observées yi et les évaluations théoriques f(xi; θ) soit rigoureusement minimisée selon une métrique scalaire d’erreur.
Il convient d’établir une distinction épistémologique fondamentale entre l’interpolation numérique et l’ajustement de courbe ou régression statistique. L’interpolation contraint la fonction résultante à passer exactement par chaque nœud d’observation, postulant implicitement que les mesures sont exemptes de bruit stochastique. En revanche, l’ajustement de courbe intègre explicitement la présence d’une composante aléatoire irréductible, modélisée sous la forme yi = f(xi; θ) + εi, où εi capture l’erreur de mesure, les perturbations environnementales ou la variabilité intrinsèque du système physique. L’ambition n’est donc pas de reproduire les fluctuations idiosyncrasiques de l’échantillon, mais d’extraire la tendance structurelle sous-jacente.
Dans les sciences comportementales et neurocognitives, cette approche s’avère indispensable pour modéliser des dynamiques complexes telles que les trajectoires d’apprentissage ou les latences cognitives. Par exemple, la célèbre loi du temps de réaction de Hick-Hyman ou la modélisation de l’acquisition de compétences motrices postulent des relations fonctionnelles logarithmiques ou exponentielles spécifiques. L’ajustement permet de tester si les paramètres estimés, tels que les constantes de temps de traitement ou les seuils d’excitabilité neuronale, diffèrent significativement selon les conditions expérimentales, fournissant ainsi une validation quantitative robuste aux théories psychologiques sous-jacentes.
1.2 La méthode des moindres carrés ordinaires
La méthode des moindres carrés ordinaires (MCO), introduite indépendamment par Adrien-Marie Legendre et Carl Friedrich Gauss à l’aube du dix-neuvième siècle, constitue la pierre angulaire de l’estimation paramétrique. Le principe directeur repose sur la minimisation de la somme des carrés des erreurs résiduelles (SSE, pour Sum of Squared Errors), définie formellement par la fonction de coût scalaire S(θ) = ∑i=1N [yi – f(xi; θ)]2. Le choix de la norme euclidienne au carré confère à cette métrique des propriétés de différentiabilité analytique particulièrement avantageuses, facilitant grandement la recherche des extrema globaux par l’annulation du gradient vectoriel de la fonction de perte.
Dans le cas spécifique d’un modèle linéaire dans ses paramètres, où la fonction s’exprime comme une combinaison linéaire de fonctions de base φj(x), le problème d’optimisation admet une solution fermée élégante. En adoptant un formalisme matriciel où Y ∈ ℜN×1 représente le vecteur des observations, X ∈ ℜN×p la matrice de conception (matrice de Vandermonde pour les polynômes), et θ ∈ ℜp×1 le vecteur des coefficients, la fonctionnelle s’écrit ||Y – Xθ||22. La dérivation par rapport à θ conduit directement aux célèbres équations normales de Gauss : XTXθ = XTY. Si la matrice de Gram XTX est non singulière, c’est-à-dire de rang plein p, l’estimateur unique s’obtient par l’inversion matricielle θ* = (XTX)-1XTY.
L’optimalité statistique de cet estimateur repose sur le théorème fondamental de Gauss-Markov, complété par les postulats classiques de normalité. Ces hypothèses exigent l’indépendance statistique des erreurs, une espérance conditionnelle nulle (E[εi] = 0), et surtout l’homoscédasticité, signifiant que la variance résiduelle Var(εi) = σ2 demeure rigoureusement constante sur l’ensemble du domaine d’échantillonnage. Lorsque ces conditions sont scrupuleusement vérifiées, l’estimateur des moindres carrés est le meilleur estimateur linéaire non biaisé (BLUE). Toutefois, la métrique quadratique présente une vulnérabilité critique : en raison de l’élévation au carré, les déviations résiduelles extrêmes exercent une force de rappel disproportionnée sur l’estimation, rendant la méthode singulièrement fragile face aux observations aberrantes.
1.3 Typologie des relations fonctionnelles : linéaire versus non linéaire
L’analyse fonctionnelle distingue catégoriquement les modèles linéaires des modèles non linéaires. Il est impératif de souligner qu’en théorie de l’optimisation statistique, la « linéarité » ne fait pas référence à la géométrie de la droite dans le plan cartésien, mais à la linéarité du modèle par rapport à ses paramètres libres θ. Ainsi, un polynôme de degré élevé tel que f(x) = θ0 + θ1x + θ2x2 + … + θmxm constitue formellement un modèle linéaire, car la dérivée partielle première ∂f / ∂θj = xj est entièrement indépendante du vecteur des coefficients θ. Cette propriété garantit la stricte convexité de la surface d’erreur quadratique, assurant l’existence d’un minimum global unique calculable sans recours à des procédures itératives risquées.
À l’inverse, un modèle est intrinsèquement non linéaire dès lors qu’au moins une dérivée partielle ∂f / ∂θj dépend explicitement d’un ou plusieurs paramètres de θ. Des formulations courantes telles que la fonction exponentielle f(x) = α eβ x, le modèle logistique de Hill ou les fonctions trigonométriques à phase variable entrent dans cette classe complexe. La conséquence computationnelle directe est la perte de convexité de la fonctionnelle de coût : la surface d’erreur se transforme en une topologie complexe parsemée de multiples minima locaux, de cols et de vallées étroites. L’identification du minimum global requiert alors le déploiement d’algorithmes d’optimisation itératifs non linéaires, fortement dépendants du point d’initialisation numérique.
Historiquement, les praticiens contournaient cette complexité algorithmique par des transformations anamorphotiques préalables, notamment la linéarisation logarithmique. Par exemple, appliquer le logarithme népérien aux deux membres d’une relation de puissance y = a xb transforme le problème en une relation affine ln(y) = ln(a) + b ln(x). Cependant, cette commodité mathématique induit un biais statistique souvent ignoré : la transformation altère profondément la structure de l’erreur stochastique. Si le bruit empirique initial était additif et gaussien sur y, il devient multiplicatif et asymétrique après transformation logarithmique, violant les hypothèses fondamentales des moindres carrés et faussant l’inférence des paramètres. Le choix de la classe d’approximation doit donc être guidé par la physique du phénomène plutôt que par des facilités computationnelles obsolètes.
2. Configuration de l’environnement scientifique et bibliothèques Python
2.1 L’écosystème scientifique fondamental : NumPy et SciPy
L’édification d’un pipeline d’ajustement de courbes performant et robuste en Python exige une compréhension fine de l’architecture logicielle sous-jacente. Au cœur de cette infrastructure se trouve NumPy, qui fournit l’objet central ndarray, un tableau multidimensionnel homogène alloué de manière contiguë en mémoire vive. Cette contiguïté permet d’exploiter les instructions vectorielles SIMD (Single Instruction, Multiple Data) des microprocesseurs modernes et d’interfacer directement le code avec des bibliothèques de calcul d’algèbre linéaire de bas niveau, telles que BLAS (Basic Linear Algebra Subprograms) et LAPACK (Linear Algebra Package). La vectorisation élimine les lenteurs inhérentes à la boucle interprétée de Python, autorisant des débits de traitement de plusieurs millions d’opérations en virgule flottante par seconde.
Par-dessus ce socle matriciel, la bibliothèque SciPy déploie un ensemble complet d’algorithmes scientifiques avancés. Le module scipy.optimize concentre l’essentiel des sous-routines dédiées au curve fitting, englobant aussi bien des solveurs de moindres carrés non linéaires contraints que des méthodes d’optimisation globale et locale. L’utilisation conjointe de ces deux bibliothèques permet de manipuler les structures de données avec une précision chirurgicale, évitant les conversions intermédiaires superflues et les instabilités de débordement de mémoire.
Une attention rigoureuse doit être accordée à la gestion des types de données en virgule flottante (floating-point precision). Dans les problèmes d’inversion matricielle mal conditionnés ou lors de la convergence d’algorithmes itératifs, l’emploi exclusif du format double précision standard IEEE 754 (représenté par le type numpy.float64) est impératif pour limiter la dérive des erreurs d’arrondi numérique. De surcroît, la reproductibilité scientifique impose une gestion déterministe de la stochasticité. L’initialisation explicite du générateur de nombres pseudo-aléatoires via la classe moderne numpy.random.default_rng(seed) garantit que les simulations de Monte Carlo, les partitions d’échantillonnage et les générations de données synthétiques demeurent rigoureusement reproductibles d’une exécution à l’autre.
2.2 Structuration et manipulation tabulaire avec Pandas
Bien que le moteur de calcul numérique repose sur les tenseurs NumPy, la phase préparatoire d’ingénierie des données bénéficie grandement des structures de données offertes par la bibliothèque Pandas. L’objet DataFrame s’impose comme le format d’encapsulation privilégié des séries temporelles, des relevés expérimentaux multidimensionnels et des métadonnées de laboratoire. Il apporte une indexation sémantique explicite, protégeant l’analyste contre les erreurs classiques d’alignement vectoriel lors du pré-traitement des variables explicatives et dépendantes.
Le nettoyage préalable des signaux empiriques constitue une étape critique conditionnant la convergence des estimateurs. Les fonctions analytiques d’ajustement de SciPy et NumPy ne tolèrent généralement pas la présence de valeurs non définies (NaN, Not a Number) ou infinies (Inf), provoquant l’interruption brutale des algorithmes par des levées d’exceptions de type LinAlgError. Pandas propose des méthodes sophistiquées pour diagnostiquer l’intégrité tabulaire, filtrer les artefacts instrumentaux, et implémenter des stratégies d’imputation statistique ou d’interpolation locale préalablement à la modélisation formelle.
Enfin, la compatibilité ascendante et descendante entre Pandas et l’écosystème NumPy est quasi transparente. Les mécanismes d’extraction sous-jacents, notamment l’attribut .to_numpy(), permettent de convertir instantanément les colonnes d’un DataFrame en vecteurs numériques contigus, sans duplication coûteuse en mémoire grâce au mécanisme de vue (memory view). Cette flexibilité facilite l’extraction sélective de sous-ensembles expérimentaux (stratified subsets) pour ajuster des modèles locaux distincts, par exemple selon différentes cohortes de sujets ou diverses conditions pharmacologiques.
2.3 Visualisation diagnostique avec Matplotlib et Seaborn
L’inférence statistique et l’évaluation de modèles d’ajustement ne sauraient se concevoir sans un dispositif de visualisation scientifique rigoureux. La bibliothèque Matplotlib, complétée par la couche d’abstraction statistique Seaborn, permet de construire des représentations graphiques répondant aux standards les plus exigeants des revues internationales à comité de lecture. La visualisation diagnostique ne se limite pas à une simple fonction illustrative ; elle constitue un instrument heuristique de premier plan pour déceler des aberrations structurelles que les métriques agrégées masquent fréquemment.
Une représentation académique canonique pour l’ajustement de courbe superpose systématiquement les données discrètes observées, affichées sous forme de nuage de points (scatter plot) avec leurs barres d’erreur expérimentales respectives, et les trajectoires continues déduites des équations mathématiques estimées. Pour garantir la fluidité visuelle des courbes théoriques et éviter l’apparition d’artefacts polygonaux brisés, l’évaluation du modèle doit impérativement s’effectuer sur un maillage dense et régulier de points générés sur l’intervalle d’intérêt, typiquement via l’instruction numpy.linspace.
La configuration esthétique et technique des graphiques requiert le paramétrage explicite des dimensions de la figure, de la typographie, des légendes exhaustives incluant les paramètres estimés avec leurs incertitudes respectives, ainsi que le contrôle rigoureux des échelles linéaires ou logarithmiques sur les axes. En vue d’une diffusion dans des supports imprimés ou des publications électroniques haute définition, l’exportation des tracés doit privilégier des formats vectoriels indépendants de la résolution tels que PDF ou SVG, ou des formats matriciels comprimés sans perte configurés à un seuil minimal de 300 à 600 DPI (dots per inch).
3. Génération, simulation et exploration visuelle des données
3.1 Construction d’un jeu de données synthétique contrôlé
Avant d’affronter la complexité des séries de données expérimentales réelles, dont les fonctions génératrices demeurent par nature inconnues, il est méthodologiquement impératif de valider les algorithmes d’ajustement sur des jeux de données synthétiques parfaitement contrôlés. Cette démarche d’étalonnage computationnel permet de confronter les estimations paramétriques θ* produites par la machine avec les véritables paramètres théoriques θvrai ayant présidé à la synthèse du signal, établissant ainsi sans ambiguïté la fidélité et le biais éventuel des estimateurs.
Considérons la construction d’un phénomène expérimental typique des réponses comportementales ou neurophysiologiques, caractérisé par une cinétique non monotone présentant une phase ascendante rapide suivie d’une relaxation amortie. Nous pouvons concevoir une fonction génératrice sous-jacente combinant des composantes sinusoïdales et exponentielles sur un intervalle discret borné x ∈ [0, 10], discrétisé en N = 80 observations. L’équation déterministe idéale peut être formalisée par l’expression mathématique : yvrai = 2.5 · sin(0.8 · x) + 0.5 · x – 0.03 · x2.
Pour émuler la variabilité empirique inhérente à tout dispositif de métrologie, nous injectons délibérément une perturbation stochastique sous la forme d’un bruit blanc gaussien additif centré. Chaque point d’observation devient ainsi yi = yvrai(xi) + εi, où εi ~ N(0, σ2) avec un écart-type configuré à σ = 0.4. Cette approche permet de générer un ensemble de données sous forme de DataFrame Pandas comprenant les variables x, y_reel, y_observe, et l’incertitude théorique associée, constituant le substrat empirique sur lequel nos divers algorithmes d’ajustement vont être rigoureusement éprouvés.
3.2 Inspection exploratoire et détection des tendances structurelles
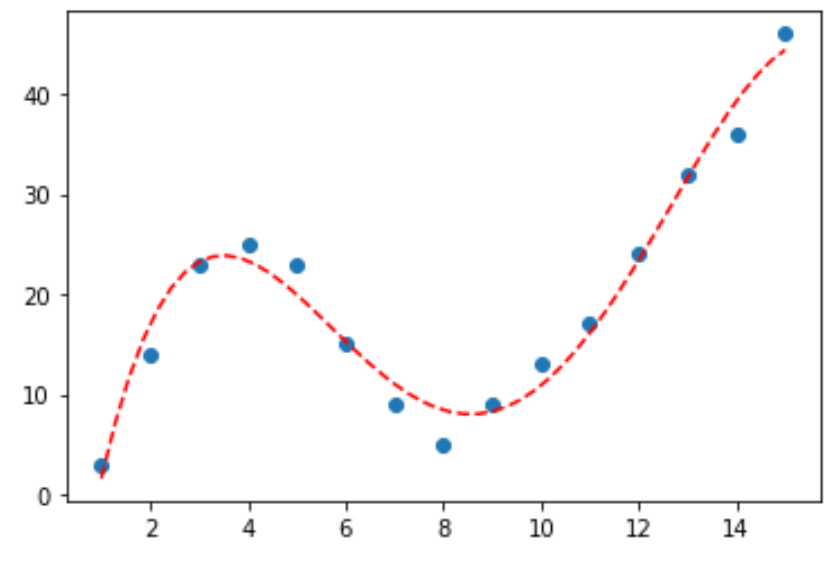
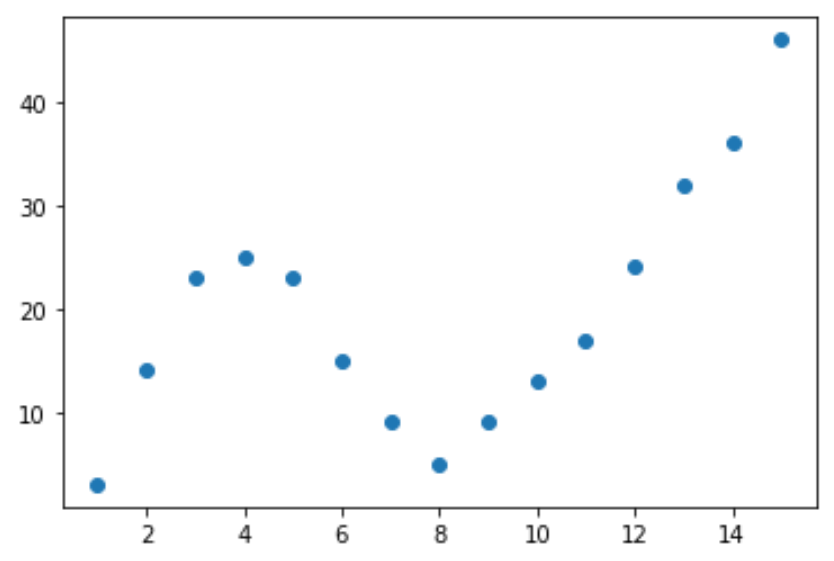
L’exploration visuelle préliminaire du nuage de points constitue une étape cardinale que l’analyste rigoureux ne saurait court-circuiter sous peine de choisir une classe fonctionnelle inadaptée. Dès l’affichage du nuage de points (xi, yi), l’œil expert recherche des signatures géométriques déterminantes : l’existence d’un ou plusieurs points d’inflexion où la concavité s’inverse, la présence d’extrema locaux (maxima ou minima relatifs), ainsi que le comportement asymptotique vers les limites supérieure et inférieure du domaine expérimental.
L’observation attentive des données synthétisées révèle immédiatement une rupture claire avec toute hypothèse de stricte linéarité. Le signal démontre une courbure positive initiale, culmine aux alentours de x ≈ 2, subit une déclinaison relative, puis amorce une remontée conditionnée par la composante linéaire sous-jacente. L’inspection morphologique permet d’emblée d’écarter un modèle de régression linéaire simple, sous peine de commettre une grave erreur de spécification (misspecification bias). L’analyste peut d’ores et déjà formuler l’hypothèse qu’un polynôme de degré minimal égal à 3 (cubique) sera requis pour accommoder les deux changements de courbure observés.
Simultanément, l’analyse exploratoire scrute la répartition spatiale de la dispersion verticale le long de l’axe des abscisses afin d’évaluer qualitativement le respect de l’hypothèse d’homoscédasticité. Une dispersion d’amplitude sensiblement constante suggère la viabilité de moindres carrés non pondérés. Enfin, l’absence apparente de points isolés rejetés à plusieurs écarts-types de la trajectoire dominante permet, à ce stade, de poursuivre l’investigation sans procéder à des élagages arbitraires du signal.
3.3 Standardisation et normalisation préliminaires
Dans de nombreuses configurations pratiques d’optimisation numérique, en particulier lorsque les variables explicatives s’étendent sur des échelles numériques gigantesques ou dissymétriques, l’instabilité numérique menace directement la convergence des algorithmes. La formation de la matrice de Vandermonde pour des polynômes d’ordre élevé implique l’élévation des composantes à des puissances croissantes xm. Si x est de l’ordre de 103, x5 atteint 1015, induisant un mauvais conditionnement dramatique de la matrice des équations normales et des erreurs massives de troncature lors de l’inversion.
La mise à l’échelle des données permet de juguler cette pathologie computationnelle. Deux stratégies prédominent dans la littérature : la normalisation Min-Max, qui remappe linéairement les données dans l’intervalle unitaire [0, 1] selon la relation xnorm = (x – xmin) / (xmax – xmin), et la standardisation statistique ou centrage-réduction (calcul du Z-score), définie par xstd = (x – μx) / σx, conférant à la variable une moyenne nulle et une variance unitaire. Le choix entre ces deux approches dépend de la sensibilité de la famille fonctionnelle retenue : la standardisation est généralement privilégiée pour les techniques de régularisation paramétrique.
Néanmoins, la normalisation impose une contrainte herméneutique majeure : elle modifie substantiellement l’échelle et la signification phénoménologique des coefficients θ extraits. Les paramètres estimés sur des variables normalisées ne correspondent plus directement aux grandeurs physiques mesurées dans le laboratoire (ex. : millisecondes, micromoles par litre). Il est donc formellement indispensable, après l’étape d’optimisation mathématique, de réappliquer une transformation inverse analytique pour restaurer les paramètres dans leurs dimensions physiques originelles avant toute publication ou interprétation fonctionnelle des résultats.
4. Ajustement polynomial avec numpy.polyfit et numpy.poly1d
4.1 Fonctionnement algorithmique de numpy.polyfit
L’ajustement polynomial univarié représente la méthode d’approximation la plus intuitive et historiquement répandue. Dans l’écosystème classique de NumPy, la fonction patrimoniale numpy.polyfit(x, y, deg) constitue le point d’entrée traditionnel pour cette opération. Sa signature algorithmique requiert au minimum le vecteur des coordonnées indépendantes x, le vecteur des réponses empiriques y, et la spécification explicite du degré entier deg du polynôme cible P(x) = p0 xdeg + p1 xdeg-1 + … + pdeg.
Contrairement à une implémentation naïve qui inverserait directement la matrice des équations normales XTX, s’exposant ainsi à une catastrophe de conditionnement, numpy.polyfit s’appuie en coulisse sur les routines LAPACK hautement optimisées (spécifiquement dgelsd). L’algorithme résout le problème des moindres carrés linéaires en effectuant une décomposition en valeurs singulières (SVD) de la matrice de Vandermonde associée. Cette factorisation matricielle garantit une stabilité numérique optimale, même lorsque la matrice s’approche de la singularité en raison de corrélations colinéaires extrêmes entre les puissances successives de la variable indépendante.
La fonction retourne le vecteur des coefficients ordonnés rigoureusement selon les puissances décroissantes de la variable, convention historique de calcul formel. L’analyste doit impérativement garder cette convention à l’esprit pour ne pas intervertir l’ordonnée à l’origine avec le terme de plus haut degré. De surcroît, numpy.polyfit propose des arguments optionnels cruciaux, tels que cov=True, qui ordonne le calcul et le retour de la matrice de covariance asymptotique des paramètres estimés, indispensable à l’évaluation de la significativité statistique de chaque monôme.
4.2 Manipulation des modèles avec numpy.poly1d
Une fois le vecteur de coefficients extrait, la manipulation manuelle de l’expression polynomiale via des boucles itératives s’avère fastidieuse et source d’erreurs d’implémentation. La classe numpy.poly1d intervient alors comme une capsule logicielle élégante encapsulant les coefficients pour transformer le tableau numérique en un objet fonctionnel évaluable comme une fonction Python ordinaire. En instanciant simplement modele = numpy.poly1d(coefficients), l’objet résultant accepte des arguments scalaires ou des tableaux vectorisés NumPy complets.
Cette commodité syntaxique simplifie radicalement la phase d’interpolation visuelle. Pour tracer la trajectoire continue du polynôme sur un graphique sans aspérité, il suffit de lui injecter le maillage dense généré préalablement : y_trace = modele(x_dense). Mais les fonctionnalités de numpy.poly1d transcendent la simple évaluation numérique : la classe surcharge les opérateurs arithmétiques fondamentaux, autorisant l’addition, la soustraction et la multiplication de polynômes entiers sans manipulation bas niveau de tableaux.
En outre, l’objet dispose de capacités de calcul différentiel et intégral exact. L’appel à la méthode modele.deriv() retourne instantanément la dérivée formelle du polynôme, permettant de déterminer analytiquement les positions exactes des extrema locaux et des points d’inflexion par la résolution des racines du polynôme dérivé (via numpy.roots). Réciproquement, la méthode modele.integ() calcule la primitive formelle, ouvrant la voie à des intégrations spatiales ou temporelles exactes du phénomène ajusté sans recours à des schémas d’intégration numérique approximatifs comme la méthode des trapèzes.
4.3 Transition moderne : l’interface numpy.polynomial.Polynomial
Bien que numpy.polyfit et numpy.poly1d demeurent massivement employés dans le code préexistant, la documentation officielle de NumPy recommande sans ambiguïté la transition vers le sous-paquetage moderne numpy.polynomial, et plus particulièrement la classe Polynomial issue de numpy.polynomial.polynomial. Cette refonte architecturale répond à des impératifs mathématiques sévères visant à corriger les faiblesses historiques de l’ancienne API.
La première divergence conceptuelle majeure réside dans l’ordonnancement des coefficients : la nouvelle interface adopte la convention mathématique standard croissante, où le coefficient à l’indice j correspond rigoureusement à la puissance xj. Plus fondamentalement, la classe Polynomial introduit la gestion explicite de domaines géométriques délimités (domain et window). Lors de l’ajustement via la méthode de fabrique Polynomial.fit(x, y, deg), l’algorithme procède automatiquement à un remappage affine interne des données d’abscisses vers l’intervalle canonique [-1, 1]. Cette mise à l’échelle implicite améliore drastiquement le conditionnement spectral de la matrice de Vandermonde, réduisant de plusieurs ordres de grandeur la sensibilité aux erreurs numériques.
Enfin, le paquetage numpy.polynomial unifie l’ajustement polynomial standard avec des familles de polynômes orthogonaux de premier plan, tels que les polynômes de Tchebychev (Chebyshev), de Legendre ou de Hermite. L’ajustement sur une base orthogonale de Tchebychev permet d’atténuer considérablement les oscillations parasites qui gangrènent traditionnellement les approximations polynomiales de degré élevé, offrant une robustesse numérique incomparablement supérieure à celle de l’ancienne fonction polyfit.
5. Comparaison empirique de degrés polynomiaux multiples
5.1 Implémentation d’une batterie de modèles (degrés 1 à 5)
Pour appréhender concrètement le comportement de l’approximation polynomiale face à la complexité d’un signal, il est instructif de déployer une boucle d’ajustement séquentielle calibrant une succession de modèles de degrés croissants, typiquement de deg = 1 (modèle linéaire affine) jusqu’à deg = 5 (polynôme quintique). Cette démarche automatisée s’exécute à l’aide d’une structure de compréhension de dictionnaire ou de liste, stockant chaque instance polynomiale calibrée pour des analyses comparatives ultérieures.
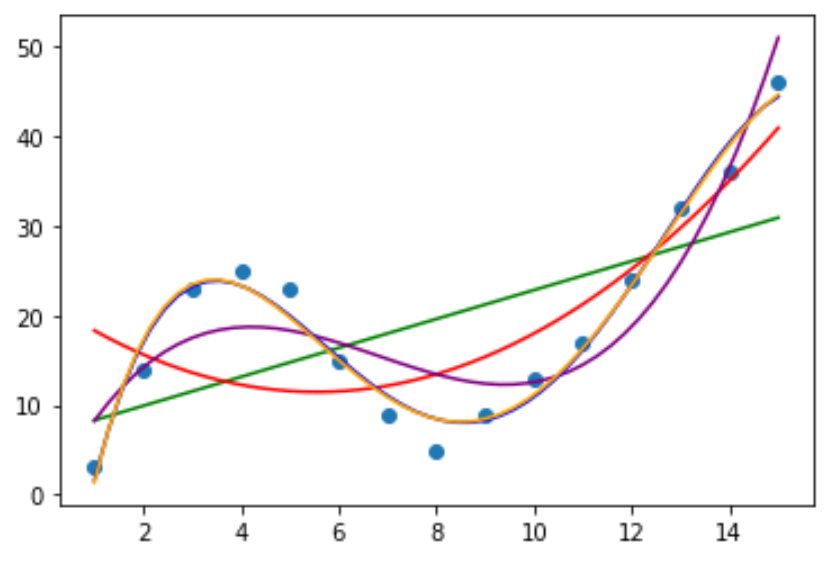
Chaque modèle engendre une interprétation radicalement différente de la topologie du jeu de données. Le degré 1 impose une rigidité structurelle absolue, incapable de rendre compte de la moindre inflexion. Le degré 2 (parabolique) confère une courbure constante mais symétrique, échouant à traduire la dynamique d’amortissement post-sommet. À partir du degré 3 (cubique), la flexibilité s’accroît substantiellement, permettant la coexistence d’un maximum et d’un minimum relatifs. Les degrés 4 et 5 offrent des degrés de liberté supplémentaires susceptibles d’épouser plus intimement les inflexions locales induites par la composante stochastique.
La superposition graphique multivariée de ces cinq trajectoires sur le nuage de points expérimentaux, adossée à un codage couleur univoque et une légende explicative rigoureuse, met immédiatement en exergue la dialectique fondamentale entre la simplicité géométrique et la flexibilité adaptative. Cette mise en perspective visuelle démontre sans ambiguïté que l’augmentation du degré polynomial conduit inévitablement à un rapprochement asymptotique de la courbe vis-à-vis des observations empiriques au sein de la région médiane de l’échantillon.
5.2 Observation qualitative du comportement aux bornes
Si l’élévation du degré polynomial améliore mécaniquement la proximité de la courbe avec les données d’apprentissage centrales, elle déclenche fréquemment une pathologie mathématique redoutable aux marges du domaine expérimental : le célèbre phénomène de Runge. Découvert à la fin du dix-neuvième siècle par le mathématicien Carl Runge dans le cadre de l’interpolation polynomiale sur des nœuds équidistants, ce comportement se caractérise par des oscillations d’amplitude divergente à mesure que l’on s’approche des extrémités de l’intervalle [xmin, xmax].
Dans notre batterie de modèles, l’examen qualitatif des bornes pour les polynômes de degré 4 et surtout de degré 5 met en évidence une courbure excessive et arbitraire vers le haut ou vers le bas, totalement découplée de la trajectoire déterministe réelle du processus générateur. Le modèle s’efforce de minimiser les résidus des quelques observations terminales en modifiant radicalement son orientation globale, au détriment de la cohérence physique du phénomène. Les polynômes de bas degré, bien qu’incapables de restituer fidèlement la finesse des courbures locales, demeurent quant à eux relativement stables et bornés dans leurs variations périphériques.
Ce comportement met en lumière le danger mortel de l’extrapolation polynomiale. Hors du domaine strict de mesure [xmin, xmax], un polynôme d’ordre élevé tend inéluctablement vers +∞ ou -∞ à une vitesse prodigieuse proportionnelle à xdeg. Tout calcul prédictif situé ne serait-ce que marginalement au-delà de la dernière observation conduit à des aberrations quantitatives monumentales, disqualifiant totalement les polynômes comme outils de prédiction prospective en dehors des frontières de l’échantillonnage expérimental.
5.3 Analyse graphique résiduelle différentielle
L’inspection du tracé de la courbe ajustée sur les données s’avère souvent trompeuse pour juger de l’adéquation d’un modèle. L’œil humain est en effet notoirement inefficace pour évaluer la distribution fine des distances orthogonales ou verticales le long d’une trajectoire courbe. Il est par conséquent impératif de construire des diagrammes résiduels différentiels, représentant les résidus bruts ei = yi – f(xi; θ) sur l’axe des ordonnées en fonction de la variable indépendante xi sur l’axe des abscisses.
L’analyse des résidus du modèle linéaire de degré 1 et du modèle quadratique de degré 2 met immédiatement en relief des structures géométriques hautement corrélées : les résidus dessinent des vagues successives et systématiques (formes en U ou en cloche), s’écartant massivement de la ligne d’erreur zéro. Ces motifs déterministes constituent la preuve irréfutable d’un sous-ajustement manifeste (underfitting) : le modèle n’a pas réussi à capturer une fraction substantielle de l’information déterministe contenue dans les données, laquelle est reléguée de manière impropre dans le terme d’erreur.
À l’inverse, à mesure que le degré s’élève vers l’ordre 3, les résidus tendent vers un aspect aléatoire idéal, oscillant symétriquement de part et d’autre de l’axe zéro sous forme de bruit blanc décorrélé. Toutefois, en examinant attentivement le modèle de degré 5, on s’aperçoit que les résidus deviennent anormalement petits en regard du niveau de variance théorique du bruit expérimental σ2. Le modèle ne se contente plus de capter la structure sous-jacente : il commence à modéliser le bruit stochastique individuel de chaque point, signature clinique du surapprentissage.
6. Critères quantitatifs d’évaluation et de sélection de modèle
6.1 Le coefficient de détermination (R²) et ses pièges
Dans l’arsenal des métriques statistiques conventionnelles, le coefficient de détermination, universellement désigné par R2, jouit d’une popularité écrasante. Mathématiquement, il se définit par le rapport complémentaire entre la somme des carrés des résidus (SSres = ∑ [yi – f(xi)]2) et la somme des carrés totaux de la variance empirique (SStot = ∑ [yi – ȳ]2, où ȳ représente la moyenne arithmétique de l’échantillon), soit la formule formelle : R2 = 1 – (SSres / SStot). Il s’interprète classiquement comme la proportion de la variance totale des données expliquée par le modèle d’ajustement.
Cependant, l’utilisation exclusive du R2 comme critère de sélection de modèles est entachée d’une faille théorique majeure : dans le cadre des moindres carrés linéaires, l’adjonction de paramètres libres supplémentaires entraîne mathématiquement une réduction monotone (ou au minimum une stagnation) de la somme des résidus au carré SSres. En conséquence, la valeur de R2 augmente mécaniquement à mesure que le degré du polynôme s’élève, atteignant un score trompeur proche de 1.0 pour un modèle de degré excessif surapprenant grossièrement le bruit de fond.
Pour pallier cette défaillance intrinsèque, la statistique inférentielle a développé le R2 ajusté (adjusted R-squared), qui intègre une pénalisation explicite proportionnelle au nombre de paramètres libres p et à la taille de l’échantillon N, selon l’équation : R2adj = 1 – [(1 – R2)(N – 1) / (N – p – 1)]. De surcroît, il est crucial de rappeler que la validité de l’interprétation géométrique du R2 s’effondre littéralement pour les modèles non linéaires purs : dans ces derniers, la décomposition fondamentale de la variance SStot = SSreg + SSres ne s’applique plus, pouvant aboutir à des valeurs de R2 artificiellement aberrantes, voire négatives.
6.2 Erreur quadratique moyenne (RMSE) et erreur absolue moyenne (MAE)
Pour mesurer la déviance quantitative d’un modèle directement dans les unités dimensionnelles de la variable étudiée, l’erreur quadratique moyenne (Root Mean Squared Error, RMSE) et l’erreur absolue moyenne (Mean Absolute Error, MAE) constituent des métriques de précision incontournables. La RMSE s’exprime par la racine carrée de la moyenne arithmétique des carrés des erreurs résiduelles : RMSE = √[(1 / N) ∑i=1N (yi – f(xi))2]. En raison de sa structure quadratique calquée sur celle des moindres carrés ordinaires, la RMSE pondère plus lourdement les déviations de grande magnitude, ce qui en fait un excellent indicateur de la présence de défaillances prédictives locales sévères.
En contrepoint, la MAE évalue l’espérance arithmétique des déviations absolues simples : MAE = (1 / N) ∑i=1N |yi – f(xi)|. Moins sensible aux points extrêmes isolés que la RMSE, elle reflète fidèlement l’erreur résiduelle médiane dans des contextes expérimentaux pollués par des distributions d’erreurs non gaussiennes à queues épaisses (distributions leptokurtiques). L’écart relatif entre la RMSE et la MAE fournit d’ailleurs une indication diagnostique précieuse : un ratio RMSE / MAE substantiellement supérieur à l’unité signale sans ambiguïté une forte dispersion de l’amplitude des erreurs, trahissant la présence d’écarts ponctuels massifs mal résolus par le modèle.
L’implémentation de ces métriques en Python pur avec NumPy se révèle d’une remarquable simplicité et évite l’importation de dépendances logicielles lourdes. En exploitant la vectorisation native, le calcul s’effectue via numpy.sqrt(numpy.mean((y – y_pred)**2)) pour la RMSE, et numpy.mean(numpy.abs(y – y_pred)) pour la MAE. Bien que ces indicateurs décrivent avec précision l’adéquation au jeu de données présent, ils demeurent, tout comme le R2, intrinsèquement incapables d’arbitrer de manière autonome le compromis entre la fidélité empirique et la parcimonie structurelle.
6.3 Critères d’information : AIC et BIC
L’arbitrage formel entre la qualité d’ajustement empirique et la complexité structurelle d’un modèle relève du champ de la théorie de l’information et de l’épistémologie statistique. C’est précisément à cette jonction qu’interviennent le critère d’information d’Akaike (AIC) et le critère d’information bayésien de Schwarz (BIC). Fondé sur la minimisation de la divergence de Kullback-Leibler entre le modèle estimé et la véritable distribution sous-jacente inconnue génératrice des données, l’AIC pénalise la log-vraisemblance maximale ln(L) par le nombre de paramètres ajustés k : AIC = 2k – 2ln(L).
Sous l’hypothèse canonique où les résidus sont indépendants et identiquement distribués selon une loi normale d’espérance nulle et de variance constante, l’AIC peut être reformulé analytiquement de manière particulièrement élégante à partir de la somme des carrés des résidus SSres : AIC = N · ln(SSres / N) + 2k (auquel s’ajoute un terme de correction pour petits échantillons noté AICc lorsque le ratio N / k < 40). Le critère BIC adopte une perspective bayésienne, maximisant la probabilité a posteriori du modèle, et applique une pénalité logarithmique beaucoup plus sévère vis-à-vis du nombre de degrés de liberté : BIC = k · ln(N) + N · ln(SSres / N).
Dans une démarche comparative menée sur nos modèles de degrés 1 à 5, le modèle optimal correspond rigoureusement à celui qui minimise la valeur absolue de l’AIC ou du BIC. Alors que le R2 continue de croître aveuglément jusqu’au degré 5, l’AIC et le BIC sanctionnent drastiquement les degrés 4 et 5 en raison du terme de pénalité paramétrique qui excède le gain marginal de réduction de la variance résiduelle. Ces critères identifient ainsi avec une remarquable régularité le modèle de degré 3 comme le point d’équilibre parfait garantissant une parcimonie explicative maximale conforme au principe du rasoir d’Ockham.
7. Le compromis biais-variance et la régularisation
7.1 Décomposition mathématique de l’erreur de généralisation
Le dilemme fondamental de l’apprentissage automatique et de la régression statistique s’exprime conceptuellement à travers la décomposition mathématique du compromis biais-variance. L’erreur quadratique moyenne de généralisation hors-échantillon d’un estimateur f̂(x) face à une cible aléatoire y = f(x) + ε (avec E[ε] = 0 et Var(ε) = σ2) se décompose rigoureusement en trois termes additifs distincts : E[(y – f̂(x))2] = [Biais(f̂(x))]2 + Var(f̂(x)) + σ2.
La composante de biais, définie par Biais(f̂(x)) = E[f̂(x)] – f(x), quantifie l’erreur systématique issue d’une formulation mathématique excessivement simpliste ou restrictive du phénomène réel. Un modèle présentant un fort biais est sous-paramétré (underfitted) ; il ignore délibérément des variations structurales manifestes du signal empirique. Inversement, la composante de variance, exprimée par Var(f̂(x)) = E[(f̂(x) – E[f̂(x)])2], mesure l’instabilité prédictive du modèle lorsque l’ajustement est répété sur des échantillons de données distincts issus de la même population source. Un modèle à forte variance est sur-paramétré (overfitted) ; il est hypersensible aux fluctuations d’échantillonnage locales.
Le troisième terme, σ2, représente la variance irréductible inhérente au bruit stochastique du système physique ou cognitif observé. Aucun algorithme, quelle que soit sa sophistication analytique, ne peut comprimer l’erreur globale en deçà de ce plancher fondamental. L’objectif ultime de l’ajustement de courbe consiste dès lors à localiser le point d’équilibre optimal (sweet spot) où la somme du carré du biais et de la variance est minimisée, assurant ainsi au modèle une capacité prédictive maximale face à de nouvelles observations non observées lors de l’étalonnage.
7.2 Techniques de régularisation polynomiale : Ridge et Lasso
Lorsque la structure mathématique impose l’utilisation d’une base de fonctions très riche ou d’un degré polynomial potentiellement élevé pour capter des non-linéarités subtiles, le contrôle de la variance exige l’introduction de techniques de régularisation. La régularisation consiste à contraindre la liberté des paramètres libres en adjoignant à la fonction de coût des moindres carrés ordinaires une pénalité fonctionnelle liée à la magnitude du vecteur des coefficients θ.
La régression Ridge (pénalisation de Tikhonov) ajoute à la perte quadratique la norme L2 des coefficients, minimisant la fonctionnelle : SRidge(θ) = ||Y – Xθ||22 + α ||θ||22, où α ≥ 0 constitue l’hyperparamètre de régularisation. Cette contrainte quadratique force les coefficients à rétrécir (shrinkage) de manière homogène vers zéro sans jamais s’annuler strictement, réduisant drastiquement les oscillations aux bornes sans sacrifier l’ordre du polynôme. La régression Lasso (Least Absolute Shrinkage and Selection Operator) substitue à cela la norme L1 : SLasso(θ) = ||Y – Xθ||22 + α ||θ||1. En vertu de la géométrie rhomboïdale de la boule unité L1, le Lasso induit une parcimonie structurelle (sparsity) en annulant rigoureusement certains coefficients, opérant ainsi une sélection automatique des composantes monômiales dominantes.
L’implémentation pratique de ces techniques s’exécute de manière optimale via la bibliothèque scikit-learn en combinant les transformateurs de prétraitement et les estimateurs au sein d’un Pipeline. En conjuguant PolynomialFeatures(degree=5) avec Ridge(alpha=…) ou Lasso(alpha=…), l’analyste stabilise le comportement asymptotique du polynôme quintique. L’étalonnage de l’hyperparamètre α s’opère par balayage logarithmique via des mécanismes automatisés de type RidgeCV ou GridSearchCV, garantissant une régularisation mathématiquement optimale.
7.3 Validation croisée k-fold pour l’estimation hors-échantillon
L’évaluation rigoureuse de la capacité de généralisation et du niveau d’overfitting d’un ajustement de courbe requiert la mise en œuvre d’un protocole de validation croisée k-fold (k-fold cross-validation). Cette procédure computationnelle consiste à partitionner l’échantillon expérimental global de N données en k sous-ensembles (ou « plis ») mutuellement exclusifs et de tailles identiques, typiquement k = 5 ou k = 10.
À chaque itération d’une boucle comptant k étapes, k-1 plis sont agrégés pour constituer la base d’entraînement servant à l’ajustement du modèle polynomial, tandis que le pli résiduel, rigoureusement exclu de la phase d’optimisation mathématique, fait office de banc d’évaluation test. La métrique résiduelle (par exemple la MSE ou la MAE) est calculée exclusivement sur ce pli indépendant hors-échantillon. Au terme des k itérations, la moyenne arithmétique et la variance empirique des erreurs de test sont agrégées, délivrant une mesure impartiale de l’erreur prédictive globale du modèle face à des données totalement inédites.
L’application de ce protocole sur notre succession de polynômes met en évidence une rupture phénoménologique spectaculaire : alors que l’erreur mesurée sur le sous-ensemble d’apprentissage (in-sample error) décline continuellement du degré 1 au degré 5, l’erreur mesurée en validation croisée hors-échantillon (out-of-sample error) atteint un minimum clair au degré 3, avant de subir une explosion exponentielle sur les degrés 4 et 5. Cette bifurcation non équivoque entre performance d’apprentissage et résilience de test fournit la confirmation expérimentale définitive du surapprentissage et justifie l’abandon des modèles d’ordre quintique.
8. Ajustement non linéaire avancé avec scipy.optimize.curve_fit
8.1 Architecture et principes de curve_fit
Lorsque la loi scientifique postulée ne peut être formulée comme une combinaison linéaire de descripteurs monômiaux, l’ajustement polynomial s’efface au profit de l’ajustement non linéaire généralisé. La fonction reine de l’écosystème Python pour cette tâche est scipy.optimize.curve_fit. Conçue comme une interface fonctionnelle ergonomique au-dessus des solveurs de moindres carrés non linéaires de bas niveau (hérités des bibliothèques MINPACK écrites en Fortran), curve_fit automatise la minimisation de la somme des carrés des écarts non linéaires sans nécessiter la dérivation manuelle laborieuse des matrices jacobiennes.
L’architecture algorithmique par défaut de curve_fit pour des problèmes non contraints repose sur l’algorithme de Levenberg-Marquardt (LM). Cet algorithme sophistiqué orchestre une interpolation continue particulièrement ingénieuse entre deux stratégies d’optimisation canoniques : la méthode de descente de gradient de Cauchy (robuste lorsque l’estimation courante est éloignée du minimum global) et la méthode différentielle de Gauss-Newton (dont la convergence quadratique ultra-rapide opère dès que l’algorithme pénètre dans le voisinage immédiat du point stationnaire optimal). Dès lors que l’utilisateur impose des contraintes physiques sur le domaine des paramètres via l’argument bounds=(bornes_inf, bornes_sup), la routine bascule de manière transparente vers l’algorithme Trust Region Reflective (TRF), capable de gérer des systèmes linéaires et non linéaires sous contraintes de boîtes bornées.
La mise en œuvre implique la définition d’une fonction modèle explicite en syntaxe Python standard. Cette fonction doit impérativement adopter comme premier paramètre formel la variable explicative x, suivie individuellement ou sous forme dépaquetée de l’ensemble des paramètres libres θ1, θ2, …, θp à calibrer. La fonction doit être vectorisée dans son implémentation interne via des opérations NumPy pures afin que curve_fit puisse évaluer simultanément l’ensemble du vecteur des observations sans recourir à des boucles interprétées prohibitives.
8.2 Sensibilité aux conditions initiales (p0)
L’écueil prépondérant des algorithmes d’optimisation non linéaire réside dans la non-convexité structurelle de leur surface de perte. Contrairement à l’élégante cuvette parabolique des moindres carrés ordinaires linéaires qui ne possède qu’un seul point critique, les problèmes non linéaires présentent des paysages topologiques tourmentés, constellés de multiples vallées locales, de zones de gradient quasi-nul (plateaux d’invariance) et de gouffres de divergence numérique. En conséquence, le vecteur des estimations initiales, passé à la fonction via l’argument p0 (initial guess), conditionne de manière critique l’issue du processus d’ajustement.
Si l’analyste omet de renseigner p0, curve_fit assigne par défaut la valeur scalaire 1.0 à l’ensemble des paramètres libres du modèle. Cette initialisation arbitraire se révèle fréquemment catastrophique, précipitant le solveur vers un minimum local stérile ou provoquant une non-convergence sanctionnée par une levée d’erreur RuntimeError: Optimal parameters not found. Il incombe donc au modélisateur de développer des heuristiques physiques rigoureuses pour extraire des valeurs initiales réalistes directement à partir de l’inspection descriptive des données brutes : déterminer les asymptotes par les moyennes des plateaux extrêmes, évaluer la pente maximale par dérivation discrète locale, ou identifier le point médian en localisant l’abscisse correspondant à la demi-amplitude du signal.
Dans des configurations particulièrement retorses où le modèle recèle des couplages paramétriques fortement résonnants ou oscillatoires, même une heuristique experte peut échouer. Dans ces circonstances, il convient d’abandonner l’initialisation ponctuelle locale au profit de démarches d’optimisation stochastique globale. L’emploi préalable de l’algorithme d’évolution différentielle (scipy.optimize.differential_evolution) permet de cartographier globalement l’espace des phases paramétriques pour isoler le bassin d’attraction du minimum mondial absolu, dont les coordonnées serviront subséquemment de vecteur p0 ultra-précis pour une finition rapide par curve_fit.
8.3 Exploitation de la matrice de covariance estimée (pcov)
Lors d’un ajustement réussi, scipy.optimize.curve_fit retourne un tuple fondamental composé de deux éléments : le vecteur optimal popt (pour parameters optimal) et la matrice bidimensionnelle pcov (pour parameters covariance). Alors que les praticiens néophytes limitent trop souvent leur lecture au vecteur popt, l’inférence statistique et l’intégrité métrologique reposent entièrement sur l’exploitation approfondie de la matrice de covariance pcov ∈ ℜp×p.
La matrice pcov correspond à l’inverse asymptotique de la matrice hessienne de la surface de coût au point optimal, renormalisée par la variance résiduelle estimée. Les éléments situés sur sa diagonale principale pcov[j, j] représentent précisément la variance statistique asymptotique de chaque paramètre individuel θj. Par conséquent, l’écart-type ou erreur-type (standard error) associée à l’estimation du paramètre s’obtient instantanément par l’opération vectorisée : perr = numpy.sqrt(numpy.diag(pcov)). Cette valeur permet d’énoncer un résultat scientifique dans les règles de l’art sous la forme probabiliste : θj = popt[j] ± 1.96 · perr[j] pour un intervalle de confiance bilatéral à 95 %.
En revanche, les éléments extra-diagonaux pcov[j, k] (avec j ≠ k) décrivent la covariance mutuelle entre paramètres distincts. La normalisation de ces termes hors-diagonale via la formule Corr(j, k) = pcov[j, k] / √[pcov[j, j] · pcov[k, k]] produit la matrice de corrélation paramétrique. Si deux paramètres affichent un coefficient de corrélation s’approchant de +1.0 ou -1.0, cela met en évidence une compensation paramétrique dégénérée (équifinalité) : le modèle est sur-paramétré par rapport au pouvoir résolutif des données, signifiant qu’une multiplicité infinie de combinaisons simultanées de ces deux paramètres produira une qualité d’ajustement strictement indiscernable.
9. Modélisation de fonctions non linéaires archétypales
9.1 Modèles exponentiels et processus de désintégration ou croissance
Les processus cinétiques de relaxation, de dégradation ou de prolifération constituent des manifestations fonctionnelles universelles dans les sciences de la nature et de l’esprit. Dans le champ des sciences cognitives, la modélisation canonique de la trace mnésique introduite par Hermann Ebbinghaus postule une désintégration exponentielle de la rétention d’information au cours de l’intervalle temporel écoulé : R(t) = a · e-k t + c, où a représente l’amplitude de mémorisation initiale, k est la constante cinétique d’oubli, et c délimite le niveau d’ancrage asymptotique résiduel.
L’ajustement direct de ce modèle non linéaire via scipy.optimize.curve_fit surpasse catégoriquement la méthodologie historique par transformation logarithmique ln(R – c) = ln(a) – k t. Cette dernière impose l’écueil insurmontable de présupposer la valeur de l’asymptote c (qui ne peut être évaluée directement si elle n’est pas nulle), tout en induisant une distorsion hétéroscédastique sévère sur les faibles amplitudes où les fluctuations résiduelles se trouvent indûment amplifiées. En conservant l’espace métrique originel des observations, l’ajustement direct non linéaire assure un calibrage thermodynamiquement et statistiquement cohérent.
Pour des phénomènes neurophysiologiques ou pharmacocinétiques plus complexes, la cinétique observée fait souvent intervenir deux échelles de temps disjointes, imposant un ajustement exponentiel bi-phasique : y(t) = a1 e-k1 t + a2 e-k2 t + c. Ce modèle capture élégamment une phase de clairance rapide couplée à une élimination lente. Il présente toutefois un risque aigu de quasi-colinéarité si les constantes k1 et k2 sont du même ordre de grandeur, exigeant l’application de bornes strictes (bounds) pour forcer la hiérarchie temporelle k1 > k2 > 0 lors de l’exécution de l’algorithme.
9.2 Modèles sigmoïdes et logistiques à quatre paramètres (4PL)
Les transitions comportementales de type « tout-ou-rien », les courbes d’apprentissage psychométriques et les protocoles pharmacodynamiques de dose-réponse répondent quasi-systématiquement à une cinétique sigmoïdale saturante. Le standard de référence absolu pour encapsuler cette morphologie est le modèle logistique à quatre paramètres, couramment désigné par l’acronyme 4PL (Four-Parameter Logistic model). Son expression formelle s’énonce ainsi : f(x) = A + (B – A) / [1 + 10(C – x) · D], ou sous sa forme naturelle équivalente : f(x) = A + (B – A) / [1 + exp(-k · (x – x0))].
La puissance de cette formulation réside dans l’interprétabilité phénoménologique directe et transparente de chacun de ses quatre paramètres constitutifs :
- A (plancher) : représente la réponse basale minimale observée pour des stimuli d’intensité infinitésimale (asymptote inférieure).
- B (plafond) : correspond à la capacité maximale de performance ou d’activation du système physique (asymptote supérieure saturante).
- x0 ou C (point médian ou EC50) : dénote la valeur de la variable explicative x induisant une réponse rigoureusement égale à la demi-amplitude (A + B) / 2, mesurant ainsi la sensibilité ou le seuil intrinsèque de basculement.
- k ou D (coefficient de pente ou de Hill) : quantifie la coopérativité ou la raideur de la transition cinétique au niveau du point d’inflexion ; une pente élevée signalant une transition abruptement bistable.
L’ajustement d’un modèle 4PL requiert toutefois une attention soutenue quant à la stabilité des bornes asymptotiques. Si le protocole expérimental a négligé d’échantillonner des concentrations ou des temps suffisamment extrêmes pour observer les débuts de plateaux horizontaux, l’algorithme d’optimisation tendra à extrapoler les paramètres A et B vers des amplitudes infinies avec des variances colossales dans la matrice pcov. L’adjonction de contraintes raisonnables (ex. : forcer A ≥ 0 et B ≤ 100 % de réussite) au sein de l’argument bounds de curve_fit stabilise l’inversion matricielle et prévient tout décrochage computationnel.
9.3 Fonctions de puissance et distributions hyperboliques
Dans l’analyse des latences cognitives et de l’acquisition d’automatismes comportementaux, les lois de puissance occupent un rang prépondérant. Deux formulations théoriques s’affrontent régulièrement dans la littérature spécialisée : la célèbre loi de puissance de la pratique proposée par Snoddy, prédisant que le temps de réaction TR s’atténue avec le nombre d’essais N selon l’équation TR(N) = a · N-b + c, et la théorie psychophysique de Stevens stipulant que la perception sensorielle S croît comme une fonction de puissance de l’intensité physique du stimulus I : S(I) = k · Ia.
L’ajustement direct non linéaire de la fonction puissance y = a · xb + c avec curve_fit présente l’immense avantage de permettre la quantification directe du temps incompressible résiduel c (temps de transmission motrice et sensorielle périphérique). De manière analogue, les cinétiques de saturation métabolique ou enzymatique d’organites neuronaux relèvent de la dynamique hyperbolique de Michaelis-Menten : v = (Vmax · [S]) / (Km + [S]), où Vmax désigne la vélocité catalytique maximale et Km la constante d’affinité substratique.
La controverse récurrente en sciences cognitives quant à savoir si la courbe d’apprentissage est régie par une loi de puissance (modèle hyperbolique) ou par une cinétique exponentielle (modèle de décroissance pure) peut être tranchée rigoureusement en Python. En réalisant l’ajustement des deux modèles concurrents sur la même série empirique, puis en procédant à un calcul différentiel d’AICc et d’intervalles résiduels, le chercheur dispose d’une méthodologie décisionnelle objective pour identifier l’architecture fonctionnelle la plus cohérente avec l’organisation neuronale sous-jacente.
10. Inférence statistique, résidus et intervalles d’incertitude
10.1 Diagnostic approfondi des résidus
L’extraction d’un vecteur de paramètres optimaux et l’affichage d’un résidu globalement satisfaisant ne sauraient clore un travail d’ajustement rigoureux. Le statut scientifique d’un modèle dépend impérativement de la validation statistique a posteriori des hypothèses formulées sur les erreurs résiduelles : la normalité, l’absence d’autocorrélation sérielle et l’homoscédasticité.
Pour vérifier l’hypothèse de non-corrélation sérielle temporelle ou spatiale des erreurs, l’analyste fait appel à la statistique de Durbin-Watson. Définie par le ratio DW = ∑i=2N (ei – ei-1)2 / ∑i=1N ei2, cette métrique oscille dans l’intervalle [0, 4]. Une valeur proche de 2.0 confirme l’indépendance mutuelle idéale des résidus. Une valeur substantiellement inférieure à 1.5 trahit une autocorrélation positive majeure (les résidus positifs sont suivis de résidus positifs), signalant l’omission impardonnable d’une composante dynamique périodique ou d’une dérive instrumentale continue au sein du modèle.
La normalité de la distribution des résidus conditionne quant à elle la validité probabiliste des intervalles de confiance asymptotiques déduits de la matrice pcov. Cette conformité est examinée graphiquement par la génération de diagrammes quantile-quantile (Q-Q plots via scipy.stats.probplot) confrontant les quantiles empiriques aux quantiles théoriques d’une gaussienne, et sanctionnée formellement par le test d’hypothèse de Shapiro-Wilk (scipy.stats.shapiro). Enfin, l’hypothèse d’homoscédasticité (variance résiduelle uniforme) est scrutée par le test de Breusch-Pagan. En cas d’hétéroscédasticité manifeste, l’ajustement doit être réexécuté en passant un vecteur d’incertitudes expérimentales σi à l’argument sigma de curve_fit, configurant une régression par moindres carrés pondérés (WLS).
10.2 Propagation des incertitudes et bandes de confiance
Une courbe ajustée représentée sous la forme d’un trait mathématique infiniment fin relève d’une illusion positiviste trompeuse. Tout modèle estimé à partir d’un échantillon fini de données bruitées est lui-même entaché d’incertitude stochastique. Il est impératif de distinguer rigoureusement deux notions d’incertitude spatiale : la bande de confiance (confidence band), qui quantifie l’imprécision sur la localisation de la « vraie » fonction théorique moyenne, et l’intervalle de prédiction (prediction interval), beaucoup plus large, qui incorpore en sus la variance stochastique propre à chaque observation future individuelle.
La construction analytique de la bande de confiance à (1 – α) % pour une fonction non linéaire quelconque f(x; θ) repose sur la méthode delta de propagation des incertitudes. Elle implique le calcul du vecteur gradient local de la fonction par rapport aux paramètres : J(x) = [∂f / ∂θ1, …, ∂f / ∂θp]. La variance locale de la prédiction moyenne au point x s’obtient alors par la projection matricielle : σf2(x) = J(x) · pcov · J(x)T. La demi-largeur de la bande de confiance à 95 % s’exprime par le produit tcrit · σf(x), où tcrit est le quantile issu de la distribution de Student à N – p degrés de liberté.
L’implémentation graphique de cette bande se réalise via la méthode matplotlib.pyplot.fill_between, ombrant délicatement la région d’incertitude de part et d’autre de la courbe centrale. L’observation attentive de cette géométrie révèle un rétrécissement de la bande dans les zones centrales concentrant une haute densité d’échantillonnage, et un évasement prononcé en entonnoir aux extrémités du domaine expérimental. Cette visualisation matérialise avec éclat la perte rapide de confiance statistique dès lors que le modélisateur s’approche des frontières de son échantillon empirique.
10.3 Approches computationnelles : Bootstrapping non paramétrique
Lorsque la taille de l’échantillon est restreinte ou que les tests diagnostiques révèlent des déviations patentes par rapport à la normalité des erreurs, l’estimation analytique de l’incertitude via la matrice asymptotique pcov devient caduque et hautement risquée. L’analyste moderne privilégie alors les méthodes computationnelles de rééchantillonnage intensif, dont le bootstrapping non paramétrique par paires constitue le parangon d’élégance méthodologique.
Le principe algorithmique du bootstrap consiste à traiter l’échantillon empirique observé comme une pseudo-population source. Une boucle de calcul répète B itérations (typiquement B = 1000 à 5000). À chaque cycle, un échantillon synthétique de taille identique N est généré par tirage aléatoire uniforme avec remise parmi les paires de coordonnées {(xi, yi)} d’origine. L’algorithme d’ajustement non linéaire curve_fit est réexécuté sur chaque réplique bootstrap, archivant à chaque étape le vecteur de coefficients résultant θ*b.
Au terme des B convergences, le chercheur dispose d’une distribution empirique complète pour chaque paramètre du modèle. Il devient dès lors trivial de calculer les intervalles de confiance empiriques par la méthode directe des percentiles (en extrayant les valeurs aux seuils de 2.5 % et 97.5 % via numpy.percentile), sans formuler la moindre hypothèse sur la forme gaussienne de la distribution sous-jacente. Cette approche robuste met fréquemment en lumière des asymétries de distribution profondes que les méthodes asymptotiques linéaires classiques étaient par nature incapables d’appréhender.
11. Ajustement robuste en présence de valeurs aberrantes (Outliers)
11.1 Vulnérabilité des moindres carrés classiques aux anomalies
La dépendance fondamentale de l’estimateur des moindres carrés ordinaires envers la métrique quadratique L2 en constitue paradoxalement la vulnérabilité opérationnelle la plus dévastatrice. Parce que le résidu individuel est élevé à la puissance 2, une unique observation aberrante (survenue à la suite d’un artefact instrumental, d’une seconde d’inattention du sujet expérimental ou d’une erreur de saisie typographique) située à 5 ou 10 écarts-types de la moyenne génère une force de rappel résiduelle gigantesque dans le gradient d’optimisation.
Dans un contexte d’ajustement polynomial ou non linéaire, ce mécanisme pervers aboutit à ce que les statisticiens désignent sous le concept d’effet de levier élevé (high leverage point). Le solveur d’optimisation consent à dégrader substantiellement l’adéquation de la courbe sur 95 % des données saines dans le seul but pathologique de rapprocher artificiellement la trajectoire continue de cette unique anomalie discordante. Le résultat final est un modèle lourdement biaisé, dont les paramètres ne reflètent plus du tout la cinétique physique ou cognitive réelle du phénomène sous observation.
Face à ce fléau métrologique, l’attitude courante consistant à purger manuellement et arbitrairement les points suspects d’un jeu de données constitue une faute méthodologique majeure : cette pratique expose l’analyste au biais de confirmation et détruit la validité inférentielle des tests statistiques standard. La seule réponse épistémologiquement réfutable consiste à substituer aux moindres carrés classiques des architectures de régression mathématiquement robustes, spécifiquement configurées pour désensibiliser l’ajustement vis-à-vis des déviations extrêmes sans éliminer aucune observation du corpus.
11.2 Fonctions de perte robustes avec scipy.optimize.least_squares
Pour immuniser l’ajustement contre les points aberrants dans l’écosystème SciPy, il convient de délaisser la fonction généraliste curve_fit au profit du solveur d’optimisation de niveau inférieur mais considérablement plus puissant : scipy.optimize.least_squares. Ce module hautement spécialisé intègre nativement la théorie des M-estimateurs, permettant de substituer à la perte quadratique standard ρ(z) = z2 des fonctions de coût scalaires dites sous-quadratiques, dont le taux de croissance s’atténue progressivement face aux résidus d’amplitude démesurée.
Le solveur met à disposition de l’utilisateur plusieurs fonctions de perte robustes paramétrables via l’argument loss :
- Perte de Huber (loss=’huber’) : adopte un comportement strictement quadratique pour les résidus inférieurs à un seuil critique δ, puis bascule de manière différentiable vers une croissance purement linéaire pour les erreurs majeures, neutralisant ainsi leur effet de levier destructeur.
- Perte Soft L1 (loss=’soft_l1′) : assure une transition douce et continue entre une parabole au voisinage de zéro et une asymptote linéaire absolue 2 · (√(1 + z2) – 1), garantissant une différentiabilité sans singularité.
- Perte de Cauchy (loss=’cauchy’) : inspirée de la distribution de Lorentz, elle s’exprime par la fonction logarithmique ln(1 + z2) ; sa dérivée première tend vers zéro lorsque l’erreur tend vers l’infini, annihilant littéralement l’influence des déviations colossales.
La comparaison expérimentale des courbes obtenues met en scène un spectacle saisissant : alors que les moindres carrés conventionnels dévient spectaculairement de leur cible théorique sous l’effet de quelques données synthétiques artificiellement corrompues, la régression équipée de la perte de Huber ou de Cauchy traverse imperturbablement le nuage de points sains comme si les anomalies n’avaient jamais existé. L’exploitation de l’argument f_scale permet de calibrer finement le seuil de sensibilité au-delà duquel un résidu cesse d’être considéré comme normal pour être traité comme une fluctuation aberrante.
11.3 Algorithme RANSAC appliqué aux modèles de courbes
Dans des configurations extrêmes où le taux de contamination par des anomalies dépasse 20 à 30 % de la masse globale des données, même les M-estimateurs de Huber peuvent subir un point de rupture (breakdown point) et se laisser corrompre par des paquets compacts de mesures parasites. Le recours à des algorithmes de consensus stochastique devient alors impératif, au premier rang desquels figure l’illustre algorithme RANSAC (Random Sample Consensus).
Conçu originellement pour le traitement d’images et la vision artificielle par Fischler et Bolles, le paradigme RANSAC fonctionne selon une logique d’échantillonnage minimal itératif. À chaque itération, l’algorithme sélectionne de manière totalement aléatoire le nombre minimal strict d’observations mathématiquement nécessaires pour instancier le modèle (par exemple, 4 points pour un polynôme cubique). Le modèle est immédiatement calculé sur ce micro-ensemble, puis évalué sur l’intégralité des observations restantes du jeu de données. Tous les points dont la distance résiduelle absolue se situe en deçà d’un seuil de tolérance prédéterminé ε sont labellisés comme membres du groupe de consensus ou inliers (points intègres).
Cette boucle se répète un nombre d’itérations précalculé pour garantir statistiquement qu’au moins un tirage initial soit exempt de toute contamination. Le modèle final est alors réestimé par moindres carrés ordinaires exclusivement sur le plus large ensemble de consensus consolidé au cours de la procédure. L’implémentation de cette technique en Python est assurée avec une efficacité remarquable par la classe RANSACRegressor issue de la bibliothèque scikit-learn, acceptant n’importe quel estimateur de base polynomial ou linéaire. Les attributs booléens résultants inlier_mask_ et outlier_mask_ permettent d’isoler déterministement les anomalies pour un rapport diagnostique exhaustif sans altérer l’intégrité du modèle calibré.
12. Guide pratique, synthèse méthodologique et bonnes pratiques
12.1 Arbre de décision pour le choix de l’algorithme d’ajustement
La multitude d’options logicielles et théoriques disponibles au sein de l’écosystème scientifique Python impose l’élaboration d’une grille de décision méthodologique systématique. Face à une série de données empiriques non linéaires, le premier embranchement logique concerne la nature phénoménologique du modèle ciblé : la fonction dérive-t-elle d’une équation différentielle mécanistique issue de la théorie physique ou biologique (ex. : cinétique de Michaelis-Menten, équation 4PL), ou s’agit-il d’une démarche purement descriptive et empirique d’approximation sans présupposé théorique ?
Si la démarche relève de l’approximation descriptive univariée, l’emploi de la classe moderne numpy.polynomial.Polynomial.fit ou d’ajustements par splines de lissage (scipy.interpolate.UnivariateSpline) doit être systématiquement privilégié. Les splines cubiques par morceaux surclassent quasi-invariablement les polynômes globaux d’ordre élevé en jugulant définitivement le phénomène d’instabilité aux bornes de Runge grâce à leur continuité locale par morceaux. En revanche, si la démarche poursuit un objectif mécanistique visant l’extraction de paramètres porteurs de sens sémantique, le passage vers scipy.optimize.curve_fit ou least_squares devient obligatoire.
Le second filtre décisionnel évalue le niveau d’intégrité stochastique de l’échantillon. Si le signal présente une propreté instrumentale irréprochable et respecte l’homoscédasticité, scipy.optimize.curve_fit avec l’algorithme par défaut de Levenberg-Marquardt délivre une convergence d’une rapidité optimale. Dès lors qu’apparaissent des contraintes structurelles sur le domaine des paramètres (impossibilité physique de constantes négatives), l’argument bounds doit être activé. Enfin, si l’échantillon est susceptible d’héberger des anomalies aberrantes sévères, l’analyste migrera directement vers scipy.optimize.least_squares armé d’une fonction de perte de Huber ou déploiera RANSACRegressor pour garantir l’immunité structurelle de ses estimations.
12.2 Optimisation du code et déploiement en production
La mise en production industrielle d’algorithmes d’ajustement de courbes ou leur application à des volumes de données massifs (tels que l’analyse pixel par pixel en imagerie par résonance magnétique fonctionnelle ou le traitement en temps réel de flux financiers) impose des exigences de performance computationnelle drastiques. Le premier impératif réside dans la vectorisation intégrale de la fonction modèle. L’utilisation d’opérateurs scalaires Python purs au sein du corps de la fonction passée à curve_fit bride dramatiquement le solveur, contraignant le ramasse-miettes (garbage collector) à des allocations d’objets inutiles lors des millions d’appels différentiels.
Lorsque la complexité analytique de la fonction modèle défie les capacités de vectorisation de NumPy (par exemple, si le calcul implique des intégrations numériques imbriquées ou des évaluations séquentielles récursives), il devient extrêmement avantageux de recourir à des compilateurs Just-In-Time (JIT) tels que Numba. En décorant la fonction modèle avec @numba.jit(nopython=True, fastmath=True), le code Python est dynamiquement compilé en code machine natif optimisé par LLVM, délivrant des gains de vitesse de calcul spectaculaires pouvant atteindre deux ordres de grandeur lors de l’exécution itérative par SciPy.
Pour ce qui concerne la persistance logicielle et le déploiement opérationnel des modèles calibrés, la sérialisation des objets constitue une étape pivot. Plutôt que de consigner les paramètres bruts dans des fichiers textes précaires, il est hautement recommandé d’exploiter la bibliothèque joblib (ou pickle standard). L’instruction joblib.dump(modele, ‘modele_calibre.joblib’) capture non seulement le vecteur popt et la matrice pcov, mais également l’ensemble des métadonnées contextuelles : versions logicielles de NumPy et SciPy, scores d’information AIC, horodatage d’entraînement et identifiants de traçabilité, assurant une gouvernance rigoureuse du cycle de vie du modèle (MLOps).
12.3 Synthèse et pièges majeurs à éviter
Au terme de ce parcours méthodologique approfondi, il convient de condenser sous forme de règles canoniques les erreurs récurrentes qui polluent la littérature d’ajustement de courbes. Le piège le plus universel et intellectuellement destructeur demeure l’extrapolation inconsidérée. Un modèle d’ajustement n’est rigoureusement valide que sur l’intervalle spatial ou temporel défini par le support de ses observations d’étalonnage. Extrapoler une courbe polynomiale ou logistique hors de ces frontières relève de la spéculation aveugle, les fonctions mathématiques adoptant des asymptotes souvent diamétralement opposées à la dynamique physique réelle du système hors champ.
Une confusion épistémologique fréquente consiste également à assimiler l’excellence d’un ajustement fonctionnel à la preuve formelle d’un lien de causalité empirique. Le fait qu’une cinétique comportementale épouse fidèlement une loi logistique ou une loi de puissance ne prouve aucunement que les mécanismes computationnels du cortex cérébral fonctionnent selon les postulats microscopiques de ces équations. De multiples mécanismes physiques fondamentalement antagonistes peuvent converger vers une signature macroscopique fonctionnellement indiscernable, un problème identifié en philosophie des sciences sous le vocable de sous-détermination de la théorie par les données.
Enfin, le chercheur veillera à conjurer l’hubris de la sur-paramétrisation. John von Neumann rappelait malicieusement : « Avec quatre paramètres, je peux faire tenir un éléphant dans une équation, et avec cinq, je peux lui faire remuer la trompe. » La sophistication algorithmique moderne offerte par des bibliothèques telles que NumPy et SciPy ne doit jamais se substituer à la rigueur critique. Un ajustement de courbe exemplaire n’est pas celui qui atteint un résidu nul par une débauche de degrés de liberté parasites, mais celui qui réussit, à travers une formulation sobre et parcimonieuse, à isoler l’invariance déterministe au milieu du chaos stochastique des mesures.
Références
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716-723. https://doi.org/10.1109/TAC.1974.1100705
- Fischler, M. A., & Bolles, R. C. (1981). Random sample consensus: a paradigm for model fitting with applications to image analysis and automated cartography. Communications of the ACM, 24(6), 381-395. https://doi.org/10.1145/358669.358692
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357-362. https://doi.org/10.1038/s41586-020-2649-2
- Huber, P. J. (1981). Robust statistics. John Wiley & Sons. https://doi.org/10.1002/0471725280
- Levenberg, K. (1944). A method for the solution of certain non-linear problems in least squares. Quarterly of Applied Mathematics, 2(2), 164-168. https://doi.org/10.1090/qam/10666
- Marquardt, D. W. (1963). An algorithm for least-squares estimation of nonlinear parameters. Journal of the Society for Industrial and Applied Mathematics, 11(2), 431-441. https://doi.org/10.1137/0111030
- McKinney, W. (2010). Data structures for statistical computing in Python. Proceedings of the 9th Python in Science Conference, 445, 51-56. https://doi.org/10.25080/Majora-92bf1924-003
- Pedregosa, F., Varoquaux, G., Gramfort, A., Michel, V., Thirion, B., Grisel, O., … & Duchesnay, E. (2011). Scikit-learn: Machine learning in Python. Journal of Machine Learning Research, 12, 2825-2830.
- Runge, C. (1901). Über empirische Funktionen und die Interpolation zwischen äquidistanten Ordinaten. Zeitschrift für Mathematik und Physik, 46, 224-243.
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261-272. https://doi.org/10.1038/s41592-019-0686-2