
Dans le domaine du traitement numérique du signal visuel et de la science des données expérimentales, la manipulation et la restitution graphique des matrices d’intensité lumineuse constituent un jalon méthodologique fondamental. Alors que l’imagerie contemporaine privilégie l’encodage trichromatique pour se conformer aux récepteurs rétiniens de l’observateur humain, de multiples champs scientifiques — allant de la vision par ordinateur à la psychophysique de la perception — nécessitent une rétrogradation contrôlée vers des représentations scalaires monochromes. Dans ce contexte, l’écosystème scientifique du langage Python s’impose comme une référence incontournable, articulant les capacités de manipulation de tableaux multidimensionnels de NumPy, la flexibilité de traitement d’images de Pillow et la puissance de restitution cartographique de la bibliothèque Matplotlib.
Cependant, la transition d’un tenseur couleur tridimensionnel vers une projection visuelle fidèle en niveaux de gris recèle des subtilités algorithmiques et théoriques fréquemment sous-estimées. Loin de se résumer à une simple opération cosmétique, l’affichage d’une image en nuances de gris met en jeu des notions complexes de photométrie physiologique, de compression dimensionnelle de structures matricielles et de sélection rigoureuse de tables de correspondance colorimétrique (colormaps). Une mauvaise compréhension des mécanismes internes du moteur de rastérisation de Matplotlib conduit inévitablement à des artefacts visuels préjudiciables, tels que la colorisation involontaire en fausses couleurs ou l’écrasement de contrastes spatiaux déterminants pour l’analyse computationnelle.
Le présent article propose une exploration exhaustive, rigoureuse et didactique de la chaîne de traitement permettant d’afficher une image en niveaux de gris avec Matplotlib. En croisant les exigences du génie logiciel avec les impératifs méthodologiques de la recherche en vision computationnelle et en neurosciences cognitives, nous détaillerons chaque étape du processus : depuis l’acquisition des données brutes en mémoire jusqu’aux subtilités d’exportation pour des publications académiques à haute résolution, en passant par l’analyse critique des formules de conversion de luminance et le calibrage de la dynamique de contraste.
1. Introduction aux représentations en niveaux de gris et visualisation de données
1.1 Fondements théoriques de l’échelle de gris en imagerie numérique
L’imagerie numérique en niveaux de gris repose sur le concept de luminance monochromatique, défini comme la mesure scalaire de l’intensité énergétique émise, transmise ou réfléchie par un élément de surface spatialement délimité, couramment nommé pixel. Contrairement aux espaces chromatiques trichromes — tels que le modèle rouge, vert, bleu (sRGB) standardisé par la Commission Électrotechnique Internationale — qui nécessitent l’assignation de trois coordonnées indépendantes par point échantillonné, l’échelle de gris projette l’information visuelle sur une dimension unique. Cette projection implique une cartographie continue ou discrétisée de l’intensité lumineuse comprise entre une absence théorique de signal, caractérisant le noir absolu, et une saturation radiative maximale, correspondant au blanc spectral.
D’un point de vue analytique et algorithmique, la réduction de la dimensionnalité chromatique offre un avantage computationnel considérable. En faisant transiter un tenseur tridimensionnel de dimensions hauteur, largeur et canaux spectraux vers une matrice bidimensionnelle d’intensité pure, les exigences en termes de mémoire vive et de temps de calcul sont divisées par un facteur substantiel. Cette simplification permet d’appliquer directement des opérateurs d’algèbre linéaire, des filtres de convolution spatiale pour la détection de contours (comme les opérateurs de Sobel, Prewitt ou de Canny) ou encore des transformations fréquentielles de Fourier, sans se heurter aux ambiguïtés inhérentes à l’interaction différentielle des canaux spectraux.
Il est toutefois impératif d’opérer une différenciation épistémologique stricte entre l’intensité physique mesurable d’un front d’onde électromagnétique et le codage numérique scalaire alloué à chaque pixel. Dans le monde physique, la luminance correspond à une grandeur photométrique exprimée en candelas par mètre carré (cd/m²), pondérée par la fonction d’efficacité lumineuse spectrale de l’œil humain. En revanche, au sein d’une matrice numérique, cette valeur est discrétisée, le plus souvent sur 8 bits (prenant ainsi des valeurs entières positives comprises entre 0 et 255) ou sous forme de valeurs flottantes normalisées sur l’intervalle unitaire réel. Cette abstraction numérique implique que le rendu visuel sur un moniteur dépendra fondamentalement de la fonction de transfert électro-optique du dispositif d’affichage, introduisant ainsi une dissociation critique entre la donnée matricielle brute et sa perception finale.
1.2 Pertinence méthodologique en psychologie expérimentale et neurosciences cognitives
Au sein des laboratoires de psychologie cognitive et de neurophysiologie visuelle, l’emploi de stimuli en niveaux de gris ne relève pas d’une simple préférence esthétique, mais d’une rigoureuse nécessité méthodologique. Le premier impératif concerne l’élimination systématique des variables parasites liées à la saillance chromatique. Lors de protocoles mesurant l’attention visuelle sélective, l’exploration oculométrique ou l’évaluation affective d’images naturelles, la présence de teintes saturées induit des biais perceptifs massifs. Par exemple, la présence d’une composante rouge dans une scène visuelle déclenche une saillance exogène involontaire susceptible de court-circuiter les mécanismes d’exploration descendante (top-down processing) que le chercheur cherche précisément à isoler.
En outre, la standardisation des stimuli visuels à travers une échelle d’intensité unique est une condition indispensable pour la comparabilité des protocoles évaluant les temps de réaction motrice et les seuils différentiels de détection. En calibrant finement la luminance moyenne et le contraste quadratique (Root-Mean-Square Contrast) de séries d’images monochromatiques, l’expérimentateur s’assure que les variations observées dans les latences électroencéphalographiques (notamment les composantes précoces telles que la P100 ou la N170) sont strictement imputables aux caractéristiques structurales, sémantiques ou spatiales du stimulus, et non à des disparités de flux photonique atteignant la rétine périphérique du sujet testé.
Sur le plan de l’architecture fonctionnelle cérébrale, l’échelle de gris présente une compatibilité théorique directe avec les modèles de traitement primaire localisés au sein de la voie visuelle magnocellulaire. Les cellules ganglionnaires rétiniennes à centre et pourtour antagonistes projetant vers les couches magnocellulaires du corps genouillé latéral possèdent une résolution temporelle élevée et une sensibilité accrue aux très faibles contrastes de luminance, tout en étant totalement aveugles aux variations chromatiques (achromatisme fonctionnel). Travailler avec des matrices en niveaux de gris permet ainsi de modéliser avec fidélité les entrées sensorielles primaires alimentant le cortex visuel primaire (aire striée V1), facilitant la confrontation entre prédictions théoriques issues de filtres de Gabor et enregistrements empiriques.
1.3 Rôle de l’écosystème Python et Matplotlib dans l’analyse visuelle
Au cours des deux dernières décennies, le langage de programmation Python a consolidé sa position de standard hégémonique pour le calcul scientifique, l’intelligence artificielle et l’analyse de données expérimentales. Au cœur de cette architecture logicielle se trouve Matplotlib, une bibliothèque de visualisation développée originellement par John D. Hunter pour reproduire l’environnement d’analyse matricielle de MATLAB au sein d’un écosystème ouvert et modulaire. Matplotlib ne constitue pas seulement une boîte à outils de traçage statistique ; elle intègre un véritable moteur de rendu graphique vectoriel et matriciel capable d’interagir nativement avec les structures de données les plus complexes.
L’une des plus grandes forces de cet environnement réside dans l’interopérabilité fluide entre trois bibliothèques logicielles spécialisées : Pillow (la déclinaison contemporaine de la bibliothèque historique PIL), conçue pour l’encodage, le décodage et la gestion des flux de métadonnées d’images raster ; NumPy, le socle de calcul tensoriel fournissant des tableaux denses en C contigu et des fonctions d’algèbre linéaire hautement optimisées ; et enfin le sous-module matplotlib.pyplot, dédié à la composition scénographique, à la cartographie des espaces colorimétriques et à la rastérisation matérielle.
L’objectif méthodologique de ce manuel d’implémentation est de dépasser le niveau des recettes superficielles pour décortiquer précisément chaque segment de l’architecture d’exécution sous-jacente. Il s’agira d’outiller le chercheur, l’ingénieur et le data scientist avec les concepts mathématiques et algorithmiques nécessaires pour manipuler rigoureusement les matrices d’intensité, neutraliser les pièges courants liés à l’interprétation colorimétrique par défaut, et produire des visualisations irréprochables tant sur le plan de la rigueur scientifique que de la précision graphique.
2. Les principes fondamentaux de l’affichage d’images avec Matplotlib
2.1 La fonction plt.imshow() et son fonctionnement sous-jacent
Au cœur du sous-module matplotlib.pyplot, la fonction imshow() (abréviation transparente de image show) représente le point d’entrée principal pour la visualisation de données bidimensionnelles et tridimensionnelles. Sous une apparente simplicité syntaxique, cette fonction dissimule une chaîne complexe de transformations géométriques et photométriques. L’architecture de imshow() ne se contente pas de dupliquer les pixels d’un fichier source sur l’écran ; elle instancie un objet graphique dédié de la classe matplotlib.image.AxesImage, lequel est attaché à un système de coordonnées cartésiennes spécifié par un objet Axes.
Le fonctionnement interne de cette méthode repose sur une dissociation scrupuleuse entre la géométrie de la grille d’échantillonnage et la projection d’intensité. Lorsque imshow() reçoit un tableau en entrée, elle applique d’abord une transformation de coordonnées projectives permettant d’ajuster les proportions matricielles (l’aspect ratio) à l’espace alloué au canevas graphique. Dans le cas d’une entrée scalaire bidimensionnelle, l’algorithme procède ensuite à une étape de normalisation affine des valeurs brutes avant de les propager à travers une table de conversion colorimétrique (ou lookup table, LUT). Cette table associe à chaque valeur scalaire un quadruplet vectoriel représentant les intensités normalisées de rouge, de vert, de bleu et d’opacité alpha.
La gestion de la mémoire au sein de l’objet AxesImage s’opère de manière dynamique. Plutôt que de rastériser immédiatement l’intégralité de la matrice source à la résolution native de l’image d’origine, Matplotlib retarde la génération définitive des fragments de pixels jusqu’à l’étape d’actualisation du rendu (généralement déclenchée par plt.show(), plt.draw() ou fig.savefig()). Cette conception différée permet au moteur graphique d’appliquer des filtres de ré-échantillonnage spatial et d’optimiser l’occupation des tampons vidéo en fonction des dimensions physiques réelles de la fenêtre de traçage, évitant ainsi le gaspillage de ressources computationnelles lors de la manipulation de matrices de résolution gigapixels.
2.2 Gestion des matrices multidimensionnelles et types de données NumPy
L’interfaçage entre les structures de données NumPy et le moteur de Matplotlib repose sur un ensemble de conventions dimensionnelles et typologiques strictes. Matplotlib interprète la nature de l’image projetée en fonction exclusive de la dimensionnalité du tableau ndarray fourni en argument. Une matrice à deux dimensions, formellement caractérisée par une forme (ou shape) égale à (hauteur, largeur), est intrinsèquement comprise par le moteur de rendu comme un champ scalaire abstrait ou une image monochromatique. Dans cette configuration, chaque cellule spatiale ne contient qu’une seule valeur numérique d’intensité, nécessitant l’intervention d’une table de correspondance pour être matérialisée à l’écran.
Inversement, les tenseurs tridimensionnels possédant une structure formelle de dimensions (hauteur, largeur, canaux) signalent immédiatement au moteur d’affichage la présence d’une image couleur composite. Si la taille du troisième axe dimensionnel est égale à 3, les canaux sont invariablement assignés aux composantes primaires rouge, vert et bleu. Si la profondeur est de 4, le quatrième canal est traité comme un masque de transparence alpha régissant la synthèse additive finale sur le fond du canevas. Toute tentative de faire passer une matrice pseudo-monochrome conservant inutilement son troisième axe dimensionnel unitaire (par exemple une forme (H, W, 1)) déclenchera une levée d’exception ou un dysfonctionnement graphique, Matplotlib refusant d’extrapoler arbitrairement le sens de tenseurs non standards.
Au-delà de la topologie géométrique du tableau, Matplotlib applique une heuristique discriminante fondée sur le type de données (dtype) de la matrice NumPy sous-jacente. Si le tableau est codé sous forme d’entiers non signés sur 8 bits (numpy.uint8), l’interpréteur graphique impose d’emblée une quantification discrète sur la plage arithmétique rigoureuse allant de 0 à 255. Dans cette situation, toute valeur numérique franchissant ces bornes subit un dépassement arithmétique (ou integer overflow), entraînant des inversions de polarité aberrantes. À l’inverse, dès lors que le tableau est instancié avec des nombres réels en virgule flottante (numpy.float32 ou numpy.float64), Matplotlib modifie son comportement par défaut : il s’attend scrupuleusement à ce que les valeurs soient déjà normalisées dans l’intervalle continu unitaire [0.0, 1.0]. Si un tableau flottant présente des valeurs s’étendant arbitrairement de 0.0 à 255.0 sans normalisation adéquate, les mécanismes automatiques de saturation écrêtent toutes les données supérieures à 1.0, produisant une image quasi-intégralement blanchie et totalement inexploitable.
2.3 Le comportement d’affichage par défaut face aux images trichromes (RGB)
Une incompréhension fréquente chez les praticiens concerne la réaction de Matplotlib lorsqu’une commande d’affichage de type niveaux de gris est appliquée directement à une image trichromatique sans restructuration matricielle préalable. Lorsqu’un tenseur de dimensions (M, N, 3) est transmis à la méthode imshow(), le sous-système de traçage identifie immédiatement la présence des trois flux spectraux et active son canal de rendu direct RGB. Dans ce mode opératoire, chaque triplet de pixels est traité comme une instruction colorimétrique immuable, directement mappée vers le tampon de trames (framebuffer) de la carte graphique.
La conséquence directe et fondamentale de ce mécanisme interne est la neutralisation pure et simple de l’argument de table de correspondance colorimétrique explicite. Quand bien même l’opérateur spécifierait avec insistance le paramètre cmap='gray' au sein de l’instruction plt.imshow(rgb_array, cmap='gray'), cette directive sera scrupuleusement et silencieusement ignorée par Matplotlib. Le moteur n’émet aucun message d’avertissement ni d’erreur : considérant que l’utilisateur a fourni des composantes de couleur explicites, il juge le recours à une table de correspondance scalaire sans objet et affiche l’image dans sa polychromie d’origine.
Cette observation met en lumière un principe clé du traitement d’images numériques : l’affichage en niveaux de gris n’est pas une simple modalité d’habillage graphique que l’on pourrait solliciter à la dernière étape de restitution visuelle. Il requiert impérativement une transformation structurelle en amont, opérant au cœur même de la matrice de données. L’image doit subir une véritable transformation mathématique de projection, condensant irrévocablement ses trois canaux de couleur en un plan scalaire bidimensionnel unique avant que la moindre fonction de traçage ne soit invoquée.
3. Le chargement et la manipulation préliminaire des images avec PIL (Pillow)
3.1 Importation et ouverture de fichiers d’images matricielles
Dans l’architecture logicielle de traitement de données sous Python, la bibliothèque Pillow constitue le composant de référence pour l’interaction avec le système de fichiers et la décompression des formats graphiques matriciels. L’opération d’importation fondamentale débute par l’invocation de la méthode Image.open() issue du module PIL. Cette méthode implémente un mécanisme d’évaluation paresseuse (lazy evaluation) particulièrement robuste. Lors de son exécution, le moteur ne charge pas immédiatement la totalité des données binaires matricielles au sein de la mémoire vive ; il se contente d’inspecter l’en-tête du fichier binaire pour identifier son format d’encodage (qu’il s’agisse d’un fichier JPEG à transformée en cosinus discrète, d’un PNG à compression sans perte Deflate, ou d’un conteneur TIFF multipage scientifique) et en extraire les métadonnées capitales.
Cette architecture paresseuse garantit une remarquable efficacité mémoire, particulièrement utile lors du parcours itératif de vastes répertoires contenant des milliers de stimuli visuels destinés à des protocoles expérimentaux. Cependant, cette conception implique que l’intégrité physique intégrale des blocs de données n’est validée qu’au moment où une opération effective d’accès aux pixels ou de conversion matricielle est formellement requise. Pour se prémunir contre d’éventuelles corruptions de fichiers survenues lors du transfert ou de l’écriture disque, il est souvent judicieux de solliciter explicitement la méthode load() ou de structurer l’ouverture au sein d’un bloc de gestion de contexte with Image.open(...) as img:, garantissant une fermeture propre des descripteurs de fichiers système associés.
Un autre défi technique récurrent réside dans l’hétérogénéité des canaux auxiliaires intégrés au sein de certains conteneurs graphiques. Les images issues du web ou d’interfaces graphiques intègrent fréquemment un quatrième canal d’opacité, désigné sous le terme de canal alpha. L’existence de ce canal supplétif complique significativement la manipulation matricielle ultérieure : il ne participe pas directement à la luminance énergétique de la scène mais définit le degré d’occlusion géométrique par rapport à un arrière-plan indéterminé. Pillow permet de déceler cette composante dès la lecture initiale, préparant ainsi l’application des étapes de fusion ou de suppression indispensables à l’obtention d’un signal photométrique pur.
3.2 Analyse des dimensions spatiales et des canaux de couleur
Dès l’instanciation de l’objet graphique au sein de la mémoire tampon de Pillow, la première démarche diagnostique consiste à sonder rigoureusement ses propriétés intrinsèques à travers deux attributs fondamentaux : size et mode. L’attribut size retourne un tuple d’entiers structuré selon la convention cartésienne horizontale/verticale (largeur, hauteur). Il convient de souligner avec force une divergence structurelle critique qui constitue un piège classique pour les chercheurs débutants : Pillow quantifie l’espace selon le repère usuel des abscisses et des ordonnées (X, Y), alors que la bibliothèque NumPy, obéissant aux conventions séculaires de l’algèbre matricielle, structure systématiquement ses dimensions selon l’ordre (lignes, colonnes), ce qui correspond géométriquement à (hauteur, largeur).
L’attribut mode, quant à lui, renvoie une chaîne de caractères spécifiant sans ambiguïté l’espace colorimétrique et la profondeur d’échantillonnage binaire sous lesquels le fichier a été encodé. Les modes les plus fréquemment rencontrés dans les environnements de laboratoire comprennent :
- RGB : Échantillonnage standard sur 3 canaux de 8 bits chacun, couvrant l’espace colorimétrique trichrome additif standard (plage de 0 à 255 par canal).
- RGBA : Extension à 4 canaux incorporant un canal alpha de transparence sur 8 bits en sus des composantes trichromes.
- L : Codage monochromatique à canal unique sur 8 bits, représentant explicitement la luminance (plage de 0 à 255).
- CMYK : Modèle de synthèse soustractive sur 4 canaux, utilisé de manière prédominante dans les processus de photogravure et d’impression industrielle.
- 1 : Échelle binaire stricte à un seul bit par pixel, où chaque élément matriciel ne peut valoir que 0 ou 1 (noir pur ou blanc pur).
La cartographie précise de cet espace colorimétrique d’origine est une condition préalable impérative avant d’appliquer une quelconque méthode de transformation en niveaux de gris. Une image encodée en CMYK ou en RGBA ne peut être convertie selon les mêmes formules linéaires directes qu’une image RGB standard, sous peine d’induire des corruptions sévères dans les rapports d’intensité ou de projeter des composantes d’encres ou d’opacité en lieu et place de l’intensité lumineuse recherchée.
3.3 Intégration fluide entre PIL et NumPy via np.asarray()
Une fois l’image correctement instanciée et contrôlée sur le plan dimensionnel, il est nécessaire de l’extraire du modèle d’objet propriétaire de Pillow afin de la transformer en une entité manipulable par les opérateurs tensoriels de calcul vectoriel. La méthode contemporaine la plus élégante et efficiente pour accomplir cette passerelle consiste à employer la fonction numpy.asarray(). Contrairement à la fonction générique numpy.array(), qui procède systématiquement à une duplication défensive intégrale des blocs mémoires sous-jacents, numpy.asarray() cherche en priorité à créer une vue (view) matricielle indexée directement sur le tampon binaire continu déjà alloué par Pillow.
Ce mécanisme d’emprunt de mémoire sans copie superflue (zero-copy data sharing) procure des gains de performance substantiels, particulièrement lorsque les chaînes de traitement doivent ingérer en flux continu des flux d’images vidéo ou des tenseurs biomédicaux à très haute résolution spatiale. La structure matricielle résultante adopte instantanément le type de données approprié, généralement numpy.uint8 si l’objet Pillow était encodé sur 8 bits par canal, tout en préservant scrupuleusement l’intégrité numérique des valeurs d’origine.
Il demeure toutefois indispensable de vérifier la cohérence structurelle de cette transition. Le passage à NumPy permute immédiatement la hiérarchie des axes pour s’aligner sur la disposition matricielle : une image Pillow de dimensions (largeur=1920, hauteur=1080) en mode RGB devient instantanément un tableau NumPy de dimensions (1080, 1920, 3). L’accès aux coordonnées individuelles s’effectue dès lors au moyen des indices d’accès aux lignes et aux colonnes array[y, x]. Cette cohérence structurelle est le garant absolu de la validité des calculs matriciels ultérieurs, assurant qu’aucun glissement de perspective spatiale ne vienne fausser les analyses statistiques ou les algorithmes de filtrage spatial.
4. La conversion en niveaux de gris avec le mode ‘L’ de PIL
4.1 Signification technique et algorithmique du mode ‘L’ (Luminance)
L’opération centrale permettant de transformer une image couleur polymorphe en une représentation scalaire pure consiste à invoquer la méthode de conversion dédiée de Pillow, concrétisée par la ligne d’instruction image.convert('L'). Dans la nomenclature interne de la bibliothèque PIL/Pillow, le caractère unique 'L' fait directement référence au concept photométrique de Luminance. Cette opération réalise une réduction dimensionnelle irréversible en fusionnant les multiples canaux spectraux en une seule nappe scalaire d’échantillons d’intensité codés sur 8 bits non signés.
D’un point de vue algorithmique, chaque pixel individuel de l’image source — initialement défini par un vecteur trichromatique à trois composantes scalaires $(R, G, B)$ — est projeté sur un unique scalaire $Y$. Cette nouvelle grandeur numérique est ensuite contrainte dans l’intervalle entier fermé $[0, 255]$. La conséquence immédiate de cette conversion est l’anéantissement de l’information de chromaticité : les longueurs d’onde spécifiques émises par la scène sont définitivement éliminées au profit de la seule magnitude d’éclairement relatif.
Il est fondamental de comprendre pourquoi l’omission de cette étape précise de conversion empêche formellement la genèse d’une véritable matrice bidimensionnelle d’échelle de gris. Si un utilisateur tente d’extraire directement un tableau NumPy à partir d’un objet image couleur sans solliciter convert('L'), le tableau résultant conservera obstinément ses trois axes dimensionnels $(H, W, 3)$. Dès lors, comme nous l’avons explicité précédemment, toute tentative d’imposer un affichage monochrome au moyen d’arguments d’habillage graphique sera vouée à l’échec, le pipeline graphique de Matplotlib privilégiant la lecture matricielle directe des canaux spectraux par rapport à la colormap monochrome.
4.2 Formules de pondération photométrique (norme ITU-R BT.601)
La fusion des composantes rouge, verte et bleue en une valeur scalaire de luminance n’est pas le fruit d’une simple moyenne arithmétique non pondérée. Réaliser une conversion en appliquant la formule simpliste $(R + G + B) / 3$ constituerait une faute méthodologique majeure en imagerie numérique et en sciences de la vision. L’appareil visuel humain ne présente pas une sensibilité spectrale uniforme aux différentes longueurs d’onde du spectre visible : les cônes rétiniens de types L, M et S présentent des distributions spatiales et des rendements quantiques radicalement hétérogènes.
Pour refléter cette réalité neurophysiologique, Pillow implémente lors de l’appel à convert('L') la formule de pondération photométrique standardisée par le secteur des radiocommunications de l’Union Internationale des Télécommunications sous la désignation ITU-R Recommendation BT.601. Cette norme internationale stipule que la luminance $Y$ est calculée selon l’équation linéaire pondérée suivante :
$$Y = 0.299 \times R + 0.587 \times G + 0.114 \times B$$
Cette distribution asymétrique des coefficients — attribuant près de 59 % du poids total à la composante verte, 30 % à la composante rouge et seulement 11 % à la composante bleue — trouve sa justification évolutive et biologique dans la concentration prépondérante des récepteurs photopiques sensibles aux longueurs d’onde moyennes au sein de la fovéa humaine. Une scène dominée par un vert émeraude pur sera naturellement perçue par un observateur humain comme beaucoup plus lumineuse et éclatante qu’une scène d’intensité physique équivalente illuminée par un bleu profond ou un pourpre saturé. En appliquant rigoureusement les coefficients de la norme BT.601, la méthode convert('L') assure que les contrastes relatifs perçus dans la version en niveaux de gris reflètent fidèlement la hiérarchie perceptive originelle des contrastes de la scène polychrome.
4.3 Conséquences structurelles sur le tableau NumPy résultant
L’impact de la méthode convert('L') devient pleinement manifeste lorsque l’on procède à la projection du flux résultant vers un tableau NumPy à l’aide de np.asarray(image.convert('L')). La modification la plus déterminante concerne la topologie même du tenseur de données : l’opération élague définitivement le troisième axe orthogonal du tableau. Si la matrice couleur d’origine possédait une dimensionnalité d’ordre 3 caractérisée par une forme (hauteur, largeur, 3), la nouvelle matrice issue de la conversion acquiert une structure matricielle pure d’ordre 2, caractérisée par une forme canonique (hauteur, largeur).
Cette restructuration tensorielle entraîne une réduction immédiate et spectaculaire de l’empreinte de la matrice au sein de la mémoire vive du système. La taille en octets du tampon de pixels est rigoureusement divisée par trois, un avantage déterminant lorsque des protocoles expérimentaux imposent le pré-chargement en mémoire de banques volumineuses de plusieurs dizaines de milliers de stimuli photographiques avant le déclenchement des essais comportementaux chronométrés. L’optimisation des structures de données allège la charge sur le gestionnaire de mémoire de l’interpréteur Python et supprime les risques de micro-latences causées par le ramasse-miettes (garbage collector) durant la passation des sujets.
Enfin, cette perte du troisième axe dimensionnel est le déclencheur technique incontournable qui conditionne le comportement ultérieur de Matplotlib. En l’absence de canaux spectraux concurrents, la matrice (M, N) devient une description univoque et universelle d’un champ d’amplitudes scalaires réparties sur une grille géométrique. C’est précisément et uniquement cette structure bidimensionnelle pure qui rend possible l’application ciblée, paramétrée et déterministe d’une table de correspondance colorimétrique monochrome au sein du moteur imshow().
5. Mise en œuvre pratique : Affichage d’une image en niveaux de gris (Exemple pas-à-pas)
5.1 Code complet et exécution séquentielle détaillée
Afin de matérialiser l’ensemble de ces concepts théoriques au sein d’une implémentation concrète, analysons en détail le script de référence permettant de charger un fichier graphique, d’opérer la conversion en luminance matricielle et d’en assurer la restitution visuelle irréprochable sous la forme d’un tableau en niveaux de gris. Chaque instruction de cette séquence est conçue pour garantir une exécution robuste et sans équivoque.
Considérons la formulation séquentielle suivante :
Dans un premier temps, l’environnement logiciel requiert l’importation conjointe des modules matplotlib.pyplot, du module Image extrait du package PIL, ainsi que de la bibliothèque numpy. La séquence d’exécution débute par le chargement du fichier source à l’aide de la commande : image_pil = Image.open('stimulus_visuel.jpg'). À ce stade, comme nous l’avons explicité, les métadonnées sont lues, mais les pixels demeurent sous forme compressée sur le support de stockage.
L’étape suivante opère la dissociation chromatique et la projection en luminance pure : gray_pil = image_pil.convert('L'). Le moteur algorithmique applique ici la formule de pondération ITU-R BT.601 pixel par pixel. Une fois cette étape accomplie, la conversion matricielle sans duplication est matérialisée par l’instruction : gray_array = np.asarray(gray_pil). Un contrôle de routine sur gray_array.shape permet de vérifier que la forme correspond rigoureusement à deux dimensions scalaires (H, W) et que le type sous-jacent est bien uint8.
La finalisation graphique se concrétise alors par l’invocation explicite de l’interpréteur de traçage : plt.imshow(gray_array, cmap='gray'), immédiatement suivie par la commande de désactivation des repères spatiaux plt.axis('off') pour un rendu épuré, et enfin par plt.show() pour afficher la scène. Le moteur graphique génère la scène dans la fenêtre de rendu avec une exactitude photométrique optimale.
5.2 L’utilisation explicite du paramètre cmap=’gray’
L’attribution de la chaîne de caractères 'gray' au paramètre cmap (colloquialisme pour colormap) au sein de l’instruction plt.imshow() constitue la clef de voûte de toute cette procédure de visualisation. Le rôle de cet argument est de fournir une table de conversion formelle traduisant de manière strictement linéaire chaque valeur scalaire contenue dans la matrice NumPy vers un niveau d’intensité lumineuse achromatique sur l’écran.
Dans cette configuration spécifique, la table 'gray' associe à la valeur scalaire minimale (qui est 0 dans le cadre d’un tableau de type uint8) un quadruplet RGBA correspondant au noir absolu [0.0, 0.0, 0.0, 1.0]. Réciproquement, elle assigne à la valeur maximale admissible (255) le quadruplet associé au blanc spectral maximal [1.0, 1.0, 1.0, 1.0]. Pour l’ensemble des valeurs intermédiaires réparties entre ces deux bornes, la fonction applique une rampe affine continue où les trois canaux rouge, vert et bleu reçoivent des valeurs d’excitation identiques, garantissant une absence totale de saturation chromatique ou de dérive de teinte (hue) perceptible.
Il est fondamental de réitérer qu’en l’absence de ce paramètre explicite, l’affichage ne sera pas en niveaux de gris, quand bien même la matrice d’entrée serait structurellement bidimensionnelle. À l’inverse, si l’on tente d’appliquer cmap='gray' à un tableau qui n’a pas subi la conversion structurelle préalable et qui possède toujours ses trois canaux RGB, le paramètre sera totalement inopérant. L’affichage en niveaux de gris valide et reproductible est donc le fruit indissociable de la conjonction entre une matrice 2D pure et l’attribution explicite d’une colormap monochrome.
5.3 Comparaison visuelle entre l’image originale et le rendu désaturé
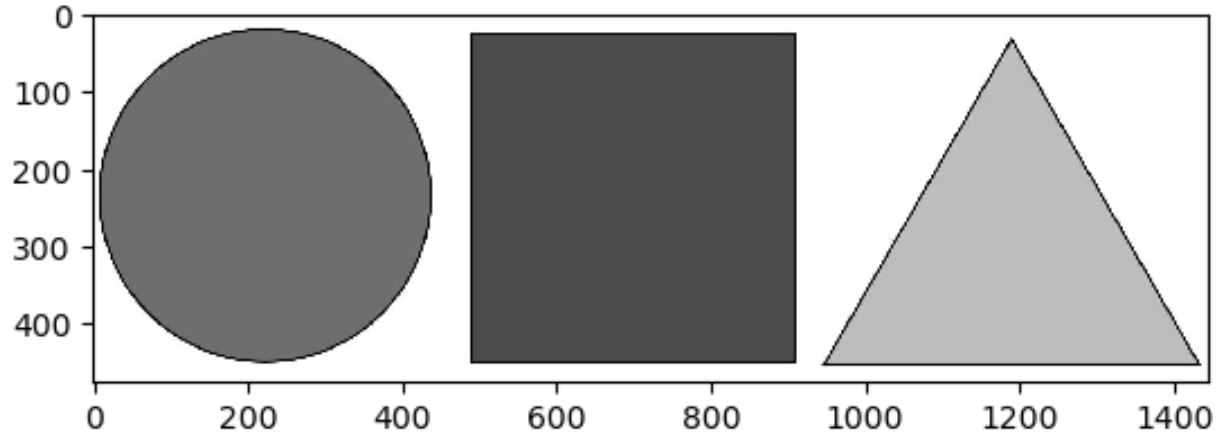
Pour valider la conformité d’une chaîne de prétraitement visuel dans le cadre d’une étude expérimentale, il est d’usage d’élaborer une interface graphique comparative juxtaposant l’image originale polychrome et sa contrepartie désaturée. Cette démarche permet de vérifier de visu que les structures spatiales d’intérêt, les frontières de textures et les gradients d’illumination sont demeurés intacts malgré la suppression totale de l’information de chromaticité.
L’implémentation de cette confrontation analytique s’opère couramment par le recours à la méthode plt.subplots(), générant une figure fragmentée en plusieurs sous-régions d’affichage (ou subplots). Considérons l’architecture de comparaison suivante :
- Création d’une figure partitionnée :
fig, axes = plt.subplots(1, 2, figsize=(12, 6)), instanciant un canevas horizontal composé de deux panneaux d’affichage indépendants. - Restitution de l’image trichrome originelle sur le premier axe :
axes[0].imshow(image_pil), avec adjonction d’un titre sémantiqueaxes[0].set_title('Stimulus Original (RGB)'). - Restitution de l’image projetée en luminance sur le second axe :
axes[1].imshow(gray_array, cmap='gray'), enrichie de son label méthodologiqueaxes[1].set_title('Luminance Normée (ITU-R BT.601)'). - Suppression conjointe des axes périphériques au moyen d’une itération contrôlée :
for ax in axes: ax.axis('off'), garantissant l’absence de biais géométriques périphériques.
Cette analyse visuelle comparative permet de constater avec précision la préservation absolue des contours morphologiques. Alors que les transitions de teintes (par exemple entre une fleur rouge et son feuillage vert d’intensité équivalente) perdent leur différenciation chromatique franche, leur séparation photométrique est fidèlement maintenue grâce au différentiel de pondération spectrale de la norme BT.601. Cette vérification qualitative constitue une étape préliminaire obligatoire pour valider la pertinence écologique d’un ensemble de stimuli avant leur déploiement dans des tâches comportementales de catégorisation rapide ou d’amorçage subliminal.
6. Pourquoi cmap=’gray’ est indispensable : Comprendre la colorisation par défaut
6.1 Le piège de la colormap par défaut (‘viridis’) sur un tableau 2D
L’un des comportements les plus déroutants pour les chercheurs abordant pour la première fois l’affichage de matrices bidimensionnelles dans Matplotlib réside dans l’apparition spontanée d’une image chatoyante aux nuances de jaune, de vert et de violet, alors même que le tableau de données sous-jacent est rigoureusement monochrome. Cette manifestation graphique, perçue à tort comme une anomalie du système, découle d’un choix de conception mûrement réfléchi par les développeurs de Matplotlib : l’application universelle de la table de correspondance colorimétrique par défaut, baptisée ‘viridis’.
Historiquement, jusqu’à la version 1.5 de Matplotlib, la palette appliquée par défaut à toute matrice scalaire dépourvue de spécification cmap était 'jet', une rampe arc-en-ciel interpolant brutalement du bleu au rouge en passant par le cyan et le jaune. Devant les vives critiques de la communauté scientifique dénonçant les artefacts de perception introduits par la non-linéarité sévère de 'jet', l’équipe centrale de Matplotlib a développé 'viridis'. Cette colormap a été mathématiquement optimisée pour offrir une progression perceptivement uniforme de la luminance tout en restant accessible aux personnes souffrant de déficiences de la vision des couleurs (daltonisme).
Cependant, lorsqu’un praticien transmet une matrice 2D issue de convert('L') sans spécifier de colormap, Matplotlib se trouve face à un champ scalaire pur sans instruction de restitution. Par fidélité à son contrat d’interface générique, il applique automatiquement 'viridis'. Le tableau de données d’origine, pourtant conçu pour représenter des niveaux d’intensité de gris, est alors transcodé à l’affichage en une topographie thermique artificielle : les valeurs d’intensité les plus faibles (les zones sombres) deviennent pourpres, les intensités médianes prennent une teinte émeraude, et les intensités les plus éclatantes culminent dans un jaune vif. Bien que le contenu informatif de la matrice n’ait subi aucune altération, la restitution visuelle finale est radicalement travestie.
6.2 Distinction critique entre structure matricielle et restitution visuelle
Ce comportement met en lumière une distinction ontologique fondamentale en science informatique et en traitement de données : la séparation absolue entre le modèle structurel de la donnée et sa projection phénoménologique sur un périphérique de sortie. Une matrice NumPy bidimensionnelle n’est fondamentalement rien d’autre qu’un arrangement géométrique régulier de grandeurs mathématiques numériques dans l’espace euclidien discret. Elle ne détient intrinsèquement aucune propriété de « couleur » ou de « gris » en dehors de la convention d’interprétation qui lui est appliquée.
La table de correspondance colorimétrique constitue un pont de projection arbitraire reliant l’espace des valeurs scalaires mathématiques à l’espace physique des émissions photoniques du moniteur. Le moteur de rastérisation de Matplotlib opère un découplage total entre ces deux domaines. L’utilisateur a toute latitude pour mapper une même et unique matrice (M, N) vers une infinité d’espaces visuels : une échelle achromatique linéaire continue (cmap='gray'), une échelle thermique divergente (cmap='coolwarm'), une cartographie topographique (cmap='terrain'), ou même une palette cyclique périodique (cmap='hsv').
Dans le cadre d’une démarche scientifique rigoureuse, il incombe donc au chercheur d’exercer un contrôle total et explicite sur chaque segment de ce pipeline de projection. Délaisser les paramètres de rendu au profit des comportements par défaut de l’interpréteur logiciel introduit une ambiguïté méthodologique majeure. La déclaration systématique de l’argument cmap='gray' ne constitue pas une simple redondance syntaxique, mais l’affirmation programmatique explicite de la convention de lecture photométrique assignée à la matrice d’intensité.
6.3 Impacts psycho-visuels d’une fausse colorisation dans les protocoles d’expérimentation
Dans le contexte spécifique de la recherche expérimentale en psychophysique et en neurosciences, l’introduction involontaire d’une colormap en fausses couleurs sur un stimulus monochrome induit des perturbations massives susceptibles de fausser intégralement les données empiriques recueillies. La première altération concerne l’introduction de frontières perceptives totalement illusoires. Même une palette optimisée comme 'viridis', bien que linéarisée en luminance globale, présente des transitions chromatiques qualitatives marquées (comme le basculement du bleu-violet vers le vert).
Ces transitions chromatiques brutales sont traitées de manière pré-attentionnelle par les voies visuelles parvocellulaires et koniocellulaires des observateurs humains, déclenchant des illusions de segmentation de figures (figure-ground segregation) qui n’existent aucunement dans les gradients de texture originaux du stimulus scalaire. Un sujet humain soumis à une tâche de discrimination de formes ou de détection de textures complexes verra son regard capté par les bandes de couleur artificielle, dégradant la fidélité de ses temps de réaction et introduisant des motifs d’exploration oculométrique artificiels.
Sur le plan déontologique et de l’intégrité scientifique, la publication de figures scientifiques utilisant des fausses couleurs non déclarées pour représenter des données d’intensité pure viole les principes fondamentaux de reproductibilité et de fidélité visuelle. Elle complique inutilement la lecture des tracés par les pairs et peut masquer ou exacerber artificiellement des artefacts de bruit spatial au sein des capteurs d’imagerie. La maîtrise absolue de l’attribution des colormaps scalaires achromatiques constitue ainsi un prérequis non négociable pour quiconque prétend concevoir des protocoles expérimentaux solides ou publier dans des revues académiques de premier rang.
7. Méthodes alternatives de conversion en niveaux de gris sous Python
7.1 Conversion manuelle via algèbre linéaire avec NumPy
Bien que l’utilisation du mode convert('L') de Pillow soit hautement recommandée pour sa commodité et son optimisation algorithmique native en C, il est tout à fait possible — et parfois conceptuellement préférable — d’opérer la conversion en niveaux de gris de manière strictement autonome au moyen des opérateurs d’algèbre linéaire de NumPy. Cette approche manuelle offre au chercheur une transparence mathématique absolue et un contrôle algorithmique total sur les constantes de pondération photométrique appliquées.
Pour accomplir cette opération vectorisée sur un tableau NumPy trichrome rgb_array de forme (H, W, 3), on applique un produit contracté (produit scalaire) le long du troisième axe dimensionnel avec un vecteur unitaire contenant les pondérations normalisées. Considérons la formule vectorielle implémentée comme suit :
On définit d’abord le vecteur de pondération selon les normes ITU-R BT.601 ou plus modernes : weights = np.array([0.299, 0.587, 0.114]). La réduction dimensionnelle s’effectue ensuite élégamment par l’intermédiaire de la méthode de produit scalaire : gray_manual = np.dot(rgb_array[..., :3], weights). L’utilisation de l’ellipse de découpage syntaxique ... combinée à la sélection :3 garantit que si l’image comporte un quatrième canal alpha accessoire, celui-ci est délibérément ignoré lors du calcul du produit matriciel.
Cette approche d’algèbre matricielle pure élimine toute dépendance externe envers la bibliothèque Pillow au sein des pipelines de calcul intensif. Elle s’avère particulièrement puissante lorsqu’il s’agit d’expérimenter des normes photométriques alternatives — par exemple la norme plus récente ITU-R BT.709 employée dans la vidéo haute définition moderne, dont les coefficients d’excitation spectrale s’établissent à 0.2126 pour le rouge, 0.7152 pour le vert et 0.0722 pour le bleu, reflétant la colorimétrie des moniteurs contemporains à large gamme spectrale.
7.2 Utilisation de scikit-image (rgb2gray) et normalisation flottante
Une autre alternative d’excellence au sein de l’écosystème Python scientifique réside dans l’utilisation de la bibliothèque de référence dédiée au traitement d’images : scikit-image (souvent abrégée skimage). Conçue dès l’origine pour s’interfacer de façon symbiotique avec les tableaux NumPy et l’écosystème SciPy, skimage propose le module spécialisé skimage.color, au sein duquel figure la fonction rgb2gray().
L’utilisation de cette fonction se distingue par une divergence conceptuelle capitale par rapport aux méthodes de Pillow : la mutation systématique du type de données et de l’intervalle de quantification dynamique. Lorsque l’on soumet un tableau numpy.uint8 de valeurs discrètes comprises entre 0 et 255 à l’instruction gray_float = rgb2gray(rgb_array), scikit-image ne renvoie pas un tableau d’entiers. Elle convertit instantanément la matrice vers le type à précision en virgule flottante double numpy.float64, tout en opérant une normalisation affine stricte bornée sur l’intervalle réel continu $[0.0, 1.0]$.
Ce basculement vers le domaine flottant procure des avantages analytiques majeurs pour les calculs de gradients fins, d’équations différentielles partielles de diffusion anisotrope ou d’analyses spectrales d’ondelettes, en prévenant les erreurs d’arrondi et les artefacts de quantification (banding) inhérents à l’arithmétique entière sur 8 bits. Cependant, cette conversion impose une vigilance accrue lors du rendu avec Matplotlib : comme nous l’avons précisé, plt.imshow(gray_float, cmap='gray') s’attendra désormais à des valeurs contenues entre 0.0 et 1.0. Toute opération mathématique intermédiaire qui repousserait les valeurs maximales au-delà de 1.0 imposerait un re-calibrage manuel strict des paramètres de saturation.
7.3 Approche avec OpenCV (cv2.cvtColor et cv2.COLOR_BGR2GRAY)
Dans les applications industrielles de vision artificielle, d’analyse vidéo en temps réel ou de traitement robotique de flux de caméras, la bibliothèque OpenCV (interfacée sous le module cv2 en Python) demeure le moteur le plus véloce, grâce à ses routines massivement parallélisées écrites en C/C++ et optimisées pour les architectures matérielles SIMD (SSE, AVX, NEON). La conversion vers l’échelle de gris s’effectue sous OpenCV par l’intermédiaire de la méthode cv2.cvtColor(), combinée au drapeau algorithmique cv2.COLOR_BGR2GRAY.
Cependant, l’intégration conjointe d’OpenCV et de Matplotlib recèle un piège topologique célèbre lié à l’ordre des canaux spectraux. Par héritage de choix historiques datant des premières cartes de numérisation vidéo analogiques, OpenCV ne charge pas les images matricielles selon la séquence standard rouge, vert, bleu (RGB), mais selon la séquence inversée bleu, vert, rouge (BGR). Par conséquent, si l’on applique directement des transformations de luminance sans tenir compte de cette inversion, les pondérations photométriques sont perverties : les coefficients du rouge et du bleu se trouvent malencontreusement permutés.
Dès lors, deux voies d’interfaçage s’offrent au praticien :
- Soit procéder à la conversion en niveaux de gris directement au sein d’OpenCV en informant le moteur de l’agencement BGR natif :
gray_cv2 = cv2.cvtColor(bgr_image, cv2.COLOR_BGR2GRAY). OpenCV appliquera alors la pondération BT.601 correcte en prenant soin d’associer le coefficient 0.114 au premier canal (bleu) et 0.299 au troisième (rouge). La matrice résultante(H, W)pourra ensuite être immédiatement visualisée dans Matplotlib viaplt.imshow(gray_cv2, cmap='gray'). - Soit rétablir au préalable la polarité standard RGB :
rgb_image = cv2.cvtColor(bgr_image, cv2.COLOR_BGR2RGB), avant de solliciter les modules de Pillow ou de scikit-image.
En termes d’efficience computationnelle pure, des analyses comparatives (benchmarks) démontrent qu’OpenCV surpasse Pillow d’environ 15 à 25 % sur des opérations de désaturation isolées, tandis que la solution d’algèbre matricielle pure via numpy.dot s’avère légèrement plus lente mais conserve l’immense avantage de ne réclamer aucune dépendance externe lourde en C/C++.
8. Maîtrise avancée des colormaps et normalisation de l’intensité
8.1 Les variantes de l’échelle de gris dans Matplotlib
La bibliothèque Matplotlib ne se cantonne pas à la seule table de correspondance 'gray' conventionnelle ; elle met à disposition des chercheurs une collection de palettes monochromatiques spécialisées adaptées à des contraintes méthodologiques ou instrumentales précises. La déclinaison la plus couramment sollicitée est l’échelle inversée, accessible au moyen du suffixe d’inversion syntaxique 'gray_r' (le r signifiant reversed). Sous cette modalité, la table de projection est rigoureusement inversée : la valeur d’intensité 0 est assignée au blanc spectral pur, tandis que la valeur maximale est projetée en noir d’encre absolu.
Cette inversion photométrique s’avère d’une utilité précieuse dans le domaine des sciences cognitives de la vision, notamment pour étudier l’effet de négatif photographique dans les paradigmes de reconnaissance de visages ou pour matérialiser des représentations de micro-densitométrie et de microscopie confocale où les structures biologiques d’intérêt sont conventionnellement documentées sous forme de dépôts opaques sur fond clair. D’autres variantes d’échelles achromatiques ou quasi-monochromes enrichissent le sous-système de visualisation :
- ‘binary’ : Une table strictement bichromatique, couramment exploitée pour la visualisation de masques de segmentation booléens ou de matrices de clairvoyance binaire, où chaque pixel est tranché sans gradient intermédiaire complexe.
- ‘bone’ : Une palette d’échelle de gris subtilement réchauffée par l’adjonction d’une très faible dominante bleuâtre dans les zones de basse intensité. Cette table imite les négatifs radiographiques conventionnels de l’imagerie médicale par rayons X et accroît la discriminabilité visuelle subjective des micro-fractures squelettiques.
- ‘gist_gray’ : Une variante développée par les laboratoires nationaux du département de l’Énergie américain, offrant une couverture dynamique légèrement plus agressive dans les transitions entre les ombres profondes et les hautes lumières.
Le tableau comparatif suivant synthétise les propriétés et contextes d’application de ces principales tables de correspondance monochromatiques disponibles nativement sous Matplotlib :
| Identifiant Matplotlib | Type de Progression | Plage Chromatique Associée | Domaines d’Application Préférentiels |
|---|---|---|---|
'gray' |
Linéaire continue | Noir absolu [0] vers Blanc pur [255] | Psychophysique standard, vision par ordinateur, imagerie générale. |
'gray_r' |
Linéaire inversée | Blanc pur [0] vers Noir absolu [255] | Étude du négatif photographique, microscopie, documentation d’encrage. |
'binary' |
Discrète ou linéaire stricte | Fond blanc opaque vers premier plan noir | Masques binaires, filtrages morphologiques, analyse de graphies. |
'bone' |
Monochrome enrichi | Noir vers cyan très doux puis blanc | Imagerie médicale, tomodensitométrie (CT scan), angiographie. |
8.2 Réglage de la dynamique de contraste avec les paramètres vmin et vmax
Par défaut, le moteur de rastérisation de plt.imshow() applique une normalisation dynamique automatique (dénommée autoscale) sur l’ensemble des données scalaires qu’il reçoit. Cela signifie que l’interpréteur parcourt l’intégralité de la matrice pour en identifier la valeur minimale absolue $x_{\min}$ et la valeur maximale $x_{\max}$. Il étire ensuite linéairement cette plage spécifique pour la faire coïncider avec les extrémités de la table de correspondance : $x_{\min}$ est forcé au noir et $x_{\max}$ est forcé au blanc.
Bien que cette disposition soit avantageuse pour examiner rapidement des données statistiques brutes dont la plage est inconnue, elle représente un danger méthodologique majeur lors de protocoles expérimentaux séquentiels. Imaginons un protocole de perception visuelle présentant successivement deux stimuli : l’un faiblement éclairé dont les intensités réelles s’étalent de 10 à 50, et l’autre vivement illuminé s’étalant de 200 à 240. Si le chercheur omet de contraindre l’étalonnage, Matplotlib étirera le premier stimulus de sorte que l’intensité 50 devienne un blanc aveuglant, et étirera le second de sorte que 200 devienne un noir profond. L’observateur humain sera ainsi exposé à deux scènes de contraste artificiellement maximisé, annihilant totalement la disparité d’illumination physique réelle que le protocole visait à tester.
Pour neutraliser ce biais et garantir le maintien d’une échelle absolue de luminance commune à travers l’ensemble des stimuli d’une série, il est impératif de verrouiller manuellement les bornes de normalisation au moyen des arguments vmin et vmax. L’instruction prendra alors la forme explicite suivante :
plt.imshow(gray_array, cmap='gray', vmin=0, vmax=255)
En fixant rigoureusement vmin=0 et vmax=255 pour des données au format uint8 (ou respectivement vmin=0.0 et vmax=1.0 pour des données normalisées en virgule flottante), le praticien s’assure que la table de projection ne subit aucune distorsion relative adaptative. Les scènes sombres conservent leur distribution spectrale ténébreuse, les scènes claires préservent leur brillance fovéale, et l’intégrité métrologique de la batterie de stimuli visuels est scrupuleusement préservée.
8.3 Histogrammes d’intensité et égalisation pour l’homogénéisation des stimuli
Au-delà du simple affichage géométrique de la matrice d’image, la caractérisation statistique fine de la distribution des intensités monochromatiques constitue une exigence fondamentale en vision computationnelle. Cette caractérisation s’opère par le traçage et l’analyse de l’histogramme des niveaux de gris. L’histogramme quantifie la densité de probabilité empirique d’apparition de chaque niveau d’éclairement au sein de la matrice. Matplotlib permet de générer ce diagnostic au moyen de la méthode de distribution matplotlib.pyplot.hist(), appliquée à la matrice aplatie en un vecteur unidimensionnel au moyen de la méthode ravel() :
plt.hist(gray_array.ravel(), bins=256, range=[0, 256], color='black', alpha=0.7)
L’observation de cette distribution empirique permet de révéler des déséquilibres photométriques chroniques au sein des bases de stimuli photographiques : regroupement excessif des fréquences dans les basses intensités (sous-exposition), saturation massive au niveau de la valeur 255 (surexposition ou clipping), ou encore confinement du signal dans un intervalle étroit (faible contraste spatial global). Dans les protocoles évaluant la vitesse de catégorisation visuelle ou la mémoire de reconnaissance, ces déséquilibres constituent des facteurs de confusion majeurs.
Pour remédier à cette variabilité non contrôlée, les chercheurs appliquent fréquemment des algorithmes d’égalisation d’histogramme (histogram equalization), disponibles notamment au sein du module skimage.exposure.equalize_hist. L’égalisation applique une fonction de transformation non linéaire monotone — fondée sur la fonction de distribution cumulative empirique des pixels — qui réalloue uniformément les intensités scalaires sur l’ensemble de la plage dynamique disponible. Le contraste spatial global du stimulus est ainsi mathématiquement maximisé, garantissant que chaque niveau d’intensité transporte une quantité équivalente d’information au sens de la théorie de Shannon et neutralisant l’avantage perceptif involontaire dont pourraient bénéficier certains stimuli naturels plus contrastés que d’autres.
9. Applications en psychophysique et perception visuelle
9.1 Contrôle rigoureux de la luminance et suppression des biais chromatiques
La recherche contemporaine en psychophysique de la vision humaine s’appuie sur une isolation méthodologique scrupuleuse des différents sous-systèmes sensoriels composant le traitement de l’information rétinotopique. L’un des postulats directeurs de cette discipline réside dans la séparation fonctionnelle précoce entre la détection spatio-temporelle de la forme et du mouvement (majoritairement prise en charge par le système magnocellulaire achromatique) et le décodage fin de la couleur et de la texture de surface (dévolu au système parvocellulaire). Dès lors, le recours à des stimuli rigoureusement calibrés en niveaux de gris s’impose pour quiconque souhaite étudier la cinématique visuelle ou l’intégration morphologique sans contamination chromatique.
Au-delà de la modularité anatomique des voies visuelles, la suppression des composantes spectrales permet de désactiver les réponses émotionnelles différentielles involontaires induites par certaines longueurs d’onde spécifiques. La littérature expérimentale a amplement documenté le fait que les tonalités de rouge saturé provoquent chez l’humain des élévations transitoires de l’éveil physiologique (arousal), modulant la conductance cutanée électrodermale, la fréquence cardiaque et raccourcissant artificiellement les temps de réaction de détection dans des tâches de discrimination simple. Convertir une base d’images en niveaux de gris permet d’annihiler ces interférences affectives incidentes et d’évaluer la réponse cognitive à la seule structure géométrique du stimulus.
Un autre défi réside dans les paradigmes expérimentaux de masquage visuel rétroactif (backward masking) ou de rivalité binoculaire. Dans ces protocoles, un stimulus cible doit être dissimulé ou mis en compétition perceptive avec un stimulus masque affiché quelques dizaines de millisecondes plus tard. Si la cible et le masque présentent des disparités de luminance globale moyenne, le système visuel précoce intègre ces écarts d’énergie lumineuse globale plutôt que les rapports de forme, générant des artefacts de persistance rétinienne. L’ajustement systématique de matrices d’intensité 2D dans Matplotlib, couplé à un étalonnage rigoureux de leur contraste photométrique, permet d’harmoniser parfaitement l’énergie de stimulation délivrée à l’œil du sujet.
9.2 Sensibilité au contraste spatial et motifs de réseaux de Gabor
Dans l’arsenal méthodologique de l’évaluation sensorielle de la vision humaine, les patchs ou réseaux de Gabor constituent les stimuli étalons par excellence. Un réseau de Gabor est une fonction mathématique bidimensionnelle combinant une onde sinusoïdale d’illumination spatiale (qui détermine la fréquence spatiale et l’orientation géométrique du motif) modulée par une enveloppe gaussienne bidimensionnelle d’atténuation radiale (qui confine le stimulus dans une fenêtre spatiale bornée). Ces motifs sont générés de façon purement synthétique en Python au moyen de formulations matricielles NumPy denses avant d’être visualisés avec Matplotlib.
L’intérêt neurobiologique majeur des réseaux de Gabor réside dans leur équivalence formelle avec la fonction de transfert spatio-fréquentielle des champs récepteurs des neurones simples découverts par David Hubel et Torsten Wiesel au sein du cortex visuel primaire (aire V1). Ces cellules corticales agissent véritablement comme des analyseurs d’ondes locales accordés sur des bandes étroites de fréquences spatiales (exprimées en cycles par degré d’angle visuel) et des orientations spécifiques dans l’espace rétinien. Pour mesurer la fonction de sensibilité au contraste spatial (Contrast Sensitivity Function ou CSF) chez un observateur, les chercheurs ajustent finement l’amplitude scalaire de la sinusoïde du réseau de Gabor en niveaux de gris.
Le pilotage d’un tel protocole requiert une exactitude irréprochable au sein du moteur d’affichage. Les matrices 2D modélisant les réseaux de Gabor doivent être converties en représentations flottantes, puis projetées à travers imshow() en fixant impérativement cmap='gray', avec un verrouillage symétrique des contrastes via vmin=-1.0 et vmax=1.0 (ou équivalent normalisé). La moindre altération géométrique introduite par une interpolation inadéquate ou la moindre dérive chromatique introduite par une colormap inappropriée dénaturerait la pureté spectrale du stimulus sinusoïdal, ruinant la validité écologique des mesures de seuils de perception psychophysiques.
9.3 Mesure des temps de réaction et perception des visages (Face Processing)
L’étude des processus cognitifs sous-tendant la reconnaissance des visages humains (face processing) constitue un domaine d’investigation où la standardisation rigoureuse des matrices en niveaux de gris a permis des percées théoriques capitales. Des banques de visages mondialement reconnues et partagées par la communauté scientifique — telles que la base NimStim ou le Karolinska Directed Emotional Faces (KDEF) — font systématiquement l’objet de pré-traitements drastiques visant à éliminer les signaux parasites. Dans ces cohortes photographiques, la pigmentation cutanée, le bronzage ou la teinte de l’iris constituent des indices superficiels que le chercheur doit neutraliser pour contraindre le sujet à mobiliser uniquement le traitement holistique ou structural de la configuration faciale.
Un phénomène classique et fascinant dans ce champ de recherche est l’effet de négatif photographique de la luminance. Lorsqu’un visage humain est présenté sous une forme inversée en niveaux de gris — obtenue instantanément dans Matplotlib en basculant de cmap='gray' à cmap='gray_r' —, les performances de reconnaissance par des sujets humains s’effondrent de manière spectaculaire, atteignant des taux d’erreur comparables à ceux observés lors de l’effet classique d’inversion géométrique de l’orientation spatiale du visage (face inversion effect). Étrangement, cette dégradation dramatique de la reconnaissance ne s’observe pas pour des objets artificiels ou des paysages naturels.
Ce phénomène s’explique par le fait que le système spécialisé de traitement facial, localisé dans l’aire fusiforme des visages (FFA), dépend de façon critique des relations ordinales de luminance dictées par l’illumination naturelle zénithale de notre environnement (le soleil ou les plafonniers illuminant de haut en bas). Dans un visage normal en niveaux de gris, la région des yeux et la zone sous-nasale apparaissent toujours plus sombres que le front et les pommettes. L’inversion par cmap='gray_r' inverse ces relations ordinales de contraste, rendant les zones orbitaires anormalement éclatantes et désamorçant instantanément les heuristiques de reconnaissance faciale pré-câblées du système cognitif.
10. Bonnes pratiques pour l’intégration et la publication scientifique
10.1 Suppression des artefacts périphériques : axes, graduations et bordures
Lorsqu’un chercheur génère une visualisation matricielle destinée à servir de matériel expérimental dans un logiciel de passation chronométrique (tel que PsychoPy ou OpenSesame), ou lorsqu’il élabore une figure d’illustration pour un manuscrit soumis à une revue scientifique à comité de lecture, la présence des éléments de repérage cartésien périphériques de Matplotlib constitue un artefact indésirable. Par défaut, plt.imshow() insère l’image au centre d’un graphique conventionnel doté d’une bordure rectangulaire noire (le cadre de l’axe), flanquée de graduations numériques (ticks) et de labels quantifiant les coordonnées des indices de pixels.
Ces éléments périphériques non pertinents altèrent le protocole : les graduations blanches et noires introduisent des signaux parasites de contraste spatial élevé sur la périphérie rétinienne du sujet, et les marges blanches asymétriques faussent le centrage géométrique précis du stimulus par rapport au point de fixation fovéal. Pour éradiquer ces artefacts, il est nécessaire d’appliquer une séquence de purification scénographique stricte :
- Désactivation intégrale des repères et bordures de l’axe actif :
plt.axis('off'). Cette directive supprime instantanément le cadre, les coches métriques et les annotations numériques. - Neutralisation des marges internes du conteneur de la figure :
fig.subplots_adjust(left=0, right=1, bottom=0, top=1), garantissant que la matrice d’image occupe 100 % de la surface spatiale de la vue graphique sans padding superflu. - Configuration de la boîte englobante lors de l’appel d’écriture disque :
plt.savefig('output.png', bbox_inches='tight', pad_inches=0). Cette clause ordonne au moteur de rastérisation de rogner impitoyablement tout espace blanc résiduel entourant les limites géométriques pures de la matrice.
L’application rigoureuse de ces instructions produit une image brute purifiée, parfaitement centrée et rigoureusement dépourvue d’éléments graphiques accessoires, répondant aux standards les plus exigeants de la psychométrie expérimentale.
10.2 Gestion de l’interpolation spatiale lors du redimensionnement d’affichage
Une dimension technique souvent méconnue du fonctionnement de plt.imshow() concerne la gestion de l’interpolation spatiale. Dès lors que la résolution matricielle de l’image source ne correspond pas exactement, au pixel près, à la résolution de la zone d’affichage allouée à l’écran (ou à la grille de points de l’impression papier), le moteur de Matplotlib doit obligatoirement opérer un ré-échantillonnage géométrique de la matrice d’intensité. Ce calcul est gouverné par le paramètre explicite interpolation.
Par défaut, Matplotlib applique un algorithme d’interpolation doux (souvent 'antialiased' ou 'bilinear'). Dans ce mode, chaque pixel d’affichage est le résultat d’une moyenne pondérée continue des pixels matriciels adjacents de l’image source. Si cette approche offre un rendu esthétiquement agréable pour des photographies naturelles en lissant les marches d’escalier géométriques, elle s’avère hautement préjudiciable lorsque le chercheur étudie des images de textures fines, des motifs à haute fréquence spatiale ou des stimuli à damiers discrets. L’anticrénelage émousse artificiellement les transitions nettes, introduisant des dégradés de luminance intermédiaire inexistants dans la matrice de données.
Dans les contextes où l’intégrité discrète de chaque cellule de pixel originelle doit être scrupuleusement préservée — par exemple lors de l’affichage de stimuli de très basse résolution agrandis pour des tests de vision fovéale versus périphérique —, il est formellement requis de forcer le mode d’interpolation au plus proche voisin :
plt.imshow(gray_array, cmap='gray', interpolation='nearest')
Ce paramétrage garantit que chaque point matriciel est reproduit sous la forme d’un bloc homogène d’intensité constante, sans le moindre filtrage passe-bas spatial ou flou gaussien incident. Pour les photographies continues à haute résolution où un lissage naturel des artefacts d’agrandissement est au contraire recherché, le recours aux modes d’interpolation d’ordre supérieur tels que interpolation='bicubic' ou interpolation='lanczos' demeure le choix privilégié pour préserver la fidélité des courbures et des textures complexes.
10.3 Exportation en haute résolution vectorielle et matricielle
La finalisation de visualisations en niveaux de gris destinées aux publications scientifiques au sein de revues internationales à fort facteur d’impact (par exemple éditées par Elsevier, Springer, Nature Publishing Group ou l’American Psychological Association) impose une conformité rigoureuse avec des critères éditoriaux drastiques en matière de résolution spatiale et de formats de compression. L’invocation informelle de la commande plt.savefig('figure.png') sans paramétrage approfondi produit le plus souvent un fichier d’une résolution par défaut de 100 DPI (points par pouce), ce qui est manifestement insuffisant pour l’impression typographique professionnelle.
Les recommandations typographiques académiques exigent généralement une résolution spatiale minimale de 300 DPI pour les photographies continues en demi-teintes ou en niveaux de gris, et fréquemment jusqu’à 600 ou 1200 DPI pour les schémas mixtes associant des matrices d’images et des tracés vectoriels annotés. Cette exigence est satisfaite dans Matplotlib par le calibrage du paramètre dpi :
plt.savefig('figure_haute_resolution.png', dpi=300, format='png')
Le choix du format de fichier d’exportation doit faire l’objet d’un arbitrage éclairé :
- PNG (Portable Network Graphics) : Format matriciel compressé sans perte d’information (lossless). C’est le standard de choix pour l’imagerie expérimentale, car il garantit que les valeurs numériques d’intensité lumineuse des pixels ne subissent aucune dégradation irréversible liée à des artefacts de quantification par blocs.
- TIFF (Tagged Image File Format) : Format professionnel largement plébiscité par les maisons d’édition scientifique et biomédicale. Il permet le stockage de données sur des profondeurs de bits étendues (16 ou 32 bits par canal) et intègre des métadonnées de calibration spatiale et instrumentale complètes.
- PDF / EPS (Formats Vectoriels) : Formats privilégiés pour la soumission d’articles. Bien que la matrice d’image sous-jacente demeure intrinsèquement rasterisée à la résolution DPI spécifiée, les axes, les textes typographiques, les barres d’échelle et les légendes associées sont conservés sous forme d’instructions vectorielles pures, garantissant une netteté de rendu absolue quel que soit le facteur d’agrandissement lors de la mise en page finale.
11. Dépannage et pièges fréquents lors de l’affichage en niveaux de gris
11.1 Erreur classique : Omission simultanée de convert(‘L’) et cmap=’gray’
L’une des sources de confusion les plus chroniques documentées sur les forums spécialisés de la communauté Python réside dans les deux états de panne asymétriques provoqués par l’omission conjointe ou disjointe des étapes de projection matricielle et de configuration de la colormap. Ces situations déroutantes se manifestent sous deux cas d’école symptomatiques :
Premier scénario pathologique : Le praticien invoque scrupuleusement la table de gris via plt.imshow(image, cmap='gray'), mais l’image affichée demeure résolument et impeccablement en couleurs naturelles. Ce diagnostic signale sans équivoque que la variable image n’a pas subi la conversion structurelle préalable et qu’elle conserve sa dimensionnalité tridimensionnelle (H, W, 3). Comme nous l’avons disséqué, face à trois canaux, le moteur graphique neutralise l’argument cmap sans avertir l’utilisateur et route les flux vers le décodeur RGB matériel direct.
Second scénario pathologique : Le praticien a rigoureusement converti son image avec convert('L') et dispose d’une matrice 2D irréprochable de dimensions (H, W), mais à l’écran, le stimulus apparaît dans des teintes criardes jaune fluo, turquoise et violet sombre. Ce diagnostic signale à l’inverse que l’utilisateur a omis d’ajouter l’argument explicite cmap='gray' au sein de imshow(). Matplotlib a alors appliqué sa colormap scalaire par défaut 'viridis' sur le tableau d’amplitudes bidimensionnel.
La règle d’or pour prévenir ces écueils consiste à graver dans sa pratique méthodologique le principe de la corrélation obligatoire : une matrice 2D pure exige impérativement une table de correspondance monochromatique explicite, et une table de correspondance monochromatique ne peut agir que sur une matrice strictement bidimensionnelle. Tout écart par rapport à ce couplage symbiotique induira inévitablement l’un de ces deux dysfonctionnements visuels.
11.2 Incohérences de typage de données et écrasement dynamique des échelles
Un deuxième piège récurrent découle de la manipulation informelle des types de données scalaires NumPy (dtypes) et de leurs conventions de normalisation sous-jacentes. Supposons qu’un chercheur applique un traitement de filtrage spatial sur une matrice d’image initialement encodée en numpy.uint8. Les fonctions de filtrage de SciPy ou les calculs de convolution NumPy convertissent souvent implicitement le tableau de sortie vers des réels flottants de type numpy.float64.
Si ce filtrage mathématique génère des valeurs qui demeurent dans l’ordre de grandeur de la plage d’origine — disons des valeurs comprises entre 0.0 et 255.0 — et que le chercheur transmet directement ce tableau flottant à imshow(gray_array, cmap='gray'), la visualisation sera intégralement détruite. Voyant un tableau de type flottant, Matplotlib applique sa convention standard pour les nombres réels : il s’attend à ce que le noir soit codé par 0.0 et le blanc absolu par 1.0. Par conséquent, l’ensemble des pixels matriciels dont la valeur excède 1.0 — c’est-à-dire la quasi-totalité de l’image — se retrouvent plafonnés et saturés (clipped) au blanc pur, produisant un rectangle blanc uni au sein duquel la structure du stimulus est totalement annihilée.
Pour prévenir ou diagnostiquer rapidement ces écrasements dynamiques dévastateurs, il est impératif d’intégrer des assertions de contrôle défensif au sein du code de traitement :
On vérifiera systématiquement les extremums statistiques au moyen des fonctions vectorielles : print(f"Type: {array.dtype}, Min: {array.min()}, Max: {array.max()}"). Si le tableau est flottant et s’étend jusqu’à 255, deux solutions structurelles s’imposent : soit normaliser mathématiquement les données sur l’intervalle unitaire via array_normalized = array / 255.0, soit forcer explicitement les bornes dynamiques de restitution au sein de l’affichage via plt.imshow(array, cmap='gray', vmin=0.0, vmax=255.0).
11.3 Conservation involontaire du canal de transparence (Alpha)
Le troisième piège technique le plus insidieux concerne le traitement accidentel d’images numériques codées sur 4 canaux, c’est-à-dire sous le format RGBA. De nombreux fichiers au format PNG générés par des logiciels de design graphique, des systèmes d’exploitation ou capturés depuis des flux web intègrent une couche alpha pour gérer les contours transparents, même lorsque l’illustration semble visuellement reposer sur un fond entièrement blanc uni ou noir uniforme.
Si l’opérateur tente d’extraire la luminance en convertissant superficiellement l’image sans purger cette composante de transparence, des anomalies algorithmiques complexes surgissent. Certaines méthodes de conversion simplistes projettent les 4 canaux en ignorant la nature mathématique divergente du canal alpha, conduisant à des aberrations où les zones transparentes de la périphérie du stimulus sont transcodées en noir profond ou en artefacts texturés granuleux en fonction des conventions d’interprétation de la valeur 0 d’opacité.
Pour éliminer définitivement ce risque lors de la manipulation de stimuli visuels rigoureux, la méthodologie la plus sûre consiste à opérer une fusion de transparence (alpha compositing) en amont, convertissant l’image vers un fond trichrome neutre et opaque avant toute projection en luminance :
Considérons l’algorithme suivant : si l’objet image présente un mode image_pil.mode == 'RGBA', on instancie une nappe de fond monochrome opaque de dimensions identiques au moyen de Pillow : background = Image.new('RGB', image_pil.size, (255, 255, 255)). On superpose ensuite l’image cible sur ce fond blanc en mobilisant le canal alpha comme masque de fusion géométrique via la commande : background.paste(image_pil, mask=image_pil.split()[3]). Une fois cette opération de synthèse géométrique achevée, le nouvel objet background — désormais garanti sans composante alpha résiduelle — peut être converti sans aucun risque vers le mode 'L' et projeté dans Matplotlib.
12. Synthèse et perspectives d’extension pour les études expérimentales
12.1 Récapitulatif du pipeline optimal de prétraitement et d’affichage
Au terme de cette exploration théorique et pratique approfondie, il convient de cristalliser les meilleures pratiques sous la forme d’un pipeline logiciel canonique, standardisé et hautement réutilisable. Ce gabarit modulaire a pour vocation d’être encapsulé au sein d’une fonction d’infrastructure scientifique au début de chaque projet de recherche, garantissant une reproductibilité sans faille des conditions de visualisation au sein des carnets de laboratoire interactifs Jupyter Notebooks ou des modules d’analyse expérimentale.
Considérons l’architecture de cette fonction de référence :
La fonction prend en argument le chemin d’accès au fichier ou l’objet matriciel source, ainsi qu’un booléen contrôlant l’affichage immédiat. Elle procède séquentiellement : 1) à l’ouverture sécurisée via le gestionnaire de contexte Pillow ; 2) à la détection et la fusion d’un éventuel canal alpha sur fond neutre étalonné ; 3) à la projection photométrique en luminance d’après la norme ITU-R BT.601 via l’instruction convert('L') ; 4) à l’instanciation de la vue matricielle NumPy bidimensionnelle (H, W) ; et enfin 5) au paramétrage rigoureux de l’objet AxesImage de Matplotlib associant la colormap explicite cmap='gray', l’étalonnage dynamique strict vmin=0, vmax=255, le contrôle de l’interpolation spatiale et l’extinction des repères d’axes périphériques.
L’adoption systématique d’une telle routine logicielle prémunit définitivement l’équipe de recherche contre l’apparition de fausses couleurs, élimine les disparités de contraste non désirées à travers les sessions de test et garantit que l’observateur humain ou l’algorithme d’apprentissage automatique aval travaille sur un signal scalaire pur, fidèle à la photométrie originelle de la scène d’acquisition.
12.2 Automatisation pour le traitement par lots de banques de stimuli
Dans la recherche empirique moderne, les protocoles expérimentaux reposent rarement sur la manipulation d’une image isolée. Ils mobilisent classiquement de volumineuses banques de stimuli comprenant des centaines, voire des milliers d’exemplaires photographiques devant faire l’objet d’une standardisation photométrique rigoureuse et uniforme. Dans ce cadre, la mise en place d’un pipeline de traitement automatisé par lots (batch processing) constitue un impératif d’efficacité méthodologique.
Ce processus s’articule généralement autour de scripts d’automatisation exploitant la bibliothèque standard pathlib de Python pour traverser récursivement l’arborescence des répertoires de données brutes. Pour chaque image identifiée, le script applique de manière automatisée la conversion en matrice de luminance 2D, calcule les moments statistiques d’ordre supérieur (la moyenne de luminance spatiale et la variance du contraste RMS), puis applique si nécessaire des opérations de filtrage fréquentiel dans le domaine spectral (filtrage passe-haut pour n’isoler que les hautes fréquences spatiales décrivant les arêtes, ou filtrage passe-bas pour ne conserver que les formes globales diffuses).
Les tenseurs 2D ainsi purifiés et normalisés sont ensuite sérialisés et exportés soit vers des formats matriciels standardisés non compressés, soit compilés sous forme d’archives de tenseurs compressés HDF5 ou de fichiers NumPy .npz. Ces banques de stimuli prêtes à l’emploi sont alors directement ingérées par les progiciels de passation psychophysique tels que PsychoPy, OpenSesame ou E-Prime, éliminant tout calcul de conversion redondant au moment critique de l’affichage en temps réel et garantissant une synchronisation temporelle rigoureuse à la milliseconde près sur le moniteur de laboratoire.
12.3 Évolution vers la calibration photométrique des moniteurs de laboratoire
Pour conclure cette étude sur l’affichage scientifique des niveaux de gris, il est fondamental de prendre conscience des limites physiques intrinsèques au sous-système logiciel. Même si le pipeline de données Python, Pillow, NumPy et Matplotlib s’avère parfait sur le plan mathématique et algorithmique, la restitution finale de l’intensité lumineuse demeure tributaire des propriétés optiques matérielles de l’écran de visualisation (qu’il s’agisse d’une dalle LCD à rétroéclairage LED, d’un moniteur OLED ou d’un écran cathodique CRT de laboratoire).
Les moniteurs grand public appliquent intrinsèquement une fonction de transfert non linéaire hautement agressive, historiquement désignée sous le terme de correction gamma ($\gamma \approx 2.2$). Cela implique que la relation entre la valeur numérique du pixel (le scalaire $x in [0, 255]$ géré par Matplotlib) et la luminance photonique physique réelle émise par les luminophores de l’écran ($L$ exprimée en cd/m²) n’est pas linéaire, mais suit une loi de puissance approximée par la relation physique $L propto x^\gamma$. Par conséquent, une valeur de pixel de 128 ne produit pas la moitié de la luminance d’un pixel de 255, mais à peine 20 à 25 % de l’intensité lumineuse totale admissible.
Dans les expériences de psychophysique rigoureuses mesurant des fonctions de sensibilité au contraste ou des seuils d’intégration temporelle, cette distorsion non linéaire matérielle est inacceptable. Elle impose d’étendre la chaîne méthodologique au-delà de Matplotlib en procédant à une calibration photométrique de l’écran à l’aide d’une sonde spectrophotométrique physique (telle qu’un colorimètre ou un spectrophotomètre de haute précision). Cette mesure instrumentale permet de caractériser la courbe de luminance réelle de l’écran et de générer une table d’inversion gamma (gamma look-up table ou gamma-LUT). En appliquant cette linéarisation en amont, le chercheur s’assure enfin que chaque incrément scalaire unitaire commandé au sein de sa matrice Python se traduit par un incrément d’illumination physique parfaitement proportionnel dans le monde réel, scellant ainsi l’alliance définitive entre rigueur algorithmique logicielle et métrologie physique absolue.
Références
- Brainard, D. H. (1997). The Psychophysics Toolbox. Spatial Vision, 10(4), 433–436. https://doi.org/10.1163/156856897X00357
- Campbell, F. W., & Robson, J. G. (1968). Application of Fourier analysis to the visibility of gratings. The Journal of Physiology, 197(3), 551–566. https://doi.org/10.1113/jphysiol.1968.sp008574
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., Wieser, E., Taylor, J., Berg, S., Smith, N. J., Kern, R., Picus, M., Hoyer, S., van Kerkwijk, M. H., Brett, M., Haldane, A., del Río, J. F., Wiebe, M., Peterson, P., … Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357–362. https://doi.org/10.1038/s41586-020-2649-2
- Hubel, D. H., & Wiesel, T. N. (1962). Receptive fields, binocular interaction and functional architecture in the cat’s visual cortex. The Journal of Physiology, 160(1), 106–154. https://doi.org/10.1113/jphysiol.1962.sp006837
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- International Telecommunication Union. (2011). Studio encoding parameters of digital television for standard 4:3 and wide-screen 16:9 aspect ratios (Recommendation ITU-R BT.601-7). International Telecommunication Union. https://www.itu.int/rec/R-REC-BT.601
- Itti, L., Koch, C., & Niebur, E. (1998). A model of saliency-based visual attention for rapid scene analysis. IEEE Transactions on Pattern Analysis and Machine Intelligence, 20(11), 1254–1259. https://doi.org/10.1109/34.730558
- Peirce, J., Gray, J. R., Simpson, S., MacAskill, M., Höchenberger, R., Sogo, H., Kastman, E., & Lindeløv, J. K. (2019). PsychoPy2: Experiments in behavior made easy. Behavior Research Methods, 51(1), 195–203. https://doi.org/10.3758/s13428-018-01193-y
- van der Walt, S., Colbert, S. C., & Varoquaux, G. (2011). The NumPy array: A structure for efficient numerical computation. Computing in Science & Engineering, 13(2), 22–30. https://doi.org/10.1109/MCSE.2011.37
- van der Walt, S., Schönberger, J. L., Nunez-Iglesias, J., Boulogne, F., Warner, J. D., Yager, N., Gouillart, E., & Yu, T. (2014). scikit-image: Image processing in Python. PeerJ, 2, e453. https://doi.org/10.7717/peerj.453
- Yin, R. K. (1969). Looking at upside-down faces. Journal of Experimental Psychology, 81(1), 141–145. https://doi.org/10.1037/h0027474